

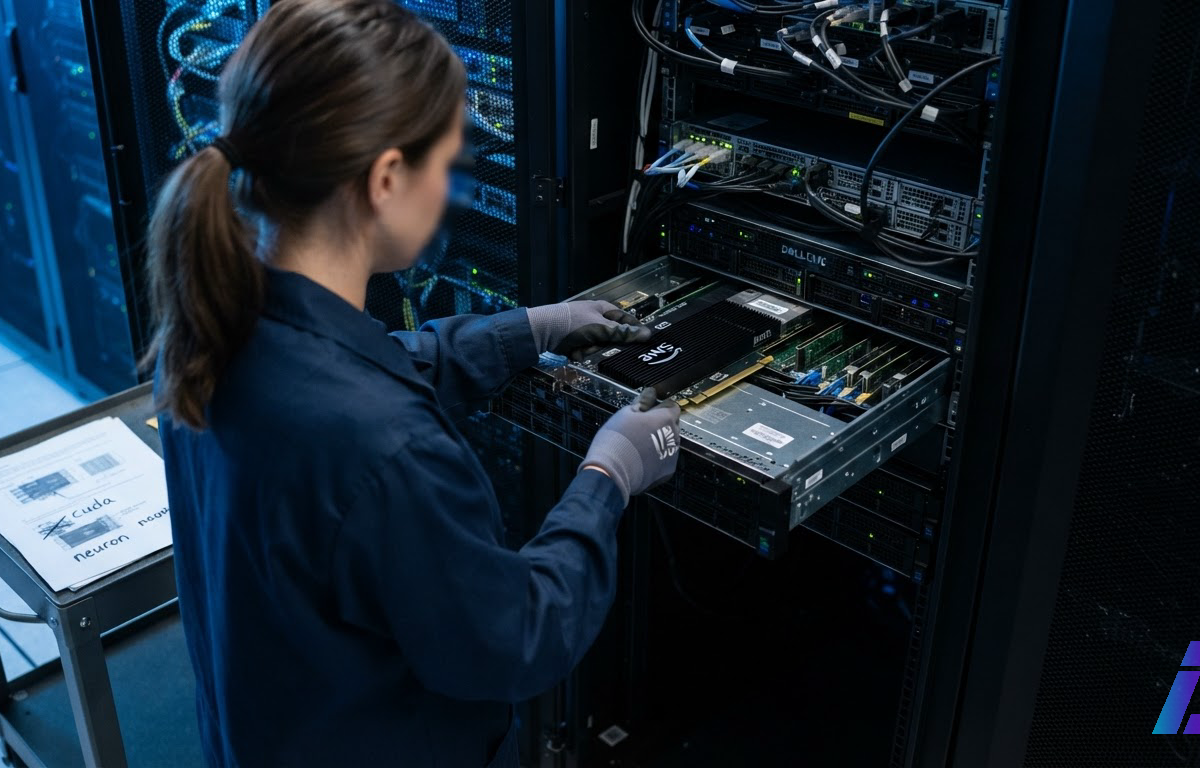
A Amazon abre nesta terça-feira, 20 de outubro, o código do TorchNeuron (abre em nova aba). O programa faz o Trainium, chip de inteligência artificial da própria empresa, ser reconhecido pelo PyTorch (abre em nova aba) como um dispositivo comum. O lançamento sai em beta público, sob a licença de código aberto Apache 2.0, durante a PyTorch Conference North America. A apresentação foi publicada na véspera no blog do PyTorch (abre em nova aba).
A promessa cabe numa linha de código. Um programa escrito para as placas da NVIDIA indica onde fazer as contas com a palavra "cuda". Para levá-lo ao Trainium, basta trocar "cuda" por "neuron". Se o código usa a interface genérica de aceleradores do PyTorch, a torch.accelerator, nem essa troca é necessária: segundo a documentação da AWS (abre em nova aba), ele roda sem mudança.
A Hugging Face (abre em nova aba) entrou no anúncio no mesmo dia. Segundo a empresa, suas bibliotecas Transformers, Diffusers e Kernels, usadas para baixar e rodar modelos abertos de texto e imagem, suportam o TorchNeuron de forma nativa. Junto veio uma recomendação: quem usa Trainium deve trabalhar direto com essas bibliotecas e deixar de lado o Optimum Neuron, adaptador que a própria Hugging Face mantinha para o chip.
O que travava o Trainium
Até aqui, rodar um modelo da Hugging Face no Trainium exigia um desvio. O Optimum Neuron se apoiava no pacote torch-neuronx, construído sobre o PyTorch XLA. A Hugging Face descreve o custo desse caminho sem rodeios. O modelo era montado inteiro antes de executar. As entradas precisavam ter tamanho fixo. E cada interrupção no fluxo forçava uma nova compilação.
Para medir a mudança, a empresa apresenta um número: com o TorchNeuron, 89% das 100 arquiteturas de geração de texto mais usadas funcionam sem ajuste, contra 46% com o Optimum Neuron na versão 0.4.5. É uma conta da própria Hugging Face, sem verificação externa, mas mostra onde estava o gargalo. O chip existia. Estreito era o caminho até ele. A Amazon atacou o problema certo.
O método também mudou. Em vez de um tradutor à parte, o TorchNeuron usa a porta de entrada que o PyTorch reserva para fabricantes de hardware, o mecanismo PrivateUse1. Com isso, o modelo pode ser executado passo a passo, como numa GPU, ou compilado com o torch.compile, a ferramenta padrão do PyTorch para acelerar código. O treino distribuído em vários chips usa as funções conhecidas: DDP, FSDP2, paralelismo de tensores e de pipeline. Do lado das imagens, a Hugging Face lista FLUX.1-dev, FLUX.2, Qwen-Image e Qwen-Image-2.1, entre outros, como geradores que podem ser divididos entre vários chips.
O detalhe técnico tem consequência prática. Segundo a AWS, Transformers, Diffusers, PEFT e Accelerate rodam no Trainium sem nenhum trecho de código específico para o chip. A conta oficial do PyTorch, mantida pelo projeto, fez questão de registrar que a integração entra pelos mesmos pontos de extensão criados pela comunidade, e não por um atalho próprio da Amazon:
Mais opções de hardware para desenvolvedores PyTorch: o TorchNeuron registra o Trainium da @awscloud como um dispositivo nativo, construído sobre os mesmos pontos de extensão que a comunidade criou para tornar o PyTorch independente de hardware. O código será aberto na PyTorch Conference, em 20 de outubro.
O que é preciso
O nome do pacote confunde. O torch-neuronx antigo, baseado em XLA, continua disponível nas versões anteriores à 2.14 como uma linhagem separada. A AWS recomenda o TorchNeuron para trabalhos novos. Quem roda no Trn1 ou no Inf2 fica, pelo que a documentação mostra, com o caminho antigo.
O "virtualmente" da Amazon
O comunicado da Amazon (abre em nova aba) diz que o código existente roda "com virtualmente nenhuma mudança". O advérbio carrega peso. As próprias documentações listam as exceções:
- Ao carregar um modelo com
device_map="auto", a opção automática do Transformers, o Trainium não é detectado e o modelo vai para o processador comum sem aviso. É preciso escreverdevice_map="neuron", segundo a documentação do Transformers (abre em nova aba). - No modo passo a passo, uma operação que ainda não tem versão para o chip roda no processador comum e emite um alerta. O programa não quebra, mas aquele pedaço do trabalho sai do hardware pelo qual se está pagando.
- O Trainium compila um grafo para cada tamanho de entrada que recebe, e cada compilação leva cerca de um minuto, segundo a documentação do TRL (abre em nova aba), biblioteca de treino da Hugging Face. Por isso, os lotes de texto são completados até um múltiplo de 128 tokens, e o recurso de formas dinâmicas do compilador do PyTorch precisa ser desligado.
- O carregamento assíncrono dos pesos do modelo não é suportado.
- O FP8, formato numérico de menor precisão, e a biblioteca TorchAO seguem em beta fechado. A liberação geral está prometida para a próxima versão.
Os documentos também não batem entre si em um ponto. A AWS aponta o vLLM Neuron como caminho para servir modelos. A documentação do TRL, por sua vez, informa que o vLLM não roda no Neuron e que, por isso, dois de seus métodos de treino por reforço, GRPO e RLOO, geram texto com o próprio Transformers.
Números, só os da casa
A Amazon diz testar o TorchNeuron contra centenas de milhares de modelos a cada nova versão. A Hugging Face relata ter rodado um ajuste fino em oito chips Trainium2, metade de uma instância trn2.48xlarge, e afirma que seus kernels otimizados aceleram modelos de visão em até 2,4 vezes no Trainium.
Na documentação do TRL, o modelo Qwen3-0.6B passa cerca de dois minutos compilando no primeiro passo. Depois disso, treina a 1,15 segundo por passo num único NeuronCore, contra 1,71 segundo sem compilação. Para dar escala: a instância trn2.3xlarge tem um chip Trainium2, com oito núcleos físicos agrupados por padrão em quatro NeuronCores lógicos.
Todos esses números vêm de quem vende o chip ou de quem se associou ao lançamento. Falta justamente a comparação que decide a compra: quanto custa e quão rápido roda o mesmo trabalho no Trainium e numa GPU da NVIDIA. Nenhum dos textos do lançamento traz essa conta, e nenhum teste independente foi apresentado junto. Os anúncios também não informam o preço por hora das instâncias nem em quais regiões da AWS elas estão disponíveis.
O que muda para quem usa
Para quem roda modelos da Hugging Face em GPUs na AWS, ficou mais barato experimentar o Trainium. Antes, testar o chip significava adaptar o código a outra biblioteca e conviver com restrições que deixavam mais da metade dos modelos de fora. Agora, segundo Amazon e Hugging Face, o teste começa com a troca de uma palavra e o ajuste do device_map.
O resto continua sendo decisão de planilha. O TorchNeuron está em beta, vale só para Trn2 e Trn3 e chega sem comparação pública de custo com a NVIDIA. Quem opera no Brasil precisa conferir no console da AWS se essas instâncias existem na região que usa, e quanto custam, antes de reservar uma hora de trabalho. Quem depende do Optimum Neuron já recebeu da própria Hugging Face o aviso de que o caminho recomendado mudou.