
A desenvolvedora StartLuxLabs apresentou a sua nova linha de modelos abertos batizada de StartLux-Decision. A família foi projetada para resolver problemas de escolhas e classificação, integrando leitura de imagens e uma ampla janela de processamento. A liberação inicial do sistema ocorreu em 30 de setembro de 2026, com atualizações adicionando suporte multimodal em 3 de outubro de 2026 e relatórios de desempenho publicados nos dias seguintes.
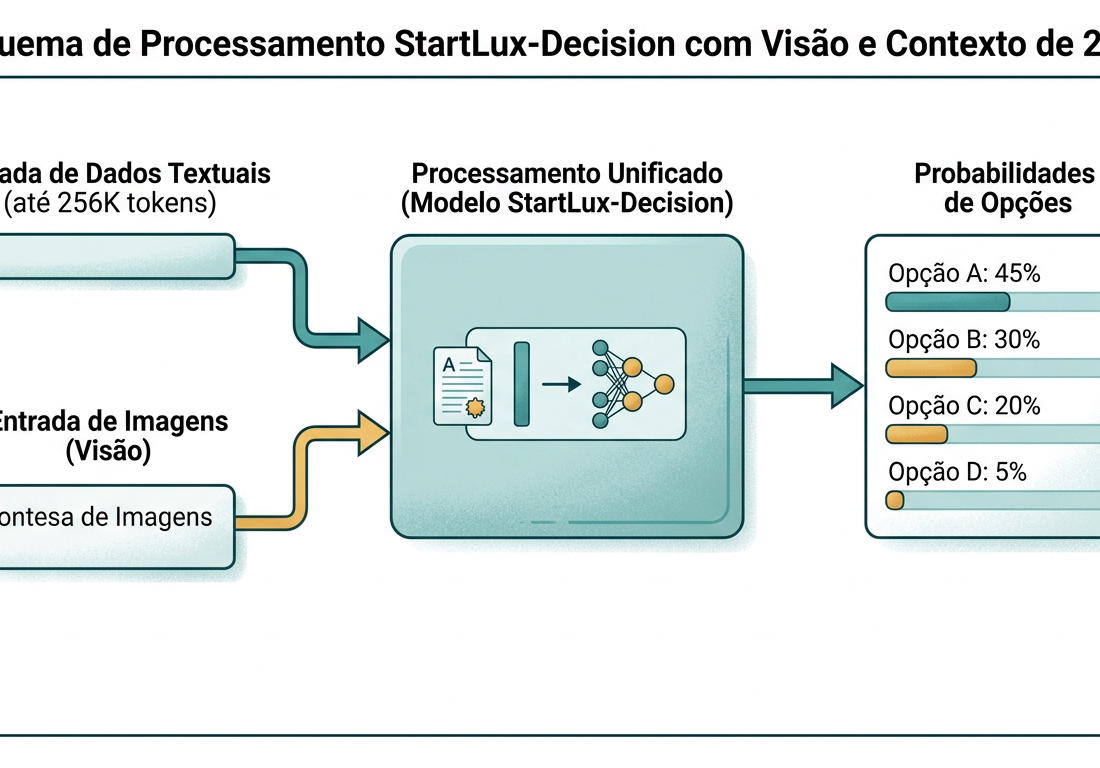
Diferente de sistemas convencionais de inteligência artificial generativa que escrevem parágrafos palavra por palavra, os modelos da família StartLux-Decision funcionam como juízes rápidos. Ao receber um conjunto de informações e uma pergunta, o sistema não gera texto longo. Em vez disso, ele realiza uma única passagem de processamento e calcula a probabilidade matemática de cada alternativa pré-definida, seja uma escolha múltipla, uma resposta afirmativa ou negativa, ou uma nota em escala. Essa probabilidade funciona como uma medida direta de confiança na resposta.
Tamanhos e variantes de arquitetura
A família foi construída em duas frentes de arquitetura: modelos densos e modelos do tipo mistura de especialistas, conhecido tecnicamente como MoE (Mixture of Experts). Em um modelo denso, todos os parâmetros da rede neural são ativados a cada operação. Já na mistura de especialistas, o sistema divide o trabalho entre sub-redes especializadas, ativando apenas uma fração delas conforme a necessidade, o que economiza processamento.
A linha conta com seis configurações no total:
- Cinco variantes densas: 0.8B (aproximadamente 0,9 bilhão de parâmetros), 2B, 4B (cerca de 5 bilhões), 9B (cerca de 10 bilhões) e 27B (cerca de 28 bilhões).
- Uma variante com mistura de especialistas: 35B-A3B (cerca de 36 bilhões de parâmetros totais).
Para viabilizar a execução em computadores locais com menor capacidade de memória, as opções densas também contam com quantizações no formato GGUF, como Q8_0 e Q4_K_M, além da precisão padrão BF16. Quantização é o processo que reduz o peso numérico das variáveis de um modelo, permitindo que ele rode consumindo menos memória do sistema.
Multimodalidade e janela de contexto estendida
A capacidade multimodal significa que o modelo consegue interpretar mais de um tipo de dado ao mesmo tempo. No caso do StartLux-Decision, a entrada pode ser composta de textos puros, estruturas em JSON ou imagens visuais diretas, tudo servindo como evidência para a tomada de decisão.
Outro ponto de destaque é o tamanho da janela de contexto. O contexto representa a quantidade de informação que o modelo consegue reter na memória de trabalho em uma única consulta. Todas as variantes da família StartLux-Decision aceitam até 262.144 tokens (o equivalente a 256K). Na prática, um token corresponde a pedaços de palavras ou caracteres processados pela máquina; uma janela de 256K permite enviar volumes de dados equivalentes a livros inteiros ou coleções volumosas de imagens e relatórios analíticos de uma só vez.
Por utilizar a estrutura de chamadas TypeSafe /v1/systemone, os modelos conseguem substituir diretamente aplicações preparadas para ferramentas predecessoras, mantendo compatibilidade direta de código.
Resultados e comparações nos testes
Nas avaliações do índice independente Decision Index versão 0.2.1, medidas em placas aceleradoras H200 entre 27 de setembro e 1 de outubro de 2026, o modelo StartLux-Decision-27B alcançou a pontuação geral de 63,88 pontos. Em comparação com o modelo Jev 1.13, que liderava a tabela pública em 28 de setembro de 2026 com 57,91 pontos, a variante de 27 bilhões de parâmetros superou a marca por uma diferença de 5,97 pontos.
Além da pontuação agregada, o modelo superou o Jev 1.13 em 31 dos 38 testes individuais que compõem o índice. Avaliações conduzidas no conjunto de sete testes aplicado originalmente pelo Laboratório de Inteligência Artificial de Xangai apontaram uma taxa média de acerto de 91,82% para a versão 27B, enquanto o Jev registrou 88,74%.
| Modelo | Pontuação Geral (DI 0.2.1) | Conhecimento | Linguagem | Recuperação e Classificação | Ferramentas | Artes e Preferências |
|---|---|---|---|---|---|---|
| StartLux-Decision-27B | 63,88 | 44,3 | 74,5 | 66,8 | 82,2 | 47,9 |
| StartLux-Decision-35B-A3B | 61,55 | 42,4 | 73,6 | 65,8 | 76,2 | 44,7 |
| StartLux-Decision-9B | 58,63 | 38,0 | 71,3 | 64,1 | 73,2 | 41,8 |
| StartLux-Decision-4B | 52,75 | 32,1 | 63,9 | 56,7 | 72,3 | 33,7 |
| Jev 1.13 | 57,91 | 51,4 | 62,0 | 55,4 | 75,1 | 37,7 |
Em velocidade de execução, o processamento de três perguntas curtas registrou tempos de 12,2 milissegundos na versão 0.8B, 15,5 milissegundos na 2B, 26 milissegundos na 4B, 35,7 milissegundos na 9B e 102,3 milissegundos na 27B.
A própria equipe responsável pelo desenvolvimento esclareceu que as medições foram realizadas internamente por meio das ferramentas de teste do próprio índice, mantendo a distinção em relação às entradas ranqueadas oficialmente.
No Decision Index 0.2.1, nossas avaliações colocam o StartLux-Decision-27B em 63,88 e o StartLux-Decision-9B em 58,63. Ambos superam a pontuação de 57,91 do Jev 1.13 na tabela pública de classificação em 28 de setembro de 2026. Avaliamos o conjunto completo usando o próprio kit de ferramentas do benchmark. Nossos resultados são autorreportados, não entradas oficiais na tabela de classificação.
Disponibilidade dos arquivos e plataformas
O repositório do projeto, contendo scripts de inferência, registros brutos e rotinas de avaliação, foi disponibilizado no GitHub (abre em nova aba). Os pesos treinados dos modelos foram distribuídos publicamente na coleção da plataforma Hugging Face (abre em nova aba) e também no serviço ModelScope, sob a identificação da organização StartLuxAI, permitindo que desenvolvedores integrem os sistemas de decisão em seus próprios fluxos de software.