
Em análise técnica publicada em 29 de setembro de 2026, o pesquisador Sebastian Raschka examinou a evolução histórica e prática dos modelos de inteligência artificial voltados para a classificação de texto. O trabalho revisita desde os primeiros métodos tradicionais até sistemas modernos como os grandes modelos de linguagem e a recente solução Jev, lançada duas semanas antes da publicação do artigo. O estudo busca situar o papel dessas ferramentas no cotidiano da computação, explicando como algoritmos aprendem a rotular conteúdos e direcionar decisões.
A tarefa de classificação de texto consiste em pegar uma mensagem escrita em linguagem livre e atribuir a ela uma etiqueta específica. Essa operação funciona de forma parecida com a triagem de correspondências em uma agência postal: cada carta é analisada brevemente para determinar se deve ir para o departamento financeiro, comercial ou para a caixa de descarte. No mundo digital, a técnica viabiliza serviços rotineiros, incluindo a separação de mensagens legítimas daquelas indesejadas na caixa de entrada e a divisão de notícias por editorias temáticas.
Segundo a retrospectiva conduzida por Raschka, antes do predomínio das arquiteturas atuais, o método dominante era a representação conhecida como saco de palavras, ou bag-of-words. Esse formato foi a base do trabalho acadêmico do próprio pesquisador quando atuava como estudante de pós-graduação há 15 anos. Naquela época, o formato viabilizou soluções aplicadas amplamente, incluindo alegações históricas de que até mesmo o filtro inicial de spam do Gmail utilizava o classificador Naive Bayes estruturado sobre essa abordagem.
O princípio do saco de palavras consiste em transformar textos de comprimentos variados em um vetor de tamanho fixo, ou seja, uma lista padronizada de números que os algoritmos conseguem interpretar. Em termos simples, imagine desmontar uma frase inteira e colocar cada palavra dentro de uma sacola plástica, ignorando a ordem gramatical original e contando quantas vezes cada termo aparece. Esse vetor numérico resultante alimenta modelos matemáticos clássicos, tais como:
- Naive Bayes, algoritmo probabilístico rápido para estimar categorias com base na frequência das palavras;
- Regressão Logística, técnica estatística que calcula as chances de uma entrada pertencer a um grupo específico;
- Máquinas de Vetores de Suporte (SVMs), que buscam traçar linhas divisórias ótimas entre classes diferentes;
- Random Forest e XGBoost, comitês de árvores de decisão que combinam múltiplos cálculos para evitar erros individuais.
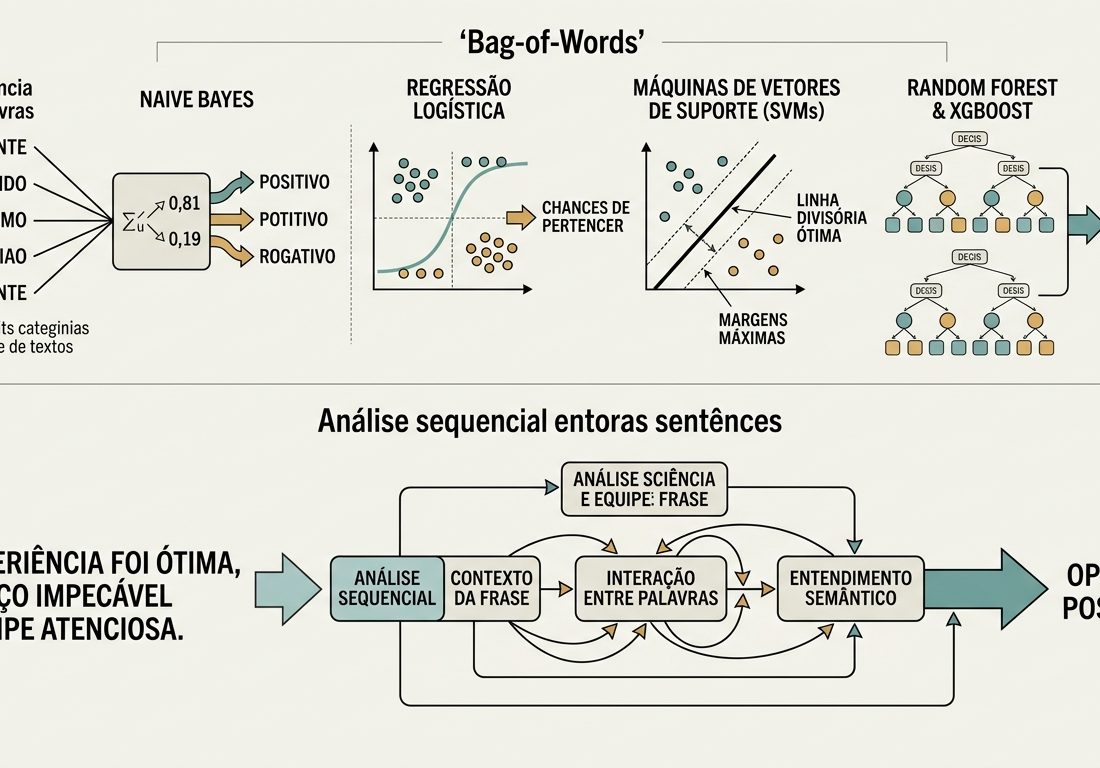
Embora redes neurais recorrentes (conhecidas pela sigla RNNs) já existissem há mais de uma década, a facilidade de implementação do saco de palavras garantia resultados consistentes em bases de dados de tamanho intermediário. Com o avanço do aprendizado profundo, redes neurais convolucionais (CNNs) e redes recorrentes passaram a capturar melhor as sequências temporais dos textos. Mais recentemente, a chegada das arquiteturas baseadas em Transformers e nos modelos de linguagem de grande porte (LLMs), como a família GPT e modelos com pesos abertos, estabeleceu novos patamares de capacidade geral.
O artigo aborda o impacto de lançamentos recentes, destacando o modelo Jev, que se tornou um fenômeno cultural em comunidades especializadas ao longo de setembro de 2026. A avaliação inicial do autor sobre o sistema transitou de um ceticismo de que seria apenas mais um classificador comum facilmente reproduzível para o reconhecimento de sua eficiência prática. Sebastian Raschka esclarece não possuir afiliação institucional com os criadores do Jev, tampouco acesso gratuito ou interesse comercial em endossar o produto, tratando o assunto sob ótica exclusivamente analítica.
Na comparação entre ferramentas, os grandes modelos de fronteira oferecem versatilidade superior para tomada de decisões abrangentes. Por outro lado, soluções como o Jev realizam tarefas de classificação de modo mais rápido e com menor custo financeiro. Quando o cenário envolve um problema fechado, altamente especializado e com regras rígidas, modelos construídos sob medida ainda superam as opções gerais em velocidade, custo e precisão. O diferencial de sistemas recentes está em entregar flexibilidade superior à dos classificadores restritos, sem a complexidade operacional exigida pelos modelos de fronteira mais pesados.
A escolha de uma tecnologia para classificar textos depende dos objetivos de custo, do tempo de resposta aceitável e da complexidade da triagem. Entender a evolução histórica permite identificar que abordagens clássicas e modelos contemporâneos continuam desempenhando papéis complementares no processamento de linguagem natural.