
Grandes modelos de linguagem, conhecidos pela sigla em inglês LLMs, tornaram-se ferramentas populares para redigir documentos, sintetizar artigos e responder a dúvidas complexas. No entanto, esses sistemas ainda enfrentam dificuldades quando recebem instruções detalhadas que contêm regras bem específicas. Para solucionar essa limitação, os pesquisadores Bosi Wen, Yilin Niu, Xiaoying Ning, Ying Zhang, Hongning Wang e Minlie Huang apresentaram em 26 de setembro de 2026 o ScopeIF (abre em nova aba), uma nova estrutura de treinamento projetada para aprimorar o seguimento rigoroso de instruções delimitadas por partes do texto.
Na prática pedagógica, quando um professor pede uma redação com introdução curta e parágrafos centrais longos, ele avalia se cada pedaço do trabalho cumpriu a sua meta particular. Em sistemas convencionais de inteligência artificial, o processo costuma falhar porque o treinamento tradicional enxerga o texto inteiro de maneira uniforme ou apenas confere um resultado binário de certo ou errado para a regra, ignorando a gravidade do erro e o local exato onde ele ocorreu.
Restrições globais versus regras de escopo específico
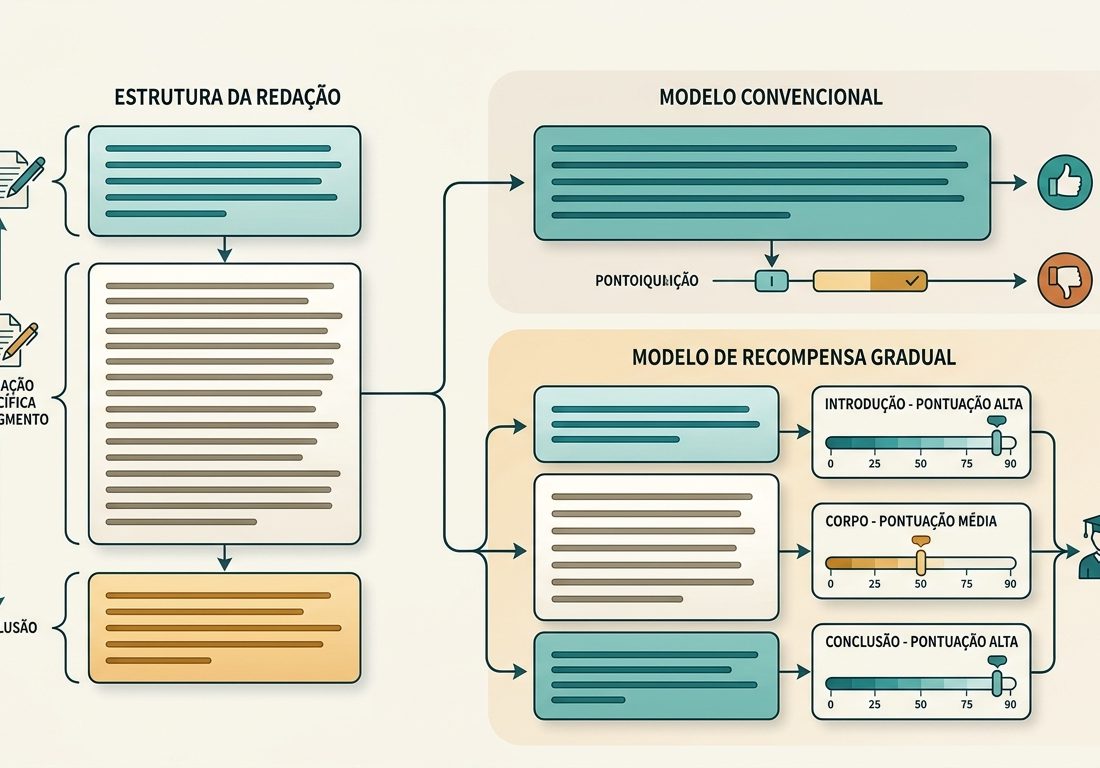
Para compreender o problema resolvido pelo estudo, é importante diferenciar dois tipos de exigências feitas aos computadores: as restrições globais e as restrições com escopo específico. Uma restrição global dita o comportamento de todo o texto produzido. Por exemplo, solicitar que uma resposta inteira não ultrapasse quinhentas palavras é uma regra global, pois afeta a totalidade da saída.
Por outro lado, restrições com escopos específicos governam apenas segmentos determinados da resposta. Um exemplo simples do cotidiano seria pedir para um assistente redigir três parágrafos, exigindo que apenas o segundo parágrafo contenha exatamente duas frases curtas, mantendo o restante livre. Os autores observaram que os métodos de otimização existentes costumam negligenciar essa divisão durante a criação de dados, aplicando recompensas genéricas para a resposta como um todo.
Como funciona a modelagem de recompensas graduadas
O ScopeIF propõe uma solução estruturada em etapas. Primeiro, os pesquisadores criaram um esquema unificado que divide as restrições objetivas em três dimensões separadas: o escopo (Scope), o alvo (Target) e o intervalo ou alcance (Range). Na categorização detalhada do formato de dados, o alvo também pode ser dividido entre primário e secundário.
Com essa divisão em mãos, o projeto gerou uma base com milhares de exemplos chamada ScopeInstruct, construída em três etapas. Em vez de simplesmente atribuir notas binárias, como zero para quem errou e um para quem acertou, a equipe introduziu a modelagem de recompensas graduadas (Graded Reward Modeling), combinada com ferramentas de verificação.
A modelagem de recompensas graduadas funciona de modo semelhante a um corretor que desconta pontos parciais: ela quantifica o grau exato em que uma regra foi violada em seu escopo correspondente. Se o modelo de inteligência artificial ultrapassar um limite por uma palavra, a penalidade é pequena; se ultrapassar por vinte, a pontuação cai proporcionalmente. Essa abordagem oferece uma supervisão muito mais rica e densa para orientar o algoritmo de aprendizado por reforço.
Principais resultados e ganhos de precisão
Os testes detalhados na publicação demonstraram que o ScopeIF superou de forma consistente os métodos anteriores, atingindo avanços consideráveis justamente nas instruções com escopos complexos, sem prejudicar a capacidade de resposta geral dos modelos.
Para validar a eficácia, os cientistas aplicaram a abordagem em versões otimizadas dos modelos abertos Qwen3 de 4 bilhões e 8 bilhões de parâmetros. Segundo as avaliações do estudo, esses modelos menores conseguiram igualar ou até superar sistemas de fronteira de grande porte, entre eles o Gemini-2.5-Pro e o DeepSeek-V3.2, no cumprimento de regras precisas com escopo delimitado.
Próximos passos e recursos abertos
Os responsáveis pelo trabalho disponibilizaram a base de instruções e os códigos de execução no repositório público do ScopeIF no GitHub (abre em nova aba). O conjunto de dados liberado inclui 16.968 instruções no arquivo de treinamento e 1.000 instruções no arquivo de teste, além do ambiente para condução do treino por reforço e da plataforma de avaliação ScopeIF-Test. Com isso, outros pesquisadores e desenvolvedores podem utilizar o material para treinar modelos capazes de entender comandos cada vez mais detalhados e estruturados.