

Na sexta-feira (30), quatro empresas que disputam cada centímetro do mercado de inteligência artificial concordaram em uma coisa. OpenAI (abre em nova aba), Google (abre em nova aba), Microsoft (abre em nova aba) e Anthropic (abre em nova aba) vão aceitar um sinal único com o qual o dono de um site avisa que não quer ver seu conteúdo usado no treino de modelos de IA. Uma linha basta para quatro destinatários. É um avanço de conveniência, mas ainda não é uma garantia.
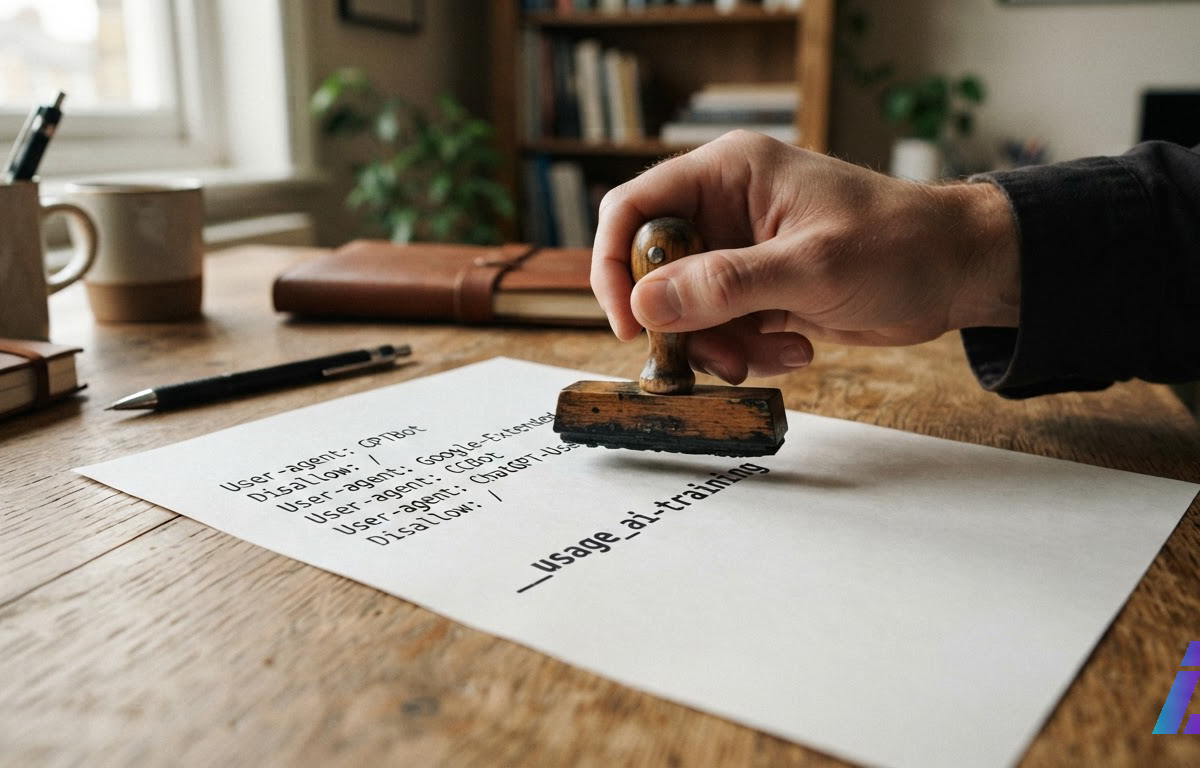
Para medir o tamanho da novidade, convém olhar a porta dos sites. Quase todos têm um arquivo de texto chamado robots.txt, uma espécie de aviso na entrada que diz aos robôs da internet onde podem circular. Ele serviu durante anos para orientar os buscadores e acabou virando a principal barreira contra a raspagem, a coleta automática de textos que alimenta os modelos. O problema é que cada empresa manda o próprio robô, cada um com seu nome: o GPTBot da OpenAI, o Google-Extended do Google e assim por diante. Quem quer recusar o treino precisa anotá-los um por um. Se uma empresa usa vários coletores, cada coletor exige sua própria linha, e a lista engorda a cada empresa nova que aparece.
A proposta troca a lista por um carimbo, chamado __usage_ai-training. Quem o apresentou à Internet Engineering Task Force (abre em nova aba) (IETF), a entidade sem fins lucrativos que mantém as regras do robots.txt, foi Kevin Kelley, responsável técnico por padrões na Anthropic. As quatro empresas dizem que seus robôs vão se afastar do site quando encontrarem o carimbo. Vale registrar o detalhe: a regra que limita os coletores foi redigida dentro de uma das casas que coletam. E, por enquanto, ela é apenas um rascunho individual, não um padrão aprovado pela IETF.
O calendário pede paciência. A Anthropic diz que já começou a aplicar o sinal, e a OpenAI promete fazê-lo "nos próximos meses". Segundo a agência AFP, a Microsoft marcou o início para 1º de fevereiro de 2027. O Google fala apenas em algum momento de 2027. Na prática, durante boa parte do ano que vem o "não" único valerá integralmente para uma empresa só.
A letra miúda está no blog da Microsoft. O sinal vale apenas para treinamentos futuros e não impede que os robôs continuem visitando as páginas para outras finalidades. A regra de partida, além disso, é a permissão: a coleta segue liberada até que o dono do site mude a configuração. Quem nunca ouviu falar do carimbo continua dizendo "sim" sem ter aberto a boca. A recusa também não alcança modelos que, segundo a SiliconANGLE, "executam tarefas exclusivamente não generativas", isto é, que não produzem texto ou imagem. E o que já foi raspado não volta.
Há ainda um pedágio. Microsoft e Google avisaram, em comunicados separados, que recusar o treino pode reduzir as chances de o conteúdo aparecer em aplicativos e respostas de IA. A Microsoft garante que o site continuará nos resultados do Bing e oferecerá um controle a mais, para o chamado grounding. É o caso em que o assistente consulta uma página na hora, para responder à pergunta de um usuário, em vez de guardá-la para treino. Esse bloqueio valerá também para ferramentas de terceiros que usam tecnologia da Microsoft. A OpenAI pretende oferecer algo parecido, chama a iniciativa de voluntária e diz que os bloqueios atuais, robô por robô, continuarão funcionando.
O gesto não caiu do céu. Em dezembro de 2023, o New York Times processou OpenAI e Microsoft, acusando-as de usar milhões de reportagens sem autorização nem pagamento para treinar o ChatGPT. As duas se defendem com a doutrina americana do uso justo, o fair use. O mercado, enquanto isso, andou sozinho. Desde julho de 2025, a Cloudflare (abre em nova aba) bloqueia por padrão os robôs de IA nos sites de novos clientes, e um padrão chamado Really Simple Licensing (RSL) já permite cobrar dos coletores pela visita. Diante disso, as quatro chegam com a opção mais modesta da prateleira: um pedido educado, cuja força depende de quem o recebe.
Faltou uma cadeira à mesa. Andy Stone, porta-voz da Meta (abre em nova aba), escreveu no X que criar "um sinal comum que transmita essas preferências a vários provedores de uma vez é um passo importante". Não disse, porém, se a empresa vai respeitar o carimbo. Três dias antes, a EBU (União Europeia de Radiodifusão) havia cobrado da Meta a revisão de seus novos termos comerciais. Pelos termos, a empresa e seus agentes de IA poderiam raspar conteúdo de sites ligados a contas comerciais.
O que muda para quem tem um site
- Hoje: os bloqueios robô por robô continuam sendo a ferramenta disponível, já que só a Anthropic começou a aplicar o novo sinal.
- Quando o carimbo valer: uma única linha no robots.txt bastará para as empresas que o adotarem. A Meta segue em aberto.
- Antes de decidir: pese o pedágio. Sair do treino pode tirar seu conteúdo das respostas de IA, ainda que não do Bing.
O robots.txt sempre foi um pacto de cavalheiros, que vale enquanto quem lê decide obedecer. A novidade é que quatro dos maiores leitores prometem obedecer à mesma placa, e isso já é alguma coisa. A pergunta que interessa a jornais, blogs e lojas virtuais, porém, é outra: quem decide se um conteúdo pode alimentar uma máquina que lucra com ele. Essa resposta continua saindo dos tribunais, não de um arquivo de texto.