
A busca por respostas precisas e confiáveis em sistemas de inteligência artificial, especialmente aqueles que utilizam diversas fontes de informação, tem impulsionado o desenvolvimento de novas metodologias. Recentemente, foi apresentada uma pesquisa que propõe uma abordagem inovadora para a verificação de agentes que operam com o Protocolo de Contexto do Modelo (MCP), um sistema que permite a agentes de grandes modelos de linguagem (LLMs) acessarem e combinarem dados de fontes variadas, como resultados de busca, APIs, bancos de dados e registros clínicos. Essa pesquisa foca na "verificação consciente da fonte", um método que garante não apenas a correção das informações, mas também a sua atribuição à origem certa.
Agentes de inteligência artificial que usam ferramentas para interagir com o mundo, como os baseados em Model Context Protocol (abre em nova aba), estão se tornando cada vez mais comuns. Eles produzem respostas a partir de uma vasta gama de fontes heterogêneas, que incluem mecanismos de busca, interfaces de programação de aplicações (APIs), bancos de dados, registros e outras ferramentas externas. Atualmente, a forma como se verifica a veracidade dessas respostas geralmente envolve avaliar se a informação é suportada por um conjunto de evidências reunidas. No entanto, essa abordagem convencional possui uma lacuna importante: ela não consegue identificar quando uma informação, mesmo que correta, é atribuída à fonte errada. Esse problema é conhecido como "conflação entre fontes".
Para resolver essa questão, a pesquisa introduz o ProvenanceGuard. Pense no ProvenanceGuard como um detetive especializado em rastrear a origem das informações. Ele é uma camada de verificação que age de forma inteligente, consumindo "rastros" capturados do MCP, que são como históricos detalhados da interação do agente com suas ferramentas. Esses rastros incluem identificadores únicos para as ferramentas e as fontes, além das saídas brutas (ou seja, os dados originais) geradas por elas.
A metodologia do ProvenanceGuard funciona em etapas claras e lógicas, como um roteiro bem definido:
- Decomposição da resposta: Primeiro, o sistema divide a resposta do agente em pequenas afirmações individuais. Imagine uma frase complexa sendo quebrada em suas partes mais simples e verificáveis.
- Roteamento para a fonte específica: Cada uma dessas afirmações é então direcionada para a evidência que a suporta, mas com um diferencial crucial: o roteamento é feito para a fonte específica de onde a informação deveria ter vindo. Não é apenas saber se a informação existe em algum lugar, mas sim onde ela está.
- Verificação de suporte: Utilizando um sistema de inferência de linguagem natural (NLI) e um método que verifica a similaridade entre as palavras (um "proxy de alinhamento de tokens" derivado da atenção), o ProvenanceGuard verifica se a afirmação é realmente suportada pela evidência da fonte designada.
- Comparação da atribuição: Por fim, o sistema compara a fonte que o agente afirmou ter usado com a fonte que o ProvenanceGuard identificou como a correta. Isso permite detectar a conflação entre fontes, ou seja, quando uma informação é atribuída incorretamente.
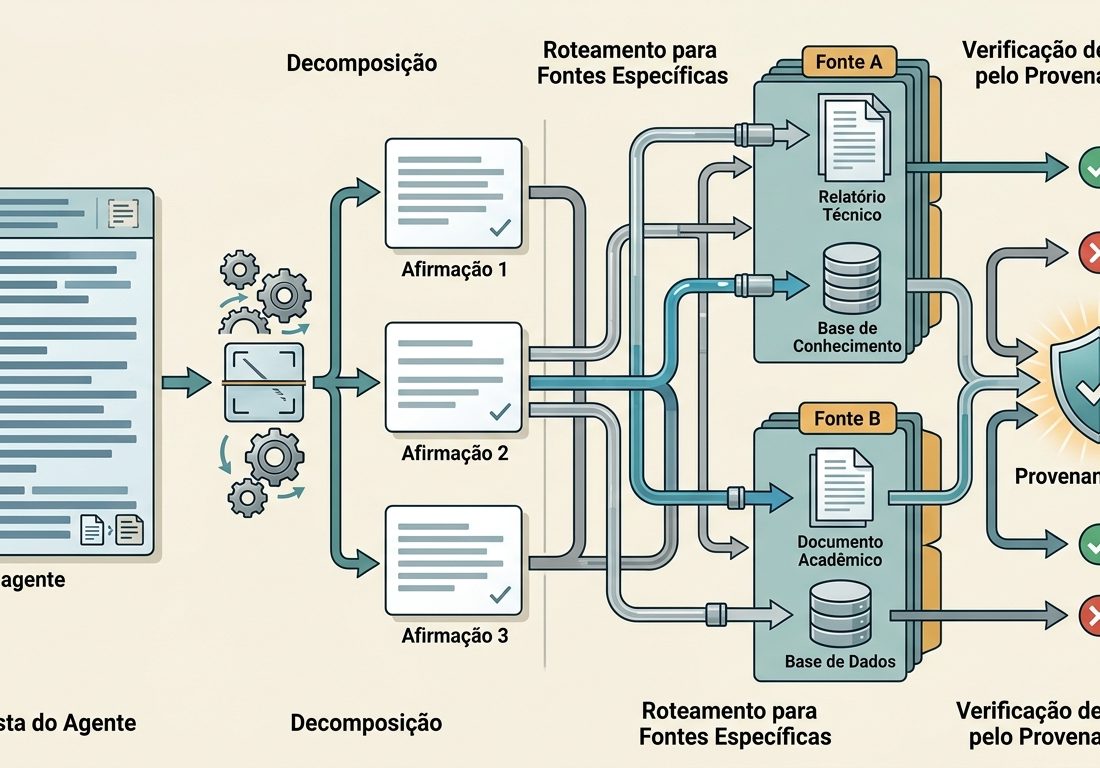
O ProvenanceGuard não apenas aponta erros, mas também sugere soluções. Ele retorna vereditos para cada afirmação individual e, em nível de resposta completa, decide se a resposta deve ser permitida ou bloqueada. Se uma resposta for bloqueada, o sistema pode invocar um mecanismo de revisão, como uma revisão de resposta aumentada por recuperação (RARR), para corrigir a resposta e submetê-la a uma nova verificação. É como ter um editor que não só encontra os erros, mas também ajuda a reescrever o que está incorreto antes da publicação final.
Para demonstrar a eficácia dessa abordagem, o ProvenanceGuard foi testado em um conjunto de 281 "rastros" reais de agentes MCP na área médica. Desses, 40 rastros com 361 afirmações foram usados para um teste rigoroso. Os resultados empíricos são bastante promissores:
- F1 para rejeição/bloqueio: O ProvenanceGuard alcançou um F1 (uma métrica que equilibra precisão e recall) de 0,802 para rejeitar ou bloquear respostas incorretas. Isso demonstra sua capacidade de identificar problemas de forma eficaz.
- Precisão da fonte: Para 260 afirmações elegíveis para verificação de fonte, o sistema atingiu uma precisão de 0,858 na identificação correta da origem.
- Detecção de atribuição incorreta: Em 50 testes focados em conflação de fontes, onde foram deliberadamente inseridas atribuições de fonte incorretas, o ProvenanceGuard detectou todas as 50 trocas, sem reter nenhuma atribuição errada.
Estes resultados superam os métodos de linha de base que não consideram a origem específica da informação, evidenciando que a atribuição da fonte é um aspecto independente e crucial para a verificação da veracidade em agentes baseados em MCP.
Os impactos práticos dessa técnica são significativos. Com o desenvolvimento de agentes autônomos cada vez mais integrados a APIs e sistemas externos, a capacidade de garantir que as informações não apenas sejam verdadeiras, mas também atribuídas corretamente, é fundamental. Para desenvolvedores, o ProvenanceGuard oferece uma ferramenta robusta para aumentar a confiança e a transparência em seus sistemas de IA. Ele ajuda a mitigar o problema da "alucinação" (quando a IA gera informações falsas) e a "atribuição incorreta" de fontes, que podem ter consequências sérias, especialmente em domínios críticos como a medicina. Ao garantir que a origem da informação seja sempre clara e verificada, essa pesquisa pavimenta o caminho para agentes de IA mais confiáveis e responsáveis, que podem ser usados com maior segurança em aplicações do mundo real. A capacidade de reparar e reverificar respostas bloqueadas, muitas vezes por meio de uma abordagem conservadora, reforça a robustez do sistema, garantindo que mesmo as informações mais delicadas sejam tratadas com a máxima precisão e cuidado em relação à sua origem.