
A organização de inteligência artificial Ornith (abre em nova aba) apresentou os detalhes de implementação e disponibilizou a família de modelos Ornith-1.5 DFlash. A iniciativa une modelos avançados de raciocínio a uma técnica voltada a diminuir o tempo de resposta, chamada decodificação especulativa. O objetivo central é permitir que sistemas computacionais gerem textos e resolvam tarefas complexas de lógica com maior rapidez, sem abrir mão da precisão original.
O que é a família Ornith-1.5 e por que a velocidade importa
A família Ornith-1.5 foi desenvolvida como uma evolução do sistema Ornith-1.0, originalmente construído sobre as bases do Qwen3.5 e do Gemma 4 com fases adicionais de pré-treino contínuo, treino intermediário e pós-treino. Enquanto a versão anterior focava na otimização de estruturas básicas, a linha 1.5 introduziu um ciclo de autoaprimoramento de ponta a ponta: o próprio sistema propõe tarefas inéditas, cria roteiros para resolvê-las e gera soluções para treinamento por reforço.
Quando um modelo de linguagem opera em computadores, o processo de inferência (a etapa em que ele calcula e gera respostas para o usuário) costuma prever uma única palavra ou fragmento de texto (chamado de token) por vez. Em tarefas longas de programação ou raciocínio, isso pode criar lentidão. É nesse ponto que entra a tecnologia Ornith-1.5-397B-DFlash (abre em nova aba), pensada para acelerar a emissão das respostas.
Como funciona a decodificação especulativa com o DFlash
Para entender o funcionamento, podemos pensar na dinâmica entre um assistente ágil e um professor especialista.
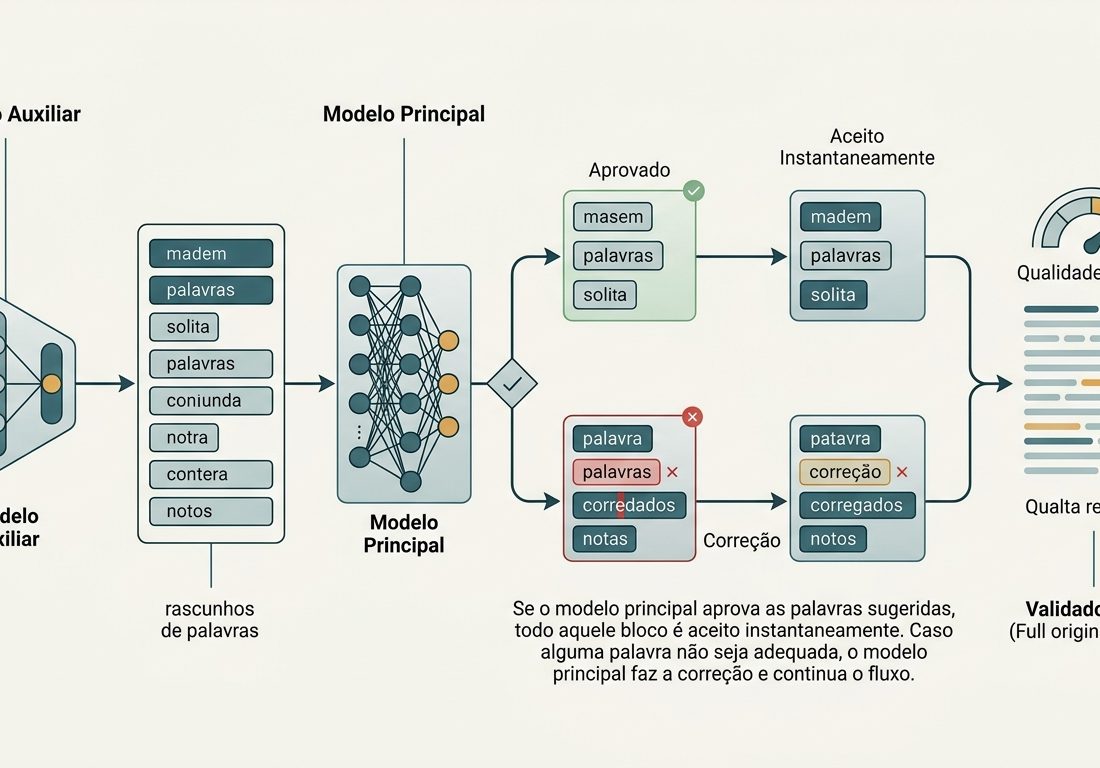
Em sistemas comuns, o professor especialista precisaria pensar, escrever e revisar palavra por palavra, de forma sequencial. Na decodificação especulativa com o DFlash, o trabalho é dividido em duas partes distintas:
- O modelo de rascunho (DFlash): Trata-se de uma estrutura leve baseada em difusão em blocos. O DFlash não funciona como um modelo de linguagem independente para responder sozinho ao usuário. Seu único papel é sugerir vários tokens em paralelo, como um assistente que redige rapidamente um parágrafo de rascunho.
- O modelo principal (alvo): É o modelo Ornith-1.5 completo. Ele atua como o professor que avalia a sugestão. O modelo principal confere as opções propostas pelo rascunho de uma só vez.
Se o modelo principal aprova as palavras sugeridas, todo aquele bloco é aceito instantaneamente. Caso alguma palavra não seja adequada, o modelo principal faz a correção e continua o fluxo. Como o validador final é sempre o modelo completo, a qualidade e o estilo da resposta permanecem exatamente idênticos aos do sistema original.
Três tamanhos de modelos e desempenhos registrados
A família Ornith-1.5 foi distribuída em três escalas diferentes, cobrindo desde dispositivos compactos até supercomputadores:
- Ornith-1.5-9B: Um modelo denso de 9 bilhões de parâmetros, planejado para ser executado em uma única placa de vídeo (GPU) e com suporte para aparelhos celulares por meio da versão quantizada Ornith-1.5-9B-Mobile.
- Ornith-1.5-35B-A3B (abre em nova aba): Um modelo intermediário com arquitetura de mistura de especialistas (MoE). Embora tenha 35 bilhões de parâmetros no total, ele ativa apenas cerca de 3 bilhões de parâmetros por token gerado, mantendo baixo custo de processamento com alto desempenho em tarefas de código.
- Ornith-1.5-397B: O modelo principal e mais robusto da linha, também estruturado em mistura de especialistas com 397 bilhões de parâmetros, voltado a raciocínio avançado.
Em avaliações técnicas publicadas no anúncio do sistema em agosto de 2026, o modelo Ornith-1.5-397B atingiu a marca de 86,1 pontos no teste de comandos de terminal Terminal-Bench 2.1 e 56,0 pontos no índice de engenharia de software DeepSWE. O intermediário Ornith-1.5-35B marcou 68,5 pontos no Terminal-Bench 2.1 e 79,0 pontos no SWE-Bench Verified.
Em termos de velocidade pura com o rascunho ativado, medições registradas em implementações da comunidade técnica comprovaram o ganho de fluidez:
| Versão avaliada | Ambiente e configuração | Desempenho observado | Ganho registrado |
|---|---|---|---|
| Ornith-1.5-35B-A3B com DFlash2 (abre em nova aba) | Sistema DGX Spark, concorrência 1 | 114,2 tokens por segundo (média de 4,02 tokens aceitos por ciclo) | Aumento de 44,0% em relação ao modelo sem rascunho |
| Ornith-1.5-9B DFlash em int4 (abre em nova aba) | Gráficos integrados Intel Arc 130V com OpenVINO | Salto de 17,4 para 51,0 tokens por segundo | Velocidade 2,93 vezes maior com saída idêntica em nível de bytes |
Esses testes indicam como a estratégia consegue encurtar o tempo de espera do usuário, especialmente em hardware com restrições de memória.
Como desenvolvedores podem rodar os modelos
Os arquivos dos modelos de rascunho DFlash foram disponibilizados publicamente para pareamento com as versões Ornith-1.5-9B (abre em nova aba) e maiores.
Por padrão, a família Ornith-1.5 adota o comportamento de modelo de raciocínio, abrindo o início da resposta com blocos delimitados por marcações de pensamento antes de entregar a resposta final.
Para colocar a solução em operação, os desenvolvedores precisam utilizar versões recentes dos motores de inferência. Os requisitos recomendados incluem a biblioteca Transformers em versão igual ou superior a 5.8.1, o servidor vLLM em versão 0.20.2 ou superior (com testes homologados na versão 0.28.0) ou o ambiente SGLang na edição 0.5.18.
A execução exige carregar o arquivo do modelo principal em conjunto com o caminho do diretório onde está o modelo de rascunho DFlash. Nos parâmetros de amostragem informados para as ferramentas, recomenda-se configurar a temperatura em 0,6 com corte de probabilidade acumulada em 0,95 para tarefas gerais ou de programação precisa, além de utilizar o tamanho de bloco especulativo ajustado em 8 tokens. Com esses comandos nos servidores compatíveis, equipes de engenharia de software já podem integrar a nova arquitetura diretamente aos seus sistemas produtivos.