
Um novo ambiente de avaliação chamado OptiArena (abre em nova aba) foi apresentado em 29 de setembro de 2026 para investigar como os modelos de linguagem grande, conhecidos pela sigla em inglês LLMs, lidam com a tarefa de aprimorar programas de computador que precisam funcionar na prática. O projeto analisa se esses sistemas de inteligência artificial conseguem atuar como agentes de programação e ferramentas de pesquisa capazes de ajustar códigos executáveis de algoritmos que disputam jogos.
Os testes tradicionais de programação para modelos de linguagem costumam focar em formatos estáticos de perguntas e respostas ou na geração direta de código isolado. Nesses formatos convencionais, a inteligência artificial apenas escreve uma resposta ou resolve um problema único e pontual. O OptiArena adota um caminho diferente ao propor um cenário interativo e contínuo, onde o modelo precisa refinar uma solução já funcional ao longo do tempo.
O que é o OptiArena e por que ele importa
O OptiArena funciona como uma arena de testes práticos voltada para a melhoria de algoritmos executáveis. Em vez de apenas verificar se um código compila ou responde a uma pergunta teórica, o sistema coloca algoritmos para rodar em cinco jogos diferentes.
Essa abordagem tem relevância direta para o uso real da inteligência artificial. Na rotina de desenvolvimento de software, os profissionais raramente escrevem sistemas inteiros do zero sem realizar ajustes. O trabalho diário envolve revisar, encontrar gargalos e aperfeiçoar programas existentes sem quebrar as partes que já funcionam bem. Ao analisar essa dinâmica em algoritmos de jogos, o ambiente consegue mensurar se a máquina realmente compreende o impacto de suas alterações no desempenho prático.
Como funcionam as rodadas de edição e o controle de orçamento
O processo de teste no OptiArena segue uma estrutura bem delimitada. O modelo de linguagem recebe um código inicial dentro de uma estrutura básica mínima e fixa. A partir desse ponto de partida, a inteligência artificial passa por exatamente cinco rodadas sucessivas de edições no código.
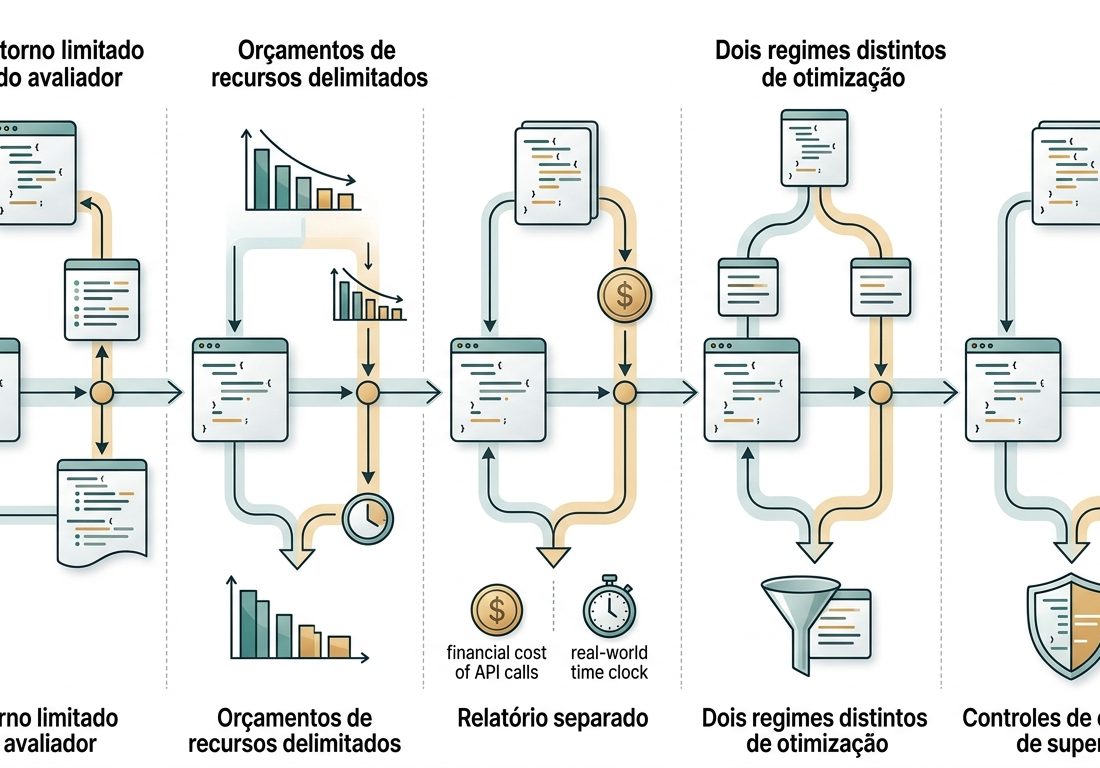
Em cada uma dessas etapas, o modelo não atua de forma livre ou infinita. O estudo aplica um controle rigoroso de recursos, conhecido como orçamento fixo. Esse controle envolve restrições claras:
- Retorno limitado do avaliador, o que significa que o modelo recebe apenas informações resumidas e controladas sobre o desempenho do seu código anterior;
- Orçamentos de recursos delimitados para guiar o experimento;
- Relatório separado entre o custo financeiro das chamadas de interface de programação de aplicações e o tempo real de relógio gasto pelo avaliador local;
- Dois regimes distintos de otimização para testar diferentes estratégias de evolução do algoritmo;
- Controles de ofuscação de superfície, que alteram a aparência textual do código para evitar que o modelo use decorebas visuais;
- Divisões de testes sob estresse e dados retidos, além de diagnósticos específicos para quedas de desempenho e falhas excepcionais.
O funcionamento lembra o trabalho de um mecânico que recebe um carro e tem cinco paradas programadas nos boxes para fazer ajustes. Ele só pode mexer em peças autorizadas, conta com ferramentas limitadas e descobre o resultado da corrida apenas pelo tempo final de cada volta.
Principais resultados e limitações observadas
A pesquisa empírica avaliou doze modelos de ponta da inteligência artificial contra referências calibradas. O estudo buscou responder a três perguntas principais: se os modelos conseguiam fechar a diferença calibrada entre uma base inicial fraca e uma base competente editável; se conseguiam refinar as bases competentes sem danificá-las; e se os ganhos conquistados resistiam aos controles de ofuscação de superfície.
Os resultados revelaram comportamentos distintos e limitações claras nos sistemas analisados:
| Desafio proposto aos modelos | Desempenho observado nos testes |
|---|---|
| Melhorar códigos iniciais fracos | Ganhos mais consistentes na maioria dos casos |
| Refinar códigos competentes | Dificuldade maior em evoluir sem quebrar funções |
| Comportamento geral | Variação substancial entre diferentes jogos e modelos |
A principal constatação foi que os modelos conseguem melhorar programas fracos com muito mais consistência do que conseguem refinar soluções que já são competentes. Quando o código inicial já era razoavelmente bom, muitas inteligências artificiais acabaram piorando o desempenho ou introduzindo falhas que degradaram o algoritmo. A eficiência também variou de forma expressiva na comparação entre os doze modelos e os cinco jogos avaliados.
As diferenças em relação aos métodos tradicionais
A distinção entre o OptiArena e avaliações tradicionais de código estático fica evidente na comparação direta de propósitos. Métodos consolidados, como o teste amplamente conhecido HumanEval, focam na geração direta de código estático. Neles, o modelo recebe um enunciado e escreve uma função de uma só vez para passar em casos de teste predeterminados.
O OptiArena, por outro lado, avalia a capacidade de conduzir otimizações sucessivas em algoritmos completos que precisam competir entre si. A metodologia exige que o agente de inteligência artificial interprete o feedback recebido, decida o que vale a pena mudar e mantenha o algoritmo estável ao longo de cinco ciclos consecutivos de edição, respeitando o teto de recursos computacionais estabelecido pelo ambiente.
Próximos passos e disponibilidade do código
O experimento delimitou suas conclusões ao formato exato investigado, composto pela estrutura fixa e pelas cinco rodadas de alterações. Como ferramenta para o avanço da área, a equipe disponibilizou o projeto publicamente. Os arquivos e a implementação do ambiente estão acessíveis no repositório OptiArena no GitHub (abre em nova aba), permitindo que outros pesquisadores executem o teste e acompanhem a evolução dos modelos em tarefas de otimização de algoritmos.