
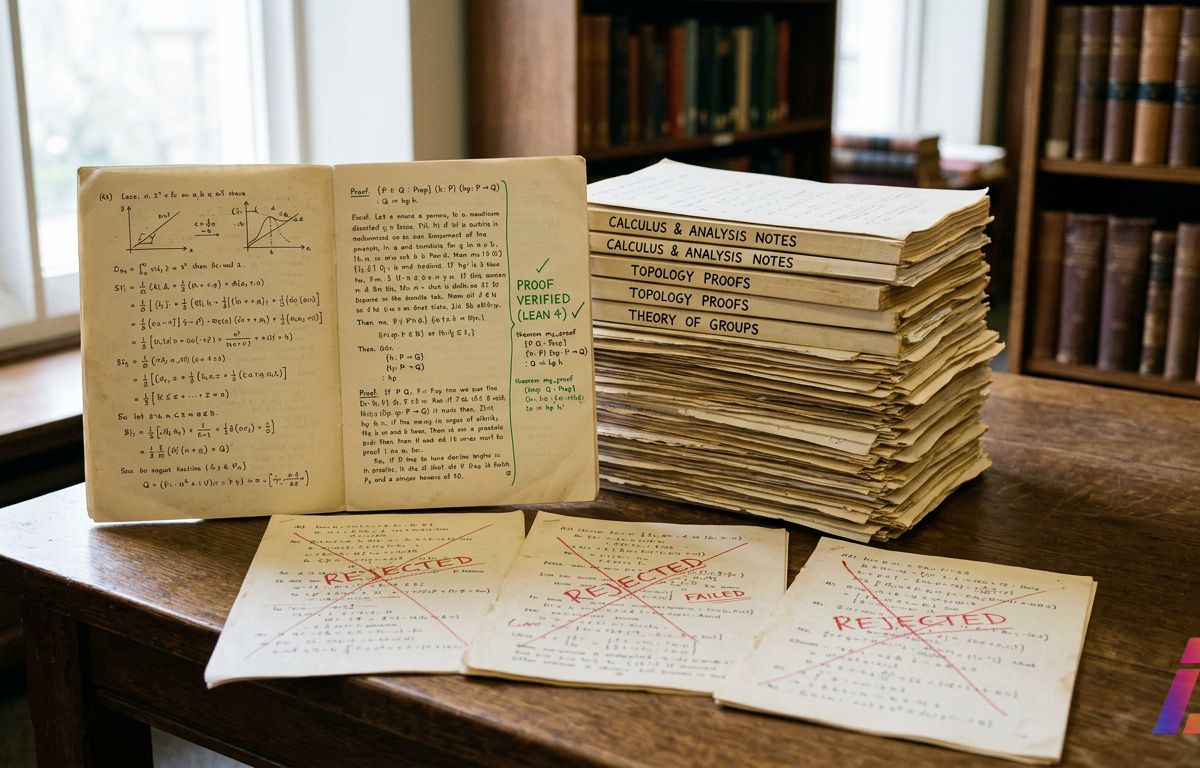
Mais de setecentos manuscritos de matemática: esse foi o volume que a OpenAI colocou à disposição do público na terça-feira, 6 de outubro de 2026, em um repositório aberto no GitHub. Segundo a empresa, os textos saíram de um modelo interno de inteligência artificial que não está liberado para uso. Um dia depois, um erro de sinal derrubou três deles. Na quarta-feira, 7 de outubro, uma associação de matemáticos publicava um pedido formal de rompimento com a companhia.
O que foi publicado
O anúncio da OpenAI (abre em nova aba), de 6 de outubro, descreve a entrega como uma ampla gama de novos resultados matemáticos produzidos por um modelo de fronteira interno, expressão que a indústria usa para os sistemas mais avançados de uma empresa. No caso, um modelo de linguagem de grande escala (LLM, na sigla em inglês): programa treinado para processar e gerar texto, código e raciocínios longos. A empresa diz ter consultado um grupo assessor independente de matemática e IA ligado ao Instituto de Estudos Avançados (IAS) e ter seguido as recomendações públicas do grupo sobre como liberar o material.
O repositório no GitHub (abre em nova aba) dá os números. Na versão do README atualizada em 8 de outubro, são 719 manuscritos organizados em 372 famílias de resultados, classificadas por disciplina; uma família pode reunir um resultado principal, argumentos complementares, consequências ou provas alternativas do mesmo fato. O modelo interno recebeu aproximadamente 4 mil problemas, e cada resultado consumiu, em média, o equivalente a três horas de raciocínio do ChatGPT Pro, a assinatura avançada da OpenAI. É a forma que a empresa encontrou de medir esforço computacional: em horas de uso de um serviço que ela mesma opera.
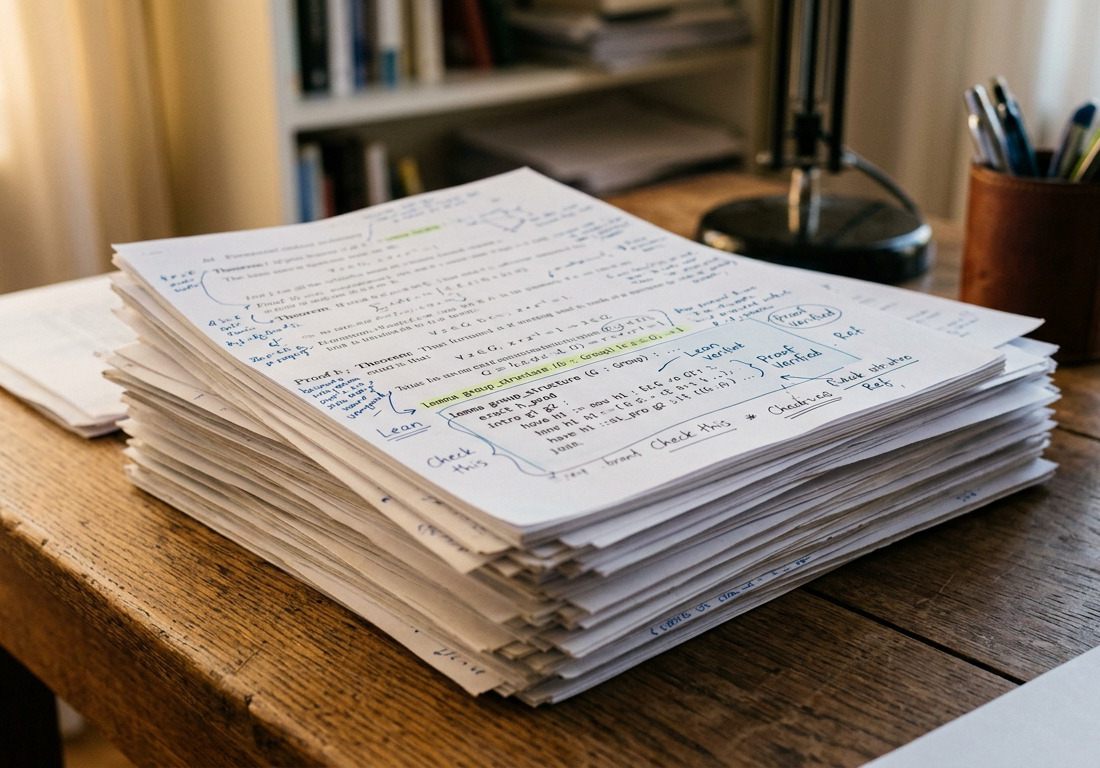
As avaliações foram expandidas, diz o README, depois que os testes matemáticos existentes saturaram, ou seja, o modelo esgotava o que havia disponível para medir seu desempenho. A grande maioria dos resultados seguiu o mesmo procedimento, com duas exceções citadas: um trabalho sobre uma região sem zeros da função zeta de Riemann, central no estudo dos números primos, e uma prova da Conjectura de Hodge para variedades abelianas CM, objetos da geometria algébrica. O texto da região sem zeros, definida pela condição Re(s) > 11/12, foi editado por pessoas para melhorar a legibilidade. Há ainda dez resumos do raciocínio do modelo, listados por família.
:::context O que é Lean. Lean é uma linguagem na qual demonstrações matemáticas são escritas de modo que um programa confira cada passo lógico. Quando a prova é aceita pelo verificador, existe um certificado mecânico: a validade não depende de um leitor humano, desde que a checagem esteja correta. A formalização reduz o risco de lacunas, mas não gera entendimento. Ninguém precisa compreender por que uma prova funciona para que ela seja aceita.
:::
O que está comprovado e o que não está
Cerca de 42% dos resultados principais têm formalização em Lean; o arquivo de histórico do repositório quantifica: 300 de 719. Para essa fatia, um verificador conferiu cada passo. Para o resto, o próprio README admite que resultados não formalizados podem ter problemas.
No blog Shtetl-Optimized (abre em nova aba), o cientista da computação Scott Aaronson tratou 6 de outubro como um dos maiores dias da história da matemática. Ele menciona 372 resultados, entre eles o que descreve como uma prova da Conjectura dos Jogos Únicos, formulada por Subhash Khot, com certificado em Lean para esse resultado e para parte dos demais. E registra a lacuna central: aparentemente, escreve ele, nenhum humano entendeu até agora quase nenhuma dessas provas.
A matemática Dana Moshkovitz, citada por Aaronson, disse que o texto da conjectura de Khot está escrito de um jeito tão ruim que fica impossível de ler sem ajuda de IA. Ela descreveu um novo código recursivo presente na demonstração como uma maluquice alienígena. Já a página da OpenAI não afirma que cada prova passou por verificação humana independente.
Reportagem de The Atlantic, em 8 de outubro, acrescenta que ainda é cedo para verificação detalhada. Vários matemáticos disseram à reportagem que ao menos alguns artigos parecem não provar o que prometem. O veículo registra a divisão do material: cerca de um terço seriam provas maiores de conjecturas famosas, um terço resultados significativos dentro de uma subárea e o terço restante resultados menores ou variantes.
Um erro de sinal, três retratações
O arquivo de histórico (abre em nova aba), com mudanças registradas sob a data de 7 de outubro, conta a queda. Um erro de sinal no manuscrito "Algebraicity of Weil classes on split abelian eightfolds" invalida um argumento de cancelamento e a construção usada por dois artigos dependentes. A OpenAI retirou os três: o manuscrito com a falha, "Algebraicity of Kuga–Satake Correspondences for K3 Surfaces" e "The rational Hodge conjecture for products of K3 surfaces".
Catorze manuscritos foram revisados, com reparos de prova, enunciados corrigidos, hipóteses e dependências mais claras e a correção de uma citação obsoleta. Treze outros foram atualizados para citar os parceiros revisados. Entraram seis formalizações novas e cinco adições de resultados de apoio; a conta de resultados principais formalizados chegou a 300 de 719, cerca de 42%. Os arquivos README dos textos retirados explicam a falha e apontam o manuscrito retratado, e edições anteriores dos artigos atualizados seguem acessíveis.
Um porta-voz da OpenAI escreveu por e-mail à reportagem de The Atlantic que a empresa "espera que erros sejam bastante raros".
O protesto dos matemáticos
Em 7 de outubro, o blog de Terence Tao (abre em nova aba), do matemático medalhista Fields, publicou como post de convidado a declaração da Association for Human Mathematics (AHM), que em tradução livre é Associação pela Matemática Humana, reproduzida da página de declarações da própria entidade. Tao observou, em nota, que o texto tinha sido escrito em outro formato de arquivo e convertido com ajuda de IA.
Para a AHM, os manuscritos "pretendem conter" soluções de problemas de alta visibilidade, e matemáticos não pediram que esse trabalho fosse feito. A entidade lembra que a declaração inicial de aconselhamento do grupo do IAS começava dizendo que empresas de IA de fronteira não deveriam testar problemas matemáticos avançados em modelos internos. Ao ignorar essa premissa, escreve a associação, a OpenAI mostrou desprezo total pelas normas da pesquisa científica. A AHM rejeita a afirmação da empresa de que a liberação faz a matemática avançar e resume o gesto: liberar mais de 700 arquivos de uma só vez não é uma demonstração de erudição, é uma demonstração de poder. O pedido final é que matemáticos interrompam o trabalho com a OpenAI e voltem a uma ciência centrada no entendimento humano.
A empresa sustenta, em resposta, que consultou o grupo assessor, seguiu recomendações públicas para a liberação, criou protocolos de revisão e citação no repositório e continua explorando alternativas hospedadas pela comunidade que atendam às diretrizes do comitê.
Os números não batem
Mesmo o inventário está em disputa.
| Fonte | Contagem |
|---|---|
| Repositório (README, 8 de outubro) | 719 manuscritos em 372 famílias; cerca de 4 mil problemas propostos |
| Scott Aaronson (7 de outubro) | Aparentemente cerca de 8 mil problemas tentados; cerca de 5% resolvidos em uma tentativa |
| The Atlantic (8 de outubro) | 377 provas novas; cerca de 3,6 mil problemas adicionais tentados sem provas liberadas |
Aaronson anota que a cifra de 8 mil não é medição dele, e sim informação aparente, em conflito com os cerca de 4 mil do repositório. A página de anúncio da OpenAI não lista quantidade de manuscritos; The Atlantic menciona ainda que a empresa havia antecipado, antes do lançamento, um modelo com soluções para mais de 100 problemas em aberto de longa data. Parte da divergência é de unidade: famílias, manuscritos e provas são contagens diferentes. Parte é mesmo discrepância.
Dois modos de publicar
Aaronson contrapõe o que chama de modo OpenAI, despejar soluções sem digestão, ao modo Anthropic. Um dia antes do lançamento, os pesquisadores Virginia Vassilevska Williams e Josh Alman publicaram um preprint no arXiv com uma ideia crucial obtida com um modelo da Anthropic para os problemas 3SUM e APSP, dois desafios clássicos de algoritmos, e tiveram a chance de escrever a versão digerida do próprio resultado.
Acesso e promessas
O repositório é público, em inglês, com licença Apache 2.0, que permite leitura, uso e redistribuição. Qualquer pessoa, no Brasil ou fora, pode ler manuscritos, resumos e histórico de correções sem custo. O modelo que produziu os resultados permanece interno. A OpenAI diz que quer liberá-lo de forma responsável e que seguirá avaliando modelos de fronteira internos em matemática e outras ciências. Promessa, sem data.
O catálogo existe. O entendimento, ainda não.
Perguntas frequentes
O que a OpenAI publicou em 6 de outubro de 2026?
Um repositório no GitHub com 719 manuscritos organizados em 372 famílias de resultados matemáticos, produzidos por um modelo interno não liberado. Inclui formalizações em Lean de cerca de 42% dos resultados principais, dez resumos do raciocínio do modelo e estatísticas de problemas tentados, sob licença Apache 2.0.
As provas foram verificadas por humanos?
Não, no conjunto. A página da OpenAI não afirma verificação humana independente de cada prova. As formalizações em Lean dão certificado mecânico a 300 dos 719 resultados principais, o restante pode conter problemas, segundo o próprio repositório, e três manuscritos foram retirados por causa de um erro de sinal.
Por que matemáticos pediram rompimento com a OpenAI?
A Associação pela Matemática Humana alega que matemáticos não pediram o trabalho, que o grupo assessor do IAS recomendou que empresas não testassem problemas matemáticos avançados em modelos internos e que liberar mais de 700 arquivos de uma vez é uma demonstração de poder. Pede que pesquisadores interrompam a colaboração.
Os números divulgados coincidem?
Não. O repositório fala em cerca de 4 mil problemas propostos, Scott Aaronson menciona aparentemente cerca de 8 mil tentativas, e The Atlantic relata 377 provas novas e cerca de 3,6 mil tentativas adicionais. Famílias, manuscritos e provas são unidades diferentes, mas há divergência real entre as fontes.