

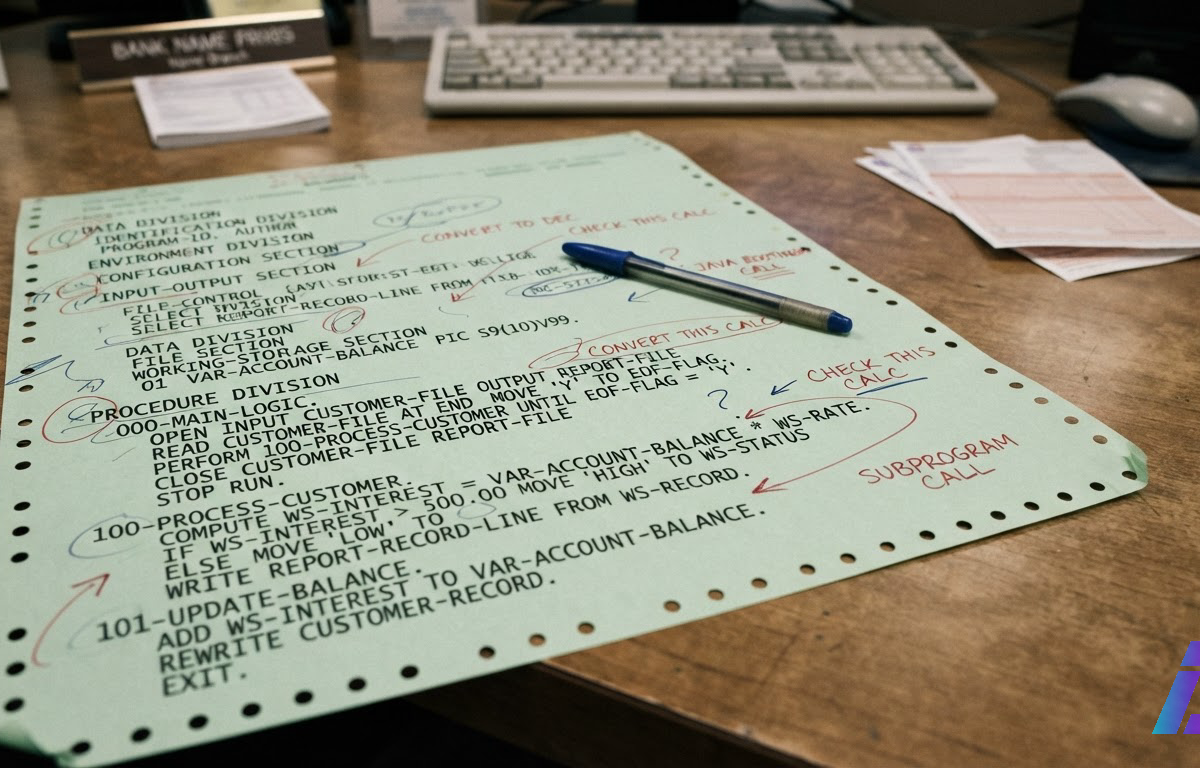
A OpenAI (abre em nova aba) divulgou nesta segunda-feira (19) resultados de pesquisa (abre em nova aba) sobre sistemas escritos em COBOL, Fortran e Visual Basic, um tipo de software que quase ninguém vê e quase todo mundo usa. O número principal vem de um teste da própria empresa: o modelo GPT-6.1 Sol converteu programas em COBOL para linguagens modernas, mantendo o comportamento original, em 86,6% dos casos. A geração anterior, GPT-5.6 Sol, acertava 5,4%. Quando o modelo pode trabalhar mais no problema, o índice chega a 97,9%.
Com esse salto, a IA deixa de ser inútil nessa tarefa e passa a merecer um teste sério. Falta a outra metade da informação: os testes foram desenhados e aplicados pela própria OpenAI.
Onde esse código roda
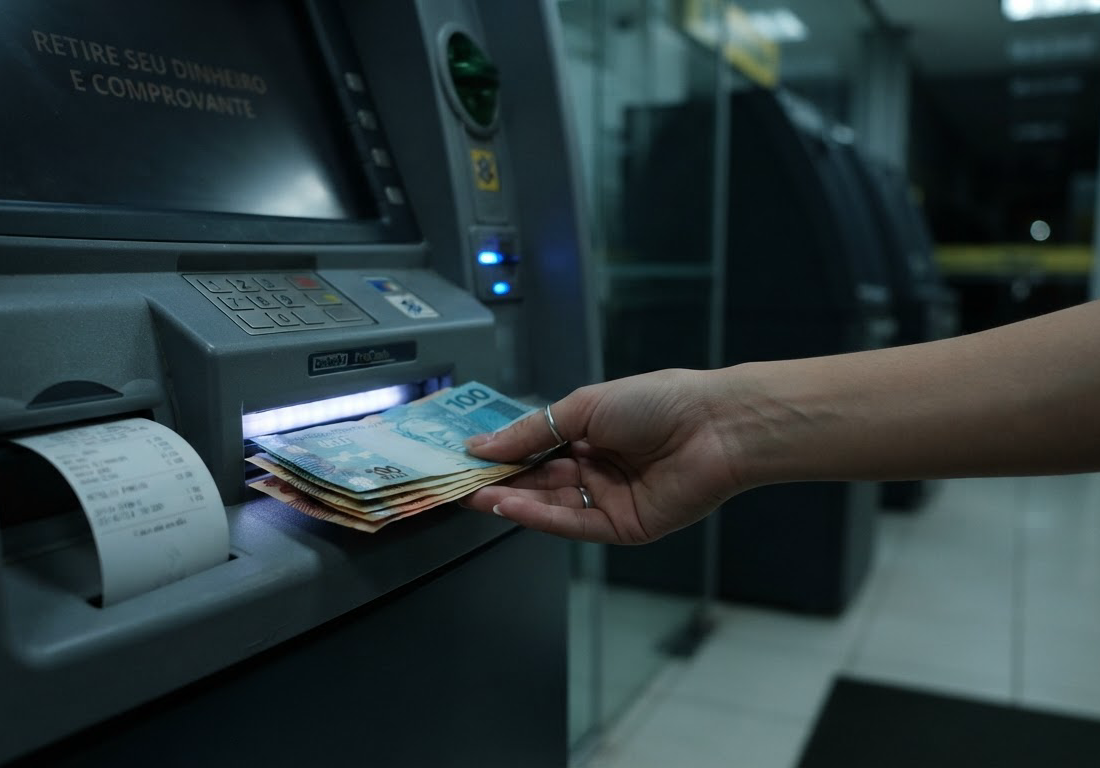
A OpenAI recorre a estimativas da IBM (abre em nova aba) para mostrar o peso do assunto. Segundo a IBM, o COBOL sustenta mais de 40% dos sistemas de internet banking, 80% das transações presenciais com cartão de crédito e 95% das operações em caixas eletrônicos. O Fortran, outra linguagem citada, é usado em previsão do tempo e em análises de segurança de reatores nucleares. Pelas contas da IBM, quem sacou dinheiro esta semana provavelmente passou por um programa em COBOL.
Essas linguagens são chamadas "de poucos recursos" porque existe relativamente pouco código escrito nelas disponível para os modelos de IA aprenderem. O desempenho do GPT-5.6 Sol mostra o tamanho do problema: no teste da OpenAI, ele passava em apenas 10,9% das verificações em COBOL.
Os dois testes
A OpenAI montou duas avaliações.
A primeira, o MultiLangBench (abre em nova aba), pede ao modelo que construa do zero, em 20 linguagens diferentes, um banco de dados compatível com o SQLite (abre em nova aba) 3.40.1. Um banco de dados é o programa que guarda informações e responde a consultas. O modelo recebe apenas a documentação e não tem acesso à internet. O SQLite é removido do ambiente para impedir cópia. A solução precisa estar inteira na linguagem pedida: se o modelo escrever em outra ou misturar linguagens, a nota é zero. Cada teste compara a resposta do programa com a do SQLite verdadeiro e só passa se o resultado for exatamente o esperado. Travar ou demorar mais de 60 segundos conta como falha.
A segunda avaliação reproduz o trabalho que interessa aos bancos: pegar programas em COBOL que já existem e reescrevê-los em C++, Java, Kotlin, Python ou Rust sem mudar o que eles fazem. O acerto só vale se o programa traduzido passar em todos os testes ocultos e produzir saídas idênticas às do original, byte a byte, sem um caractere de diferença. Esse é o critério certo, porque num sistema bancário um resultado "quase igual" é um erro.
Os números
No MultiLangBench, com o esforço máximo de raciocínio, o GPT-6 Astra teve média de 87,4% de testes aprovados nas 20 linguagens. O GPT-5.6 Sol tinha 26,8%. O novo modelo melhorou em todas as linguagens.
| Linguagem | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| COBOL | 10,9% | 72,1% |
| Fortran | 21,4% | 83,5% |
| OCaml | 25,6% | 85,8% |
| Visual Basic | 27,5% | 89,4% |
| Média das 20 linguagens | 26,8% | 87,4% |
O Astra passou de 83% em 19 das 20 linguagens. A exceção é o COBOL, que ficou em 72,1%. A linguagem que mais pesa no sistema financeiro é justamente aquela em que o modelo vai pior. Há um atenuante: esse teste mede a capacidade de escrever um programa novo em COBOL, enquanto o desafio dos bancos é tirar o código de lá. Na migração, os números divulgados são mais altos.
Os resultados variam conforme o "esforço de raciocínio", uma configuração que define quanto o modelo trabalha no problema antes de entregar a resposta. Na migração, o GPT-6.1 Sol fez 86,6% no nível baixo e 97,9% num nível mais alto.
O custo também entrou no anúncio. O GPT-6 Luna teve média de 40,3% no MultiLangBench, a um custo estimado de US$ 0,77 por amostra (cada execução da tarefa). O GPT-5.6 Sol custava US$ 3,48, cerca de 78% a mais, e acertava menos. Na migração de COBOL, o GPT-6.1 Sol no nível baixo de raciocínio custou 39% menos em uso da API do que o GPT-5.6 Sol, segundo a OpenAI.
As letras miúdas
O site Interesting Engineering, que noticiou o anúncio, deixou claro que estava repassando as alegações da OpenAI, sem refazer os testes. Também lembrou que o 97,9% vale para o conjunto de testes da empresa e não garante migrações sem erro.
A própria OpenAI diz que usar isso em produção ainda exige revisão de especialistas e testes contra as regras de negócio e as dependências de cada sistema. Na prática, a empresa reconhece que passar no teste dela não equivale a substituir o sistema de um banco.
O MultiLangBench foi publicado no GitHub com licença Apache 2.0, o que permite a qualquer pessoa rodar a avaliação. O repositório também mostra os limites desse teste. Dos cerca de 51 mil testes originais do SQLite, 24 mil foram convertidos para o benchmark. Como rodar todos sai caro, a orientação é usar só 272 deles e registrar quando a bateria completa for usada. O repositório não traz as taxas de acerto divulgadas no anúncio. O anúncio também menciona apenas a abertura do MultiLangBench. Pelo que foi divulgado, a avaliação de migração, de onde sai o número mais vistoso, continua sob controle da empresa.
O recado para os clientes
A conta oficial da OpenAI no X resumiu o anúncio. A última frase mostra o objetivo: a empresa está chamando bancos, governos e empresas que mantêm esses sistemas para dizerem onde ela deve trabalhar em seguida.
Os avanços mais recentes dos nossos modelos trazem capacidades mais fortes para criar e migrar software em linguagens de programação de poucos recursos, como COBOL, Fortran e Visual Basic. Essas linguagens movem softwares dos quais bancos, governos e empresas dependem. Avançar aqui significa entender décadas de lógica de negócio e ajudar desenvolvedores a modernizar esses sistemas preservando o que funciona. Estamos construindo essas capacidades em torno dos desafios que desenvolvedores e clientes corporativos nos trazem. Se a sua equipe trabalha com esses sistemas, diga quais linguagens e fluxos de trabalho devemos atacar em seguida.
O pedido faz sentido como estratégia. Quem domina a migração de COBOL ganha acesso aos sistemas de dinheiro de bancos e governos, e esses clientes passam a depender dele.
O que muda para quem lê
Para o cliente de banco, nada muda por enquanto. Nenhum desses números significa que o caixa eletrônico da esquina já roda código reescrito por IA. Pelo que a própria OpenAI descreve, qualquer migração real passa por especialistas e testes antes de entrar em produção.
Para quem trabalha em empresa com sistemas antigos, agora existem números públicos para cobrar de fornecedores e um teste aberto para conferir ao menos parte das alegações. Ainda assim, quem decide se o comportamento do sistema foi preservado é a equipe da casa, contra as regras do próprio negócio.
Para quem programa em COBOL ou Fortran, a descrição da OpenAI aponta onde fica o trabalho humano: revisar o que o modelo produziu e testar contra regras que só quem conhece o sistema sabe quais são.
Até que alguém de fora repita os testes, o 97,9% é um número da OpenAI sobre a OpenAI.