
A identificação de conteúdos digitais ganhou uma camada estatística voltada a textos. A OpenAI (abre em nova aba) apresentou em 5 de outubro de 2026 o textGrain, uma tecnologia de marca d'água invisível desenvolvida para indicar quando um texto foi produzido por modelos de inteligência artificial. A solução foi desenhada para responder diretamente às normas de procedência do Regulamento de Inteligência Artificial da União Europeia, conhecido como EU AI Act, bem como aos compromissos do Código de Prática sobre a Transparência de Conteúdos Gerados por IA.
O que é e como funciona a marcação
Muitas marcas d'água visuais inserem carimbos ou metadados em arquivos de imagem e áudio. No texto escrito, contudo, esse processo precisa ser diferente. O textGrain (abre em nova aba) não recorre a truques como espaços ocultos, pontuação atípica ou caracteres invisíveis. A marca fica inserida na própria escolha dos termos.
Para compreender o método, convém pensar na forma como os modelos de linguagem trabalham. A cada nova palavra ou pedaço de palavra, chamado de token, a máquina tem à disposição várias opções plausíveis. O sistema ajusta a aleatoriedade dessa seleção, associando a geração das palavras a uma chave secreta por meio de formulações matemáticas de transporte ótimo e regularização de Kullback-Leibler. Em termos práticos, se o modelo pudesse escolher de forma natural entre as palavras "veloz" e "rápido" com probabilidades semelhantes, ele aplica uma inclinação controlada em direção a uma delas.
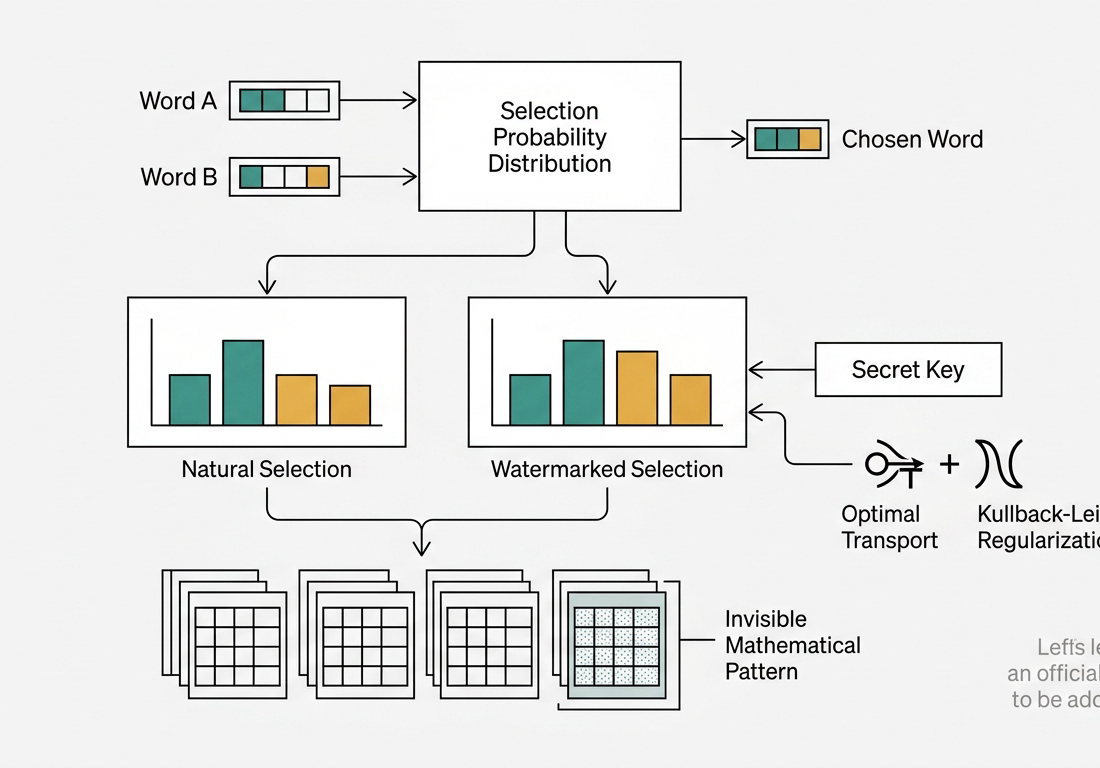
Ao longo de frases acumuladas, essas escolhas deixam uma assinatura estatística reconhecível por um detector programado com a chave correspondente. A tecnologia trabalha dividindo o vocabulário em blocos para reduzir o peso computacional, preservando a coerência das frases sem prejudicar a qualidade final.
Impacto para usuários e desenvolvedores
A implementação do textGrain não é universal e imediata em todos os produtos, dividindo-se entre a União Europeia e os clientes globais:
- Usuários do ChatGPT e Codex na União Europeia: ao longo das semanas seguintes a 5 de outubro de 2026, textos elegíveis criados por esses sistemas no bloco europeu passam a receber a marca invisível de forma automática.
- Desenvolvedores que utilizam a interface de programação (API): o recurso fica disponível em nível global para modelos selecionados sob regime de ativação voluntária (opt-in). A função permanece desligada por padrão e não se tornará padrão global no lançamento. Clientes podem ligar a marcação nas configurações de um projeto específico ou nas preferências gerais da organização.
- Modelo Astra: avaliações conduzidas no modelo de fronteira mais recente da organização não indicaram variações relevantes de desempenho com ou sem a marca d'água.
A desenvolvedora contextualizou a novidade oficial em publicação pública:
Estamos expandindo nossa abordagem de procedência de conteúdo para incluir texto em resposta a requisitos regulatórios da UE, ao mesmo tempo em que reconhecemos as limitações significativas da tecnologia atual de marca d'água em texto. Nossas ferramentas já ajudam a verificar se um arquivo de imagem ou áudio foi criado com nossos modelos. Este trabalho se baseia nesses esforços para ajudar as pessoas a entenderem melhor quando um conteúdo pode ter sido gerado ou editado com um modelo da OpenAI. Na UE, começaremos a aplicar marcas d'água em textos elegíveis do ChatGPT e do Codex nas próximas semanas para cumprir o EU AI Act. Clientes que utilizam nossa API podem ativar a marca d'água de texto para modelos selecionados em todo o mundo a partir de hoje.
A empresa integra essa técnica em uma abordagem multifacetada de procedência, que combina a marca estatística invisível com credenciais de conteúdo sob o padrão C2PA.
Limitações e eficácia da detecção
A identificação dessas marcas d'água depende do tamanho do trecho e do tipo de conteúdo. Em passagens mais curtas ou com vocabulário muito restrito, a assinatura perde força. A tabela abaixo resume as métricas observadas em avaliações com taxa de falsos positivos fixada em 1%:
| Parâmetro avaliado | Taxa de detecção da marca | Observações |
|---|---|---|
| Textos de 200 tokens (ex.: psicologia) | Cerca de 80% | Trechos curtos reduzem a quantidade de pistas |
| Textos de 400 tokens (ex.: psicologia) | Cerca de 95% | Desempenho comparável ou superior ao SynthID |
| Conteúdo de matemática | Substancialmente menor | Menor variedade de palavras reduz espaço para variação estatística |
| Alteração de 10% por sinônimos | Queda de cerca de 92% para 66% | Edições manuais parciais enfraquecem o sinal |
| Alteração de 25% por sinônimos | Redução para 17% | Edições profundas quase eliminam a detecção |
Acesso restrito e liberação de código
Como textos curtos e revisões posteriores reduzem a confiabilidade das verificações, a ferramenta de detecção não foi liberada abertamente para o público geral. As inscrições para avaliar o detector foram abertas prioritariamente para pesquisadores autorizados e organizações especializadas com casos de uso qualificados.
O plano anunciado estabelece que a tecnologia central do textGrain será disponibilizada em formato de código aberto, o que permitirá a outros especialistas reproduzir e aprimorar o sistema. Uma atualização do relatório técnico está prevista para as semanas seguintes com detalhes matemáticos adicionais. Ao transformar a própria dinâmica probabilística das palavras em um sinal identificável, o avanço busca equilibrar exigências legais e integridade técnica na rotina de quem gera ou lê conteúdos digitais.