
Clean-room é uma abordagem que controla o acesso a informações para permitir desenvolvimento ou colaboração com menor risco de uso indevido de conteúdo protegido. Na tecnologia, o termo aparece principalmente em dois contextos: reimplementação independente de software e ambientes protegidos de análise de dados.
Embora compartilhem a ideia de separação e controle, essas aplicações resolvem problemas diferentes. Entender a distinção ajuda a avaliar desde aplicativos apresentados como “clones feitos com IA” até plataformas que permitem cruzar informações de empresas.
O que significa clean-room no desenvolvimento de software?
Uma clean-room implementation, ou implementação em sala limpa, busca reproduzir funcionalidades de um sistema por meio de código desenvolvido de forma independente, com controles para evitar a incorporação de material protegido do programa original.
O objetivo pode ser construir um aplicativo compatível com determinado formato de arquivo, implementar um protocolo de comunicação ou substituir um componente proprietário.
A ideia central é documentar o comportamento necessário e criar uma implementação própria. Não basta trocar nomes de variáveis, traduzir código para outra linguagem ou pedir que uma IA reorganize um programa existente.
A expressão “sala limpa” descreve uma separação informacional. Não exige, necessariamente, uma sala física, mas envolve regras sobre quem pode acessar cada material e o que pode chegar aos responsáveis pela implementação.
Como funciona uma implementação clean-room?
O modelo clássico separa a análise do sistema original da construção do novo software. Um processo pode ser organizado em cinco etapas:
1. Definição do escopo e das fontes permitidas
A equipe determina quais comportamentos pretende reproduzir e quais fontes pode consultar: documentação pública, padrões técnicos, arquivos de teste e observações obtidas mediante acesso autorizado.
Também identifica restrições contratuais e materiais que não devem ser utilizados, como código vazado ou informações confidenciais de antigos empregadores.
2. Análise do comportamento
Um grupo estuda entradas, saídas, mensagens de erro e regras de funcionamento.
Por exemplo: ao investigar um formato de imagem, observa como o programa representa transparência, organiza camadas e interpreta determinadas estruturas do arquivo.
3. Produção de uma especificação funcional
As descobertas são convertidas em requisitos que descrevem o que o novo sistema precisa fazer.
Uma especificação pode indicar que determinado campo representa a largura de uma imagem. Ela não deve servir como veículo para transferir código protegido ou uma tradução disfarçada da implementação original.
4. Desenvolvimento independente
Outra equipe implementa os requisitos a partir dos materiais aprovados, sem acesso aos conteúdos excluídos pelo processo.
A separação entre equipes é uma forma clássica de reforçar a independência. Sua aplicação precisa considerar a natureza do projeto; não representa uma fórmula jurídica universal.
5. Testes e registro das decisões
A nova implementação é comparada com os comportamentos esperados. Histórico de alterações, fontes consultadas, revisões e testes ajudam a demonstrar como o trabalho foi produzido.
Essa rastreabilidade tem valor próprio. A política de direitos autorais do Samba, por exemplo, descreve o uso do Git para acompanhar a procedência das contribuições e exige declarações sobre o direito de submetê-las.
Clean-room é a mesma coisa que engenharia reversa?
Não. Os conceitos podem fazer parte do mesmo projeto, mas representam atividades diferentes.
| Conceito | O que significa |
|---|---|
| Engenharia reversa | Investigar um sistema existente para compreender sua estrutura ou seu funcionamento. |
| Implementação clean-room | Organizar o desenvolvimento independente com controle sobre as informações utilizadas. |
| Interoperabilidade | Permitir que sistemas troquem informações e utilizem os dados recebidos. |
| Reimplementação | Criar outra implementação de uma funcionalidade, interface ou sistema. |
Uma equipe pode usar engenharia reversa para produzir uma especificação, que depois orientará uma implementação clean-room. Também pode trabalhar somente com documentação pública, sem analisar internamente o software original.
A Electronic Frontier Foundation, em seu guia sobre engenharia reversa, explica que a avaliação jurídica envolve fatores como direitos autorais, contratos, segredos comerciais e mecanismos de proteção tecnológica.
Portanto, observar um aplicativo, descompilar seu executável e reutilizar trechos de código são ações diferentes, com implicações que não devem ser tratadas como equivalentes.
O que muda quando a inteligência artificial escreve o código?
A IA pode acelerar a implementação de requisitos, a criação de testes e a investigação de falhas. Entretanto, acrescenta uma questão ao processo: qual é a procedência do código gerado?
Um desenvolvedor consegue registrar os arquivos e instruções enviados ao modelo. Isso não significa que conheça integralmente os dados usados no treinamento desse modelo.
Além disso, ferramentas de programação podem produzir trechos semelhantes a código existente. A documentação do GitHub Copilot reconhece essa possibilidade e descreve mecanismos para identificar correspondências com repositórios públicos.
Esses mecanismos têm limites de cobertura. A ausência de uma correspondência detectada não equivale a uma certificação de originalidade.
Por isso, escrever “gere código original” ou “faça uma versão clean-room” no prompt expressa uma intenção, mas não demonstra que o processo foi independente.
O que um processo com IA precisa controlar?
Uma aplicação prática dos princípios de clean-room ao desenvolvimento assistido por IA envolve:
- Contexto fornecido: quais arquivos, especificações e exemplos chegaram ao modelo.
- Acesso dos agentes: quais repositórios, páginas e ferramentas estavam disponíveis.
- Separação de ambientes: impedir que materiais restritos apareçam no contexto de implementação.
- Registro de execução: preservar instruções, resultados e revisões relevantes.
- Revisão de procedência: verificar dependências, licenças e possíveis correspondências de código.
- Validação técnica: testar funcionalidade, segurança e compatibilidade separadamente.
Usar dois agentes de IA não cria, por si só, uma sala limpa. Se ambos acessam o mesmo material restrito, a separação é apenas nominal.
Da mesma forma, pedir a um modelo que transforme código proprietário em uma “especificação” não garante que a saída esteja livre de elementos protegidos.
Clean-room torna qualquer clone legal?
Não. Clean-room é uma abordagem de desenvolvimento e documentação; não é uma autorização geral para copiar produtos.
A criação independente pode ajudar a demonstrar a origem do código, mas não resolve automaticamente questões relativas a contratos, marcas, patentes, segredos comerciais ou elementos visuais protegidos.
Nos Estados Unidos, a seção 1201(f) do título 17 do Código dos EUA prevê uma exceção específica envolvendo engenharia reversa e interoperabilidade. Ela contém condições, incluindo acesso legítimo e necessidade das informações.
Não se trata de uma permissão irrestrita para contornar proteções ou reconstruir qualquer produto comercial.
No Brasil, o artigo 6º, inciso III, da Lei nº 9.609/1998 contempla determinadas semelhanças decorrentes de características funcionais, exigências técnicas ou limitação de formas alternativas de expressão.
Essa previsão também não transforma toda semelhança em uso permitido. A avaliação depende do material utilizado, do modo de obtenção, dos direitos envolvidos e da legislação aplicável.
O que significa data clean room?
Uma data clean room, ou sala limpa de dados, é um ambiente controlado no qual organizações podem colaborar em análises sem conceder acesso irrestrito às suas bases.
Aqui, o foco é proteger informações durante seu uso compartilhado.
Imagine um anunciante e um veículo de comunicação interessados em medir resultados de uma campanha. Um possui registros de vendas; o outro, informações de exposição aos anúncios.
Uma sala limpa de dados pode permitir uma análise autorizada e liberar resultados agregados, limitando a exposição dos registros individuais.
A proteção depende da arquitetura e das regras implementadas. O nome “clean room” não garante, sozinho, anonimização, ausência de vazamentos ou conformidade regulatória.
Quais controles podem ser utilizados?
Entre os mecanismos possíveis estão:
- Restrição de usuários, colunas e operações autorizadas.
- Aprovação prévia de consultas.
- Limites mínimos de indivíduos por resultado.
- Bloqueio de exportações individualizadas.
- Adição calibrada de ruído estatístico.
- Auditoria das operações e dos resultados liberados.
A documentação de privacidade do Google Ads Data Hub apresenta exemplos concretos, como verificações de agregação, limites de acesso e introdução de ruído nos resultados.
Esses controles também precisam considerar a combinação de consultas: resultados aparentemente inofensivos, quando cruzados, podem revelar informações que uma consulta isolada não mostraria.
Como as salas limpas de dados se relacionam com IA?
Na inteligência artificial, ambientes protegidos podem viabilizar treinamento, ajuste de modelos ou inferência com informações de diferentes organizações.
A documentação do Azure Confidential Clean Rooms descreve esses cenários e o uso de computação confidencial para proteger operações.
Uma das tecnologias envolvidas é o Trusted Execution Environment, ou ambiente de execução confiável. Ele oferece isolamento para o processamento e pode ser combinado com atestação, que permite verificar características do ambiente e do código executado.
Isso não elimina a necessidade de controlar as saídas. Proteger os dados durante o processamento e impedir que resultados revelem informações sensíveis são problemas relacionados, mas distintos.
Também é necessário verificar o estágio do serviço: a documentação citada estabelece restrições para sua oferta de análise multipartes em prévia limitada, incluindo uso em produção e processamento de dados sujeitos a exigências regulatórias.
Clean-room comprova qualidade ou equivalência?
Não. Procedência, compatibilidade e maturidade são dimensões diferentes.
Um software pode ter sido desenvolvido de forma independente e apresentar falhas. Pode abrir um formato de arquivo sem preservar todas as suas propriedades. Pode reproduzir uma interface sem entregar os mesmos resultados.
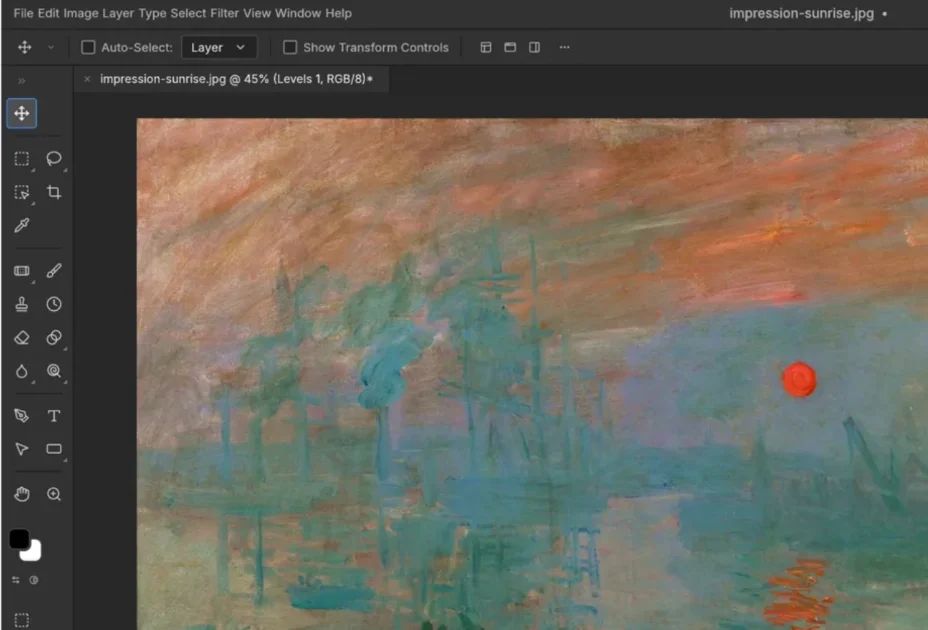
O PhotoCraft ilustra essa distinção: apresenta-se como uma reimplementação clean-room, mas informa que ainda está em estágio inicial e não substitui o Photoshop no trabalho profissional diário.
Além disso, a autodeclaração de um projeto não equivale a uma auditoria independente de seu processo.
Para avaliar uma proposta clean-room, a pergunta decisiva é: quais controles, registros e testes sustentam a afirmação? No desenvolvimento de software, a resposta deve demonstrar independência e procedência. Na colaboração com dados, deve esclarecer acesso, processamento e liberação de resultados.
Fontes e referências
- Electronic Frontier Foundation — Coders’ Rights Project: Reverse Engineering FAQ. Explicação dos aspectos jurídicos da engenharia reversa nos Estados Unidos.
- Samba — Copyright Policy. Política de procedência, titularidade e submissão de código.
- GitHub Docs — Referências a código público no Copilot. Correspondências entre sugestões geradas e código de repositórios públicos.
- Código dos Estados Unidos — 17 U.S.C. § 1201. Texto legal, disponibilizado pelo Legal Information Institute da Cornell, com a exceção de interoperabilidade na subseção (f).
- Câmara dos Deputados — Lei nº 9.609/1998. Legislação brasileira sobre proteção de programas de computador.
- Google for Developers — Privacy checks in Ads Data Hub. Controles de privacidade aplicados a consultas e resultados.
- Microsoft Learn — Azure Confidential Clean Rooms. Arquitetura, cenários de colaboração e restrições da oferta descrita.
- PhotoCraft — Repositório oficial. Descrição da implementação e declaração de maturidade do aplicativo.