
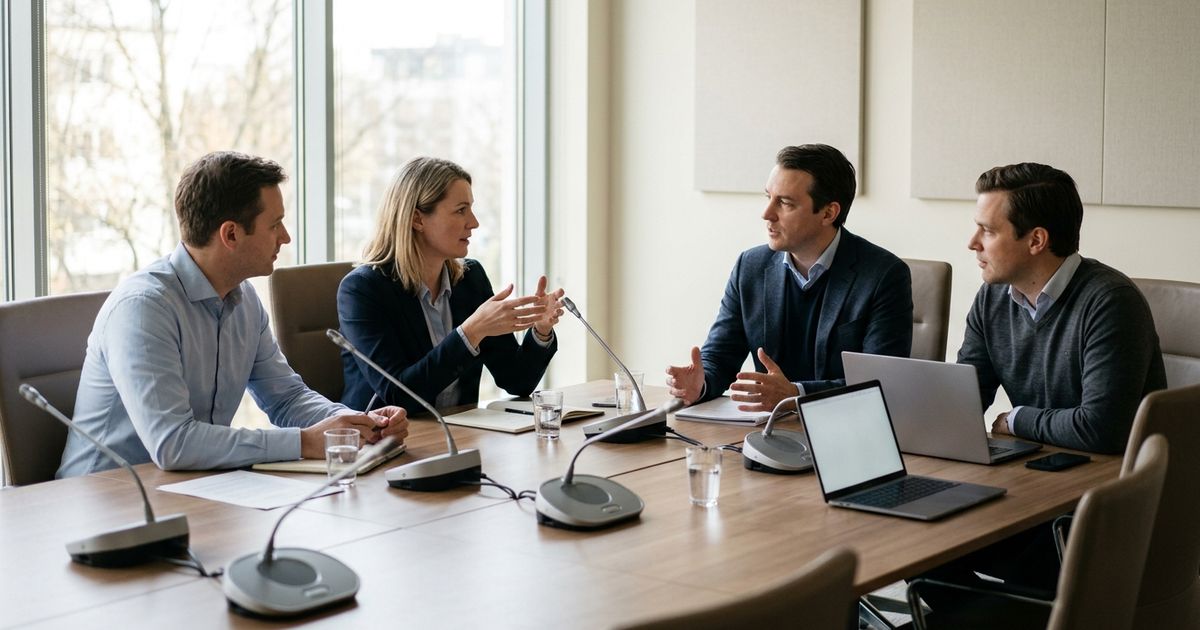
A Nvidia lançou em 23 de setembro de 2026 o Nemotron-3 Diarization (abre em nova aba), um modelo de inteligência artificial com pesos abertos voltado a responder uma pergunta comum em conversas: quem falou em qual momento. Embora a data oficial de lançamento seja 23 de setembro, detalhes e análises adicionais foram publicados nos dias 24 e 27 de setembro de 2026. A ferramenta é gratuita para uso comercial e pessoal e consegue distinguir até oito vozes diferentes, mesmo quando as pessoas falam por cima umas das outras.
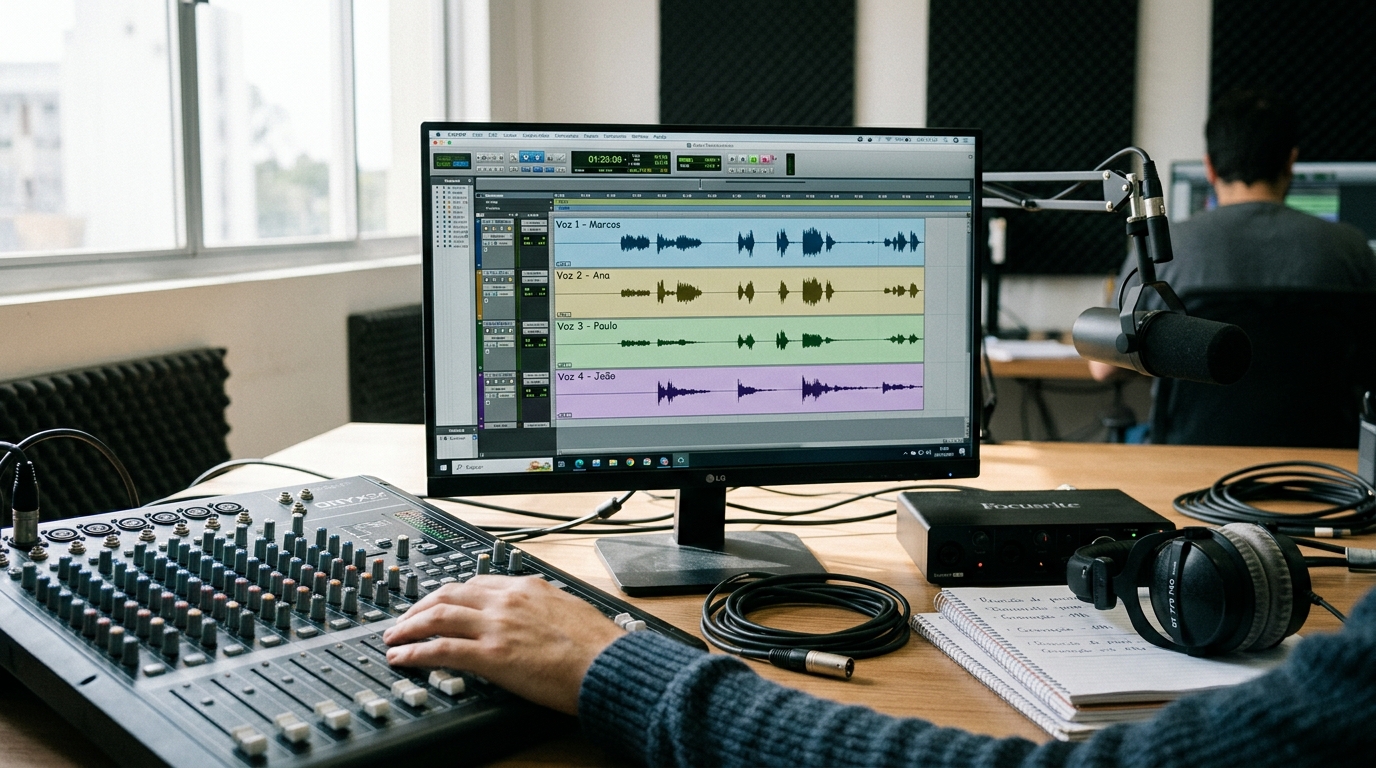
O processo de separar quem está falando em uma gravação recebe o nome técnico de diarização de áudio. É como se a tecnologia atuasse como um secretário em uma reunião movimentada: em vez de apenas ouvir o som como um bloco único, o modelo coloca uma etiqueta em cada participante para registrar o instante exato em que cada voz começou e terminou.
Na ocasião do anúncio oficial em 23 de setembro de 2026, a equipe da Nvidia AI destacou nas redes sociais o objetivo de organizar conversas caóticas:
Quando várias pessoas falam ao mesmo tempo, uma transcrição pode ficar confusa rapidamente. Nosso novo modelo Nemotron 3 Diarization rastreia quem falou quando, mesmo quando as vozes se sobrepõem. Ele lida com até oito falantes, tem 100M de parâmetros e já está disponível no @huggingface 🤗
Como a tecnologia funciona
Para entender o modelo, pense em uma fila de atendimento onde cada novo visitante recebe um crachá de identificação de acordo com a ordem de chegada. O Nemotron-3 Diarization faz algo semelhante com o som. Baseado na arquitetura Sortformer, ele organiza os canais de resposta conforme as vozes aparecem no áudio.
O sistema recebe áudio monofônico gravado a 16 kHz e calcula as probabilidades de fala a cada 10 milissegundos. Para que o modelo não se perca quando alguém faz uma pausa ou é interrompido, ele adota dois componentes especiais herdados do Streaming Sortformer:
- Arrival-Order Speaker Cache (AOSC): uma memória temporária que guarda a identidade da voz entre os blocos de áudio.
- Fila FIFO: uma estrutura de dados de entrada e saída rápida que mantém o contexto sonoro recente para que o mesmo participante não receba um crachá diferente ao voltar a falar.
Graças a esse processamento em pedaços contínuos, as gravações longas não têm limite fixo de duração.
Desempenho e precisão
Na avaliação Diarization-Bench da plataforma VoiceArena, com 139 conversas em inglês totalizando cerca de 22 horas, o Nemotron-3 alcançou o primeiro lugar entre 12 sistemas testados. A métrica padrão do setor é a Taxa de Erro de Diarização (conhecida pela sigla DER, onde pontuações menores indicam melhor desempenho).
| Cenário de Teste | Taxa de Erro (DER) | Observações |
|---|---|---|
| VoiceArena Diarization-Bench | 14,72% | Primeiro lugar (o segundo melhor sistema obteve 19,3%) |
| Teste DIHARD III (1 a 4 falantes) | 9,13% | Alta precisão com poucos participantes |
| Teste DIHARD III (5 a 9 falantes) | 27,58% | Aumento de erros com grupos maiores |
| Transmissão ao vivo (buffer de 0,32 s) | 13,55% | Modo em tempo real |
| Modo offline (buffer de 30,4 s) | 12,73% | Processamento após a gravação |
Em oito cenários avaliados com intervalo de 1,04 segundo, o novo sistema reduziu a taxa de erro em uma média de 41% em comparação direta com o seu antecessor, o Streaming Sortformer. A precisão, no entanto, pode cair diante de ruído de fundo excessivo, reverberação no ambiente ou grupos muito numerosos.
Vantagens do tamanho compacto e requisitos
O Nemotron-3 Diarization foi projetado com 99,2 milhões de parâmetros (aproximadamente 100 milhões). Em inteligência artificial, parâmetros são como as engrenagens internas de um mecanismo: modelos com bilhões de engrenagens exigem computadores gigantescos, enquanto modelos compactos rodam com agilidade surpreendente.
Com esse tamanho reduzido, o modelo atinge velocidade até 15.113 vezes superior ao tempo real em processamento em lote de 32 itens em uma placa gráfica moderna. Ele exige o sistema operacional Linux e opera por meio da biblioteca NVIDIA NeMo, sendo compatível com placas de arquitetura Ampere, Ada Lovelace, Hopper ou Blackwell.
O modelo permite configurar o atraso de resposta (chamado de latência do buffer) em quatro níveis recomendados:
- 30,4 segundos: voltado para arquivos salvos e trabalhos em lote offline.
- 1,04 segundo: equilíbrio intermediário de processamento.
- 0,64 segundo: transmissão acelerada.
- 0,32 segundo: recomendação oficial para legendagem e transmissões ao vivo. Em casos críticos de baixa latência, o sistema suporta entradas a partir de 80 milissegundos.
Licença e casos de uso no dia a dia
Os pesos da tecnologia estão publicados na plataforma Hugging Face sob os termos da licença OpenMDW 1.1, que autoriza formalmente a exploração comercial e o uso em projetos de código aberto.
Na prática, o modelo não identifica nomes de pessoas por conta própria; ele apenas rotula os participantes como vozes anônimas, a exemplo de "falante 1" ou "falante 2". Quando integrado a sistemas de reconhecimento de voz, como o Parakeet, ele viabiliza a criação de transcrições completas para chamadas de vídeo, reuniões corporativas e geração de legendas em tempo real com indicação precisa de quem está falando.