

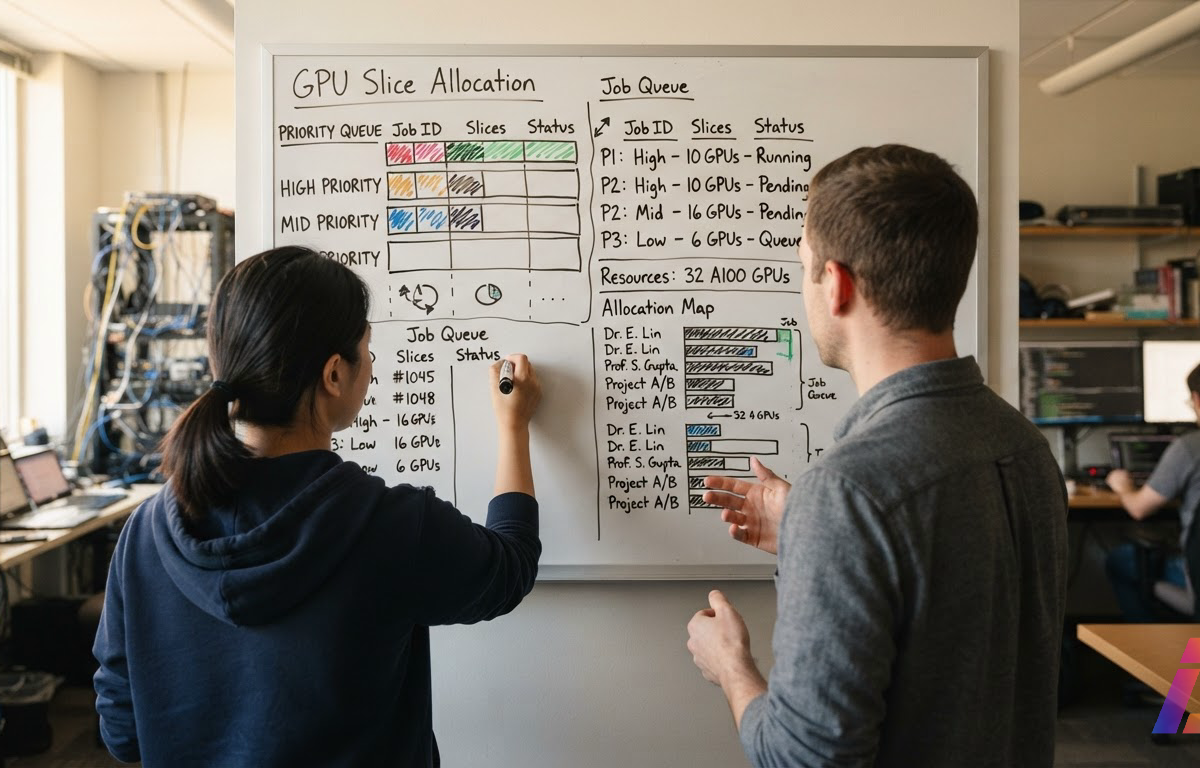
Em 13 de outubro, a NVIDIA (abre em nova aba) publicou como código aberto a plataforma completa do Run:ai (abre em nova aba). O Run:ai controla quem usa as GPUs de uma empresa, quando e em que fatia. GPUs são os chips caros que treinam e rodam modelos de IA. O código está no GitHub (abre em nova aba) sob a licença Apache 2.0 (abre em nova aba), que permite ler, modificar, copiar e usar comercialmente. Para colocar a plataforma inteira em produção, não é mais preciso pagar assinatura. O suporte da NVIDIA continua sendo vendido à parte.
Isso tem cara de generosidade, mas a NVIDIA não está abrindo mão de nada que lhe faça falta. Ela está escolhendo onde cobrar.
O que o Run:ai faz
Em empresas, laboratórios e universidades, várias equipes disputam as mesmas GPUs. Quando não há regra, umas placas ficam paradas enquanto outras têm fila. O Run:ai funciona sobre o Kubernetes (abre em nova aba), o sistema que muitas organizações usam para administrar conjuntos de servidores. O repositório faz questão de deixar claro que ele não substitui o Kubernetes. Ele acrescenta o que falta ao Kubernetes no trato com GPUs: prioridades, divisão justa entre equipes, interrupção de tarefas menos urgentes e encaixe das cargas para aproveitar cada máquina.
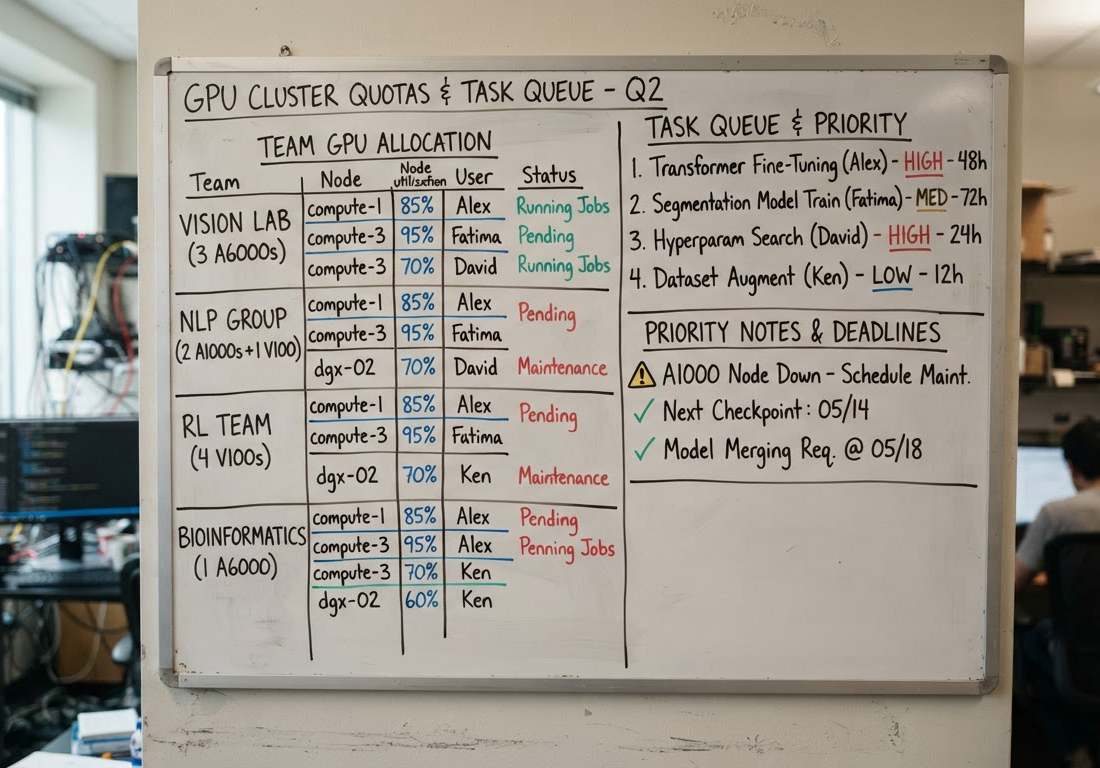
Também tem um painel central para administrar um ou vários clusters, que são grupos de servidores. O acesso é por interface web, linha de comando ou API. Há ainda um servidor MCP, que expõe as operações da plataforma como ferramentas para assistentes de IA. Na prática, um assistente pode ser conectado para consultar e operar a infraestrutura.
O que foi liberado agora
Em abril de 2025, a NVIDIA já tinha aberto o KAI Scheduler, o agendador que ela mesma chamou de "motor" do Run:ai. A novidade de outubro é a plataforma inteira. Segundo o TechRepublic, isso inclui o painel de controle hospedado pelo próprio usuário, e não só peças soltas de agendamento. O pacote faz parte da NVIDIA DSX AI Factory, a linha da empresa para os chamados "data centers de IA". Quatro componentes podem ser usados separadamente:
| Componente | O que faz, em linguagem simples |
|---|---|
| KAI Scheduler | Decide a ordem e o lugar de cada tarefa. Só inicia um trabalho dividido em várias partes quando todas cabem ao mesmo tempo. Também reparte o uso de GPU de forma justa ao longo do tempo e considera como as máquinas estão conectadas fisicamente. |
| GPU Fractioning Operator | Divide uma única GPU entre várias tarefas, com limite rígido de memória para cada uma, aplicado pelo próprio driver da NVIDIA. |
| KAI Resource Management | Cria cotas e regras por projeto, departamento e grupo de máquinas. No exemplo da NVIDIA, a regra garante 50% do cluster para a equipe de pesquisa. |
| Workload Map | Quarto componente listado pela empresa. |
O KAI Scheduler também foi doado à CNCF, a fundação que cuida do Kubernetes. Lá ele entrou como projeto Sandbox, a categoria de entrada.
Por que a NVIDIA está dando isso de graça
Há dois detalhes do anúncio que explicam a decisão melhor do que o texto oficial.
O primeiro é técnico. A divisão de GPUs agora usa o CUDA 13.4, a plataforma de software da própria NVIDIA, e a implementação proprietária anterior foi aposentada. A peça que ficou aberta, portanto, depende ainda mais do ecossistema da empresa. De acordo com o MarkTechPost, a plataforma roda em Kubernetes ou OpenShift com GPUs NVIDIA.
O segundo é comercial. As versões pagas continuam existindo. O Run:ai segue vendido como produto independente, embutido no NVIDIA Mission Control e no NVIDIA AI Enterprise, e em marketplaces de nuvem. Preço, licença e suporte variam conforme o canal. A NVIDIA também apresentou oito parceiros da DSX: Crusoe, Mirantis, Nebius, OpenNebula Systems, Rafay, Saturn Cloud, Spectro Cloud e vCluster. São provedores de nuvem e de infraestrutura que agora podem montar seus serviços em cima desse código.
Minha leitura: a NVIDIA deixa de usar a assinatura como barreira de entrada para que o Run:ai vire o jeito padrão de gerenciar GPUs no Kubernetes. Quando o software que reparte os chips é gratuito, aberto e feito pelo fabricante dos chips, a conversa sobre usar hardware de outra marca fica mais difícil. A receita continua vindo das placas e do suporte.
As letras miúdas
Aberto depende de onde você baixa. O código no GitHub está sob Apache 2.0, conforme o arquivo NOTICE do repositório. A versão empacotada no catálogo NGC da NVIDIA, chamada Community Product e instalada por Helm chart, segue outra regra. Para baixá-la, é preciso aceitar o Contrato de Licença de Software da NVIDIA e os Termos Específicos de Produto. É um contrato diferente da Apache 2.0, e convém ler antes de clicar.
Sem suporte, o problema é seu. A edição comunitária não inclui suporte empresarial da NVIDIA. O TechRepublic resume: quem usa a versão gratuita cuida sozinho da infraestrutura, das atualizações e das falhas. O NOTICE reforça que o software é entregue "no estado em que se encontra", sem garantias, e que traz componentes de terceiros com licenças próprias.
Não há números. Segundo o MarkTechPost, a NVIDIA não publicou nenhum teste de desempenho da plataforma como um todo para este lançamento. A promessa de aproveitar melhor as GPUs é plausível, mas ninguém mediu publicamente quanto se ganha com esta versão.
O que muda para quem lê
Para quem já paga pelo Run:ai, a pergunta mudou. Antes era "vale a assinatura?". Agora é "vale o suporte?". O software deixou de ser o que está sendo comprado.
Para uma startup, um laboratório ou uma universidade que divide poucas GPUs entre várias equipes, é possível testar sem contrato. Pelo relato do MarkTechPost, o ambiente de desenvolvimento local cria um cluster de cinco máquinas com oito GPUs Tesla A10 simuladas, então não é preciso ter GPU de verdade para experimentar. As exigências, porém, não são de notebook básico:
- macOS ou Linux, em processadores amd64 ou arm64; Windows não é suportado;
- no Linux, 4 CPUs, 16 GB de RAM e 100 GB de disco;
- no macOS com máquinas virtuais Podman, pelo menos 12 GB de RAM;
- cerca de 50 serviços para compilar, e aproximadamente 44 GB de arquivos temporários após uma compilação completa.
Para quem não tem ninguém dedicado a infraestrutura, a versão gratuita não sai de graça. O custo que antes estava na assinatura passa para o salário de quem vai instalar, atualizar e resolver problemas.
Perguntas frequentes
Preciso ter GPUs da NVIDIA para usar o Run:ai?
Para uso real, sim. Segundo o MarkTechPost, a plataforma roda em Kubernetes ou OpenShift com GPUs NVIDIA. Para testar, o ambiente local usa GPUs simuladas.
É gratuito mesmo?
O código é, sob Apache 2.0, e não exige assinatura para ir para produção. O suporte empresarial é pago, e a versão empacotada no NGC exige aceitar um contrato de licença da NVIDIA.
Isso afeta quem só usa ferramentas de IA no trabalho, como chatbots?
Não diretamente. O Run:ai é para quem opera a própria infraestrutura de GPUs, como equipes de TI, provedores de nuvem e grupos de pesquisa com servidores próprios.