

Dividir placas de vídeo entre equipes de inteligência artificial é um trabalho invisível até a fila de espera aparecer. Em 13 de outubro de 2026, a NVIDIA anunciou que o NVIDIA Run:ai (abre em nova aba), o sistema que a empresa vende justamente para organizar esse tipo de disputa, passa a ser distribuído como código aberto, dentro da plataforma DSX AI Factory.
O que o Run:ai faz, em termos simples. Empresas e centros de pesquisa costumam ter um conjunto finito de GPUs, unidades de processamento especializadas em IA, compartilhado por vários grupos: um treina modelos, outro testa, um terceiro responde a usuários. Sem um coordenador, essa divisão se resolve por planilha ou conversa. O Run:ai se instala sobre o Kubernetes, um software que organiza aplicações em contêineres, pacotes padronizados de programa, em vários servidores, e acrescenta regras para GPUs: fila com prioridades, cotas por equipe, acompanhamento do uso e divisão de uma mesma placa entre trabalhos simultâneos. O controle acontece por interface web, linha de comando ou API REST, o canal pelo qual programas conversam com o sistema.
O que foi aberto
Segundo o anúncio da NVIDIA, o código completo da plataforma está reunido em um único repositório público, o dsx-ai-factory/run-ai (abre em nova aba). Ele contém o plano de controle, a parte central que administra recursos e recebe pedidos de trabalho, os serviços que rodam em cada cluster, o instalador, a linha de comando, a documentação e um servidor MCP, um serviço que permite que assistentes de IA interajam com a plataforma.
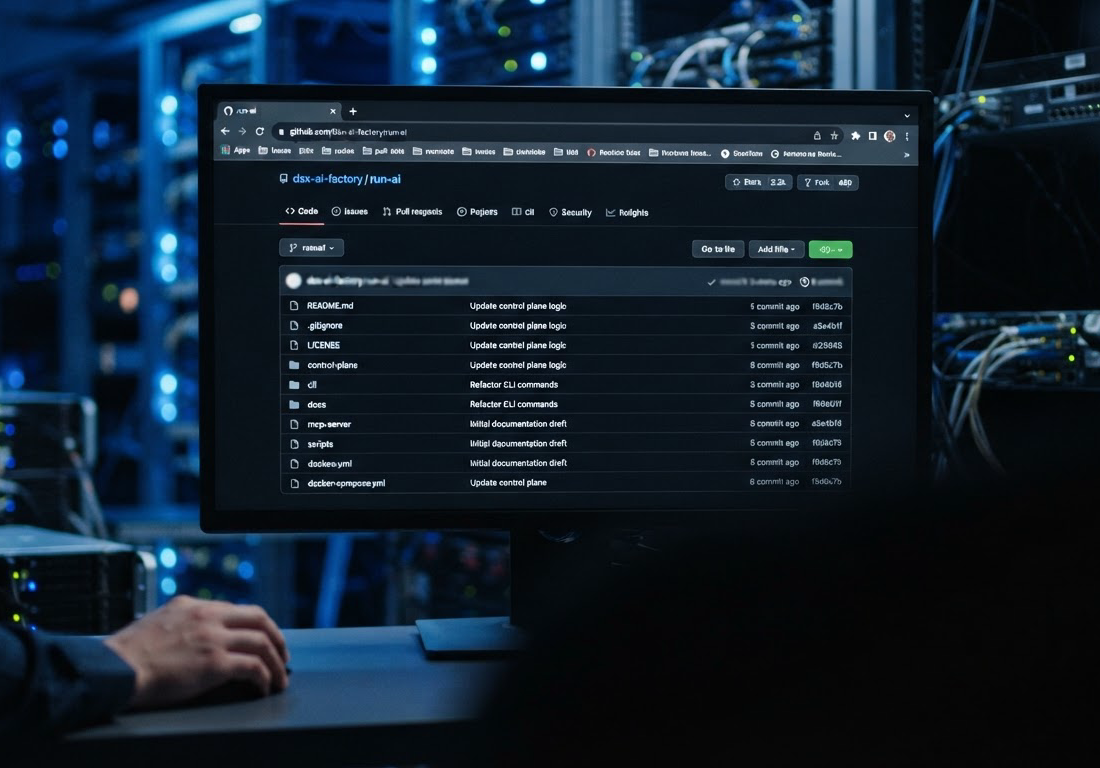
Quatro componentes do conjunto também podem ser adotados de forma independente: o KAI Scheduler, que faz o agendamento dos trabalhos; o GPU Fractioning Operator, que divide GPUs; o KAI Resource Management, que administra os recursos; e o Workload Map, publicado em repositório próprio, o dsx-ai-factory/karta (abre em nova aba).
Para quem prefere pacote pronto, a plataforma completa também aparece na NVIDIA NGC, o catálogo de softwares da própria empresa, na categoria Community Product, acompanhada de um gráfico Helm, ou seja, um pacote de instalação pronto para Kubernetes. Há uma condição nesse canal: o download exige aceitar o acordo de licença de software da NVIDIA e os termos específicos para produtos de IA da companhia.
A licença e suas bordas
O código é licenciado sob a Apache 2.0, uma licença aberta que permite usar, modificar e até vender o software, desde que os avisos de licença originais sejam mantidos. O arquivo NOTICE do repositório registra os direitos autorais de 2026 da NVIDIA Corporation & Affiliates e deixa claro que o software é distribuído no estado em que se encontra, sem garantias, expressas ou implícitas.
A licença cobre o código, não a marca. Nomes, logotipos, fontes e elementos visuais da NVIDIA e do Run:ai continuam reservados, e a Apache 2.0 não concede permissão para usá-los. Componentes de terceiros embarcados no projeto seguem suas próprias licenças, entre elas a MIT e a própria Apache 2.0, além de uma licença de atribuição (CC-BY-4.0) aplicada à pasta de skills do projeto, um tipo de conteúdo instrucional que acompanha o repositório.
O fim do fracionamento fechado
Fracionar uma GPU significa dividir uma placa entre trabalhos que rodam ao mesmo tempo, com limites de memória para cada um. O anúncio informa que o GPU Fractioning Operator substitui uma implementação proprietária, agora aposentada, por um fracionamento nativo do CUDA 13.4, a camada de software da NVIDIA que faz a ponte entre o sistema operacional e as GPUs. Nesse modelo novo, é o próprio driver CUDA que impõe um limite rígido de memória por carga de trabalho, o que reduz a chance de um trabalho invadir a memória de outro.
O KAI Scheduler, motor de fila do conjunto, segue a mesma Apache 2.0 e foi doado pela NVIDIA ao CNCF, a fundação que abriga o Kubernetes, como projeto de estágio Sandbox, o ponto de entrada para projetos novos da entidade.
Quem já paga, o que muda
Nada obriga os clientes atuais a abandonar a versão paga. A documentação oficial (abre em nova aba) do produto descreve dois caminhos paralelos, e as diferenças entre eles são concretas:
| Caminho | Custo de licença | Suporte da NVIDIA |
|---|---|---|
| Código no GitHub ou Community Product na NGC | Nenhum (no NGC, mediante aceite dos termos) | Não incluído |
| Support-Entitled Release | Contrato comercial | Incluído, mediante contrato |
| Pacotes empresariais | Contrato comercial | Conforme a oferta |
O anúncio detalha as vias comerciais: para implantações no NVIDIA Enterprise AI Factory, o Run:ai segue disponível como produto independente, dentro do Mission Control e do NVIDIA AI Enterprise, e por marketplaces de nuvem selecionados. Os termos de disponibilidade, licenciamento e suporte variam conforme a oferta escolhida. Em outras palavras, o software livre substitui a necessidade de assinatura para quem consegue operar sem suporte, mas não encerra o negócio que dependia de contrato.
Requisitos e limites declarados
A instalação exige Kubernetes ou OpenShift, uma distribuição corporativa do Kubernetes. Funciona tanto em ambientes conectados à internet quanto em redes isoladas, situação chamada de air-gapped, comum em instituições que não podem expor sua infraestrutura. Há dois caminhos de instalação: o instalador guiado por linha de comando, chamado runai-installer, ou o Helm manual. As imagens de contêiner e os gráficos Helm prontos são publicados em nvcr.io/nvidia/runai.
Os limites também estão escritos. O próprio repositório avisa que os comandos de construção na raiz são marcadores de posição, ou seja, os comandos reais de compilação e teste moram dentro de cada diretório de serviço. O projeto não publica um roteiro de recursos de longo prazo. E o Run:ai não substitui o Kubernetes, o sistema de execução de contêineres nem ferramentas de integração contínua; ele adiciona capacidades a esses elementos. O fracionamento, por fim, depende do driver CUDA 13.4, tecnologia da própria NVIDIA.
O quadro maior
O movimento não nasceu ontem. Em junho de 2026, a NVIDIA já havia descrito a DSX OS (abre em nova aba), um conjunto de softwares abertos e modulares para operar o que a empresa chama de fábricas de IA, ambientes dedicados a treinar e executar modelos em escala. Naquela ocasião, a NVIDIA afirmou que constrói e opera infraestrutura na sua nuvem DGX e que libera esse software para que parceiros usem os componentes em vez de reconstruí-los. O texto de junho citava o KAI Scheduler e o Run:ai para alocação de trabalhos com reconhecimento de GPU, cotas hierárquicas e fracionamento, mas ainda não afirmava que o código completo da plataforma estava publicado. Esse passo veio agora.
O anúncio de outubro lista os parceiros que já integram o lançamento: Crusoe, Mirantis, Nebius, OpenNebula Systems, Rafay, Saturn Cloud, Spectro Cloud e vCluster. São empresas de nuvem e de plataformas de infraestrutura, o que sugere que o código aberto pretende circular no ecossistema, e não apenas nos servidores da NVIDIA.
Para quem opera um pequeno conjunto de GPUs, o efeito prático é direto. Uma equipe hipotética de quatro cientistas que dividia oito placas por planilha pode hoje baixar o mesmo software que antes só se obtinha por contrato. O que muda de figura é a responsabilidade: com o software livre, a pergunta deixa de ser quanto custa o Run:ai e passa a ser quem assume o plantel quando a fila engargalar, e essa resposta depende do caminho, aberto ou com suporte, que cada organização escolher.
Perguntas frequentes
O Run:ai open source é gratuito?
O código sob Apache 2.0 não exige assinatura paga, e a NVIDIA informa que o Community Product na NGC não requer assinatura nem direito a suporte. Para baixar pela NGC, porém, é preciso aceitar o acordo de licença de software da NVIDIA e os termos específicos para produtos de IA.
Preciso ter GPUs da NVIDIA para usar?
O fracionamento de GPU anunciado depende do driver CUDA 13.4, que é tecnologia da NVIDIA, e sem esse driver esse recurso específico não existe. As fontes não descrevem a plataforma operando com GPUs de outros fabricantes.
Quem já paga pelo Run:ai perde o produto?
Não. Para implantações no NVIDIA Enterprise AI Factory, o Run:ai segue disponível em ofertas comerciais com suporte da NVIDIA: como produto independente, dentro do Mission Control e do NVIDIA AI Enterprise, e por marketplaces de nuvem selecionados.
Dá para instalar sem internet?
Sim. A documentação do repositório indica instalação em Kubernetes ou OpenShift tanto em ambientes conectados quanto em redes isoladas (air-gapped), pelo instalador guiado runai-installer ou pelo Helm manualmente.