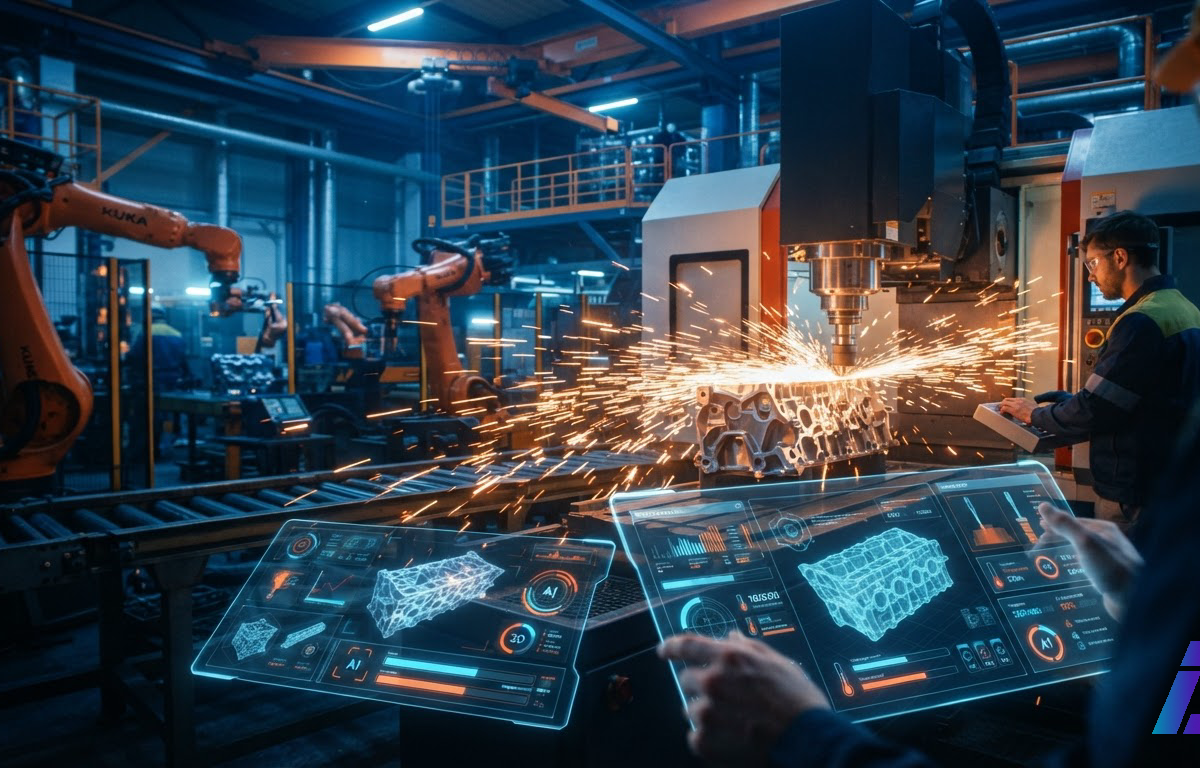
Quanto tempo leva para programar a usinagem de uma peça de carro na linha de montagem? Segundo dados divulgados pela gigante chinesa Alibaba (abre em nova aba) nesta segunda-feira (16), esse trabalho manual caiu de 475 minutos, quase oito horas, para 24 minutos com o uso do Qwen4-Max (abre em nova aba), seu novo modelo principal de inteligência artificial. Liberado para o público geral após uma prévia restrita iniciada no dia 11, o sistema chega com a alegação da fabricante de reduzir em até 62% o custo médio de tarefas profissionais complexas em relação à geração anterior, embora testes externos já apontem lentidão em parte das respostas.
Os exemplos apresentados pela empresa mostram uma mudança de foco: sair das conversas rápidas de chat para assumir projetos longos no trabalho. Em um caso demonstrado para o setor financeiro, o programa acionou 90 ferramentas externas para entregar planilhas prontas em Excel e relatórios em PowerPoint. Na criação de uma página educativa de física, um novo recurso de entrega contínua gerou uma primeira versão funcional e aplicou 14 rodadas de ajustes pedidos pelo usuário até incluir animações em 3D. Em laboratório, o sistema operou sozinho por 48 horas seguidas, filtrou 2,7 milhões de moléculas candidatas e ajudou a sintetizar um novo fluido de resfriamento. São vitrines oficiais da fabricante, não uma garantia de que qualquer escritório terá o mesmo corte de tempo.
Como um modelo gigante gasta menos
O segredo para reduzir a conta está no que permanece desligado. Na inteligência artificial, a capacidade de um modelo é medida em parâmetros, as conexões internas que guardam o que o computador aprendeu no treinamento. O Qwen4-Max possui 2,4 trilhões de parâmetros principais, somados a 328 bilhões dedicados a tabelas de consulta rápida.
Em vez de mover toda essa estrutura pesada a cada pergunta, a Alibaba atualizou a arquitetura conhecida como mistura de especialistas (MoE, na sigla em inglês). O programa divide o próprio cérebro em pequenas equipes especializadas e ativa apenas 71 bilhões de parâmetros para cada token processado, que é a unidade básica de cobrança e leitura da IA, equivalente a um pedaço de palavra ou fração de imagem. Isso representa 25% menos conexões ativadas por vez do que no antecessor Qwen3.8-Max, que tinha o mesmo tamanho total de 2,4 trilhões. O modelo conta ainda com visão nativa, entendendo textos, fotos e vídeos diretamente, e uma janela de contexto de 1 milhão de tokens, a memória de curto prazo necessária para analisar livros inteiros ou longos vídeos de uma só vez.
No anúncio oficial publicado no X, a equipe responsável pelo projeto detalhou a queda nos preços de uso e as áreas profissionais atendidas pela ferramenta:
Conheça o Qwen4-Max, seu novo colega de equipe de IA para trabalho, criatividade e descoberta! O Qwen4-Max foi construído sobre uma nova arquitetura MoE com visão nativa e uma janela de contexto de 1 milhão de tokens. Destaques: supera o Qwen3.8-Max com até cerca de 50% menos tokens, enquanto o custo médio por tarefa cai mais de 60% em nossa avaliação interna; avança na produtividade do mundo real por meio de maior domínio de ferramentas profissionais, execução mais forte de longo prazo e entregas de maior qualidade; lida com tarefas reais, incluindo modelagem 3D, desenvolvimento de jogos, manufatura, finanças, direito, saúde e descoberta científica de ponta; US$ 1,5 por milhão de tokens de entrada, US$ 4,5 por milhão de tokens de saída e US$ 0,075 por milhão de tokens para cache implícito, todos menores que no Qwen3.8-Max, com queda de 70% no cache implícito. A API está ativa no QwenCloud. Você também pode testar o Qwen4-Max no Qwen Studio, QwenWork e Qoder. Comece a construir hoje! Mais novidades em breve.
Economia na ponta do lápis e testes divergentes
À primeira vista, a combinação de tarifas menores com economia de palavras coloca a empresa chinesa em vantagem direta contra os principais concorrentes ocidentais. No Work360, bateria de testes criada pela própria Alibaba com tarefas de 721 áreas profissionais, o modelo gastou 35% menos tokens no modo de raciocínio intenso, derrubando o custo médio por tarefa de US$ 4,43 para US$ 1,67 (ou de 26,58 para 11,16 yuans nos dados em moeda chinesa). Na cobrança direta por milhão de tokens na plataforma QwenCloud (abre em nova aba), a diferença para os modelos rivais listados na mesma semana é expressiva:
| Modelo de IA | Custo de entrada (1 milhão de tokens) | Custo de saída (1 milhão de tokens) |
|---|---|---|
| Qwen4-Max (Alibaba) | US$ 1,50 | US$ 4,50 |
| Claude Fable 5.2 | US$ 8,00 | US$ 40,00 |
| GPT-6 Astra | US$ 10,00 | US$ 50,00 |
Quando se olha para avaliações feitas fora dos laboratórios da fabricante, o entusiasmo encontra limites claros. A Alibaba destaca que o sistema alcançou o sexto lugar no ranking de programação Code Arena, liderou testes de agentes jurídicos contra o rival Kimi K3.1 e superou o Claude Opus 5.5 em entregas profissionais longas. Já as medições independentes compiladas pelo portal DataCamp (abre em nova aba) mostram um desempenho mais modesto: o Qwen4-Max aparece em nono lugar no ranking Artificial Analysis e em décimo primeiro na consultoria Vals. Avaliadores externos descrevem o modelo como lento e prolixo, apontando que ele fica bem atrás do Kimi K3.1, do Claude Opus 5.5 e da linha GPT-6 em programação de terminal e na interpretação de gráficos e vídeos.
Tem também divergência dentro da própria documentação técnica da Alibaba sobre o limite de escrita do modelo. Enquanto a página principal do QwenCloud informa que o sistema entrega até 393 mil tokens por resposta, o manual da interface para programadores (API) registra um teto de 131.072 tokens em respostas diretas e de 262.144 tokens somando o raciocínio interno e o texto final.
Para quem pretende usar a novidade agora, o acesso funciona apenas pela nuvem da empresa, via assinatura Token Plan ou cobrança por uso na API, e dentro dos aplicativos QwenWork (abre em nova aba), Qwen Studio e Qoder. Ao contrário do Qwen3.8, que teve o código aberto em agosto, o Qwen4-Max possui pesos fechados, o que impede baixar o programa para rodar em computadores próprios. A companhia prometeu liberar gratuitamente versões menores da família Qwen4 para desenvolvedores em breve e adiantou que a futura geração Qwen 5 deve crescer para a faixa de 5 trilhões a 10 trilhões de parâmetros.