
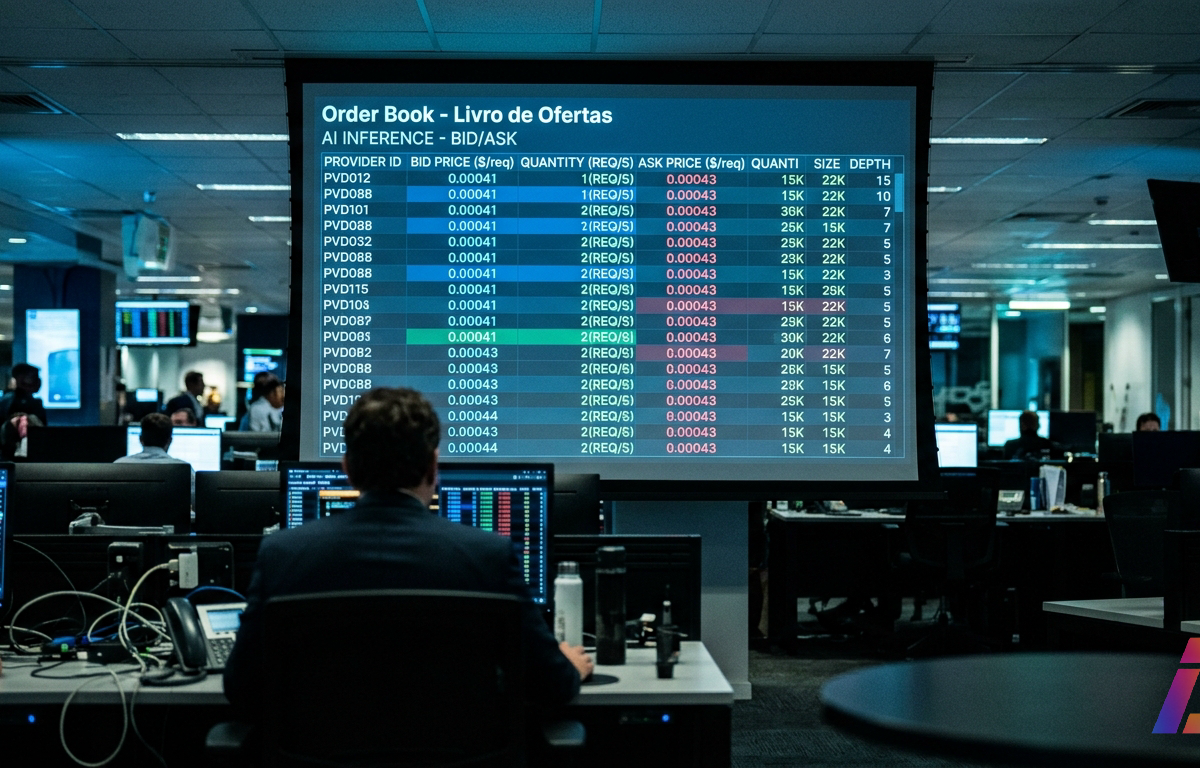
Quem contrata acesso a um modelo de linguagem costuma seguir um roteiro conhecido: escolhe um fornecedor, aceita o preço praticado por ele e paga pelo que consumir. A Architect Financial Technologies (abre em nova aba), empresa sediada em Chicago, anunciou em 7 de outubro de 2026 uma plataforma que propõe trocar esse roteiro por outra lógica. Em vez de preço fixo, um leilão em tempo real para cada requisição.
O produto se chama Liquid Inference e está disponível em inference.ai.exchange (abre em nova aba). Na plataforma, provedores de inferência publicam ofertas concorrentes para rodar modelos de linguagem. Inferência, aqui, é o momento em que o modelo gera a resposta a partir de um pedido, seja um texto pedido a um chat, seja uma tarefa de programação. Cada requisição é disputada em leilão, e vence a oferta de menor preço que respeite as regras definidas pelo comprador.
A inspiração vem do mercado financeiro. Segundo a empresa, o Liquid Inference aplica à inferência de IA princípios de estrutura de mercado usados em negociações de derivativos regulados, ambiente de origem da própria Architect. Uma das heranças mais visíveis é o livro de ofertas: o site publica em tempo real as cotações de cada provedor para cada modelo, além das transações já liquidadas, visíveis a quem tem conta na plataforma.
Como funciona o leilão de cada requisição
O fluxo descrito pela empresa tem quatro etapas:
- Requisição: o cliente envia uma chamada padrão no formato das APIs da OpenAI ou da Anthropic, as duas interfaces mais comuns para acessar modelos de linguagem.
- Regras: as restrições do comprador filtram quais ofertas podem concorrer.
- Leilão: todos os provedores que oferecem aquele modelo competem, e a menor oferta qualificada vence.
- Recibo: o preço máximo é travado antes de qualquer resposta ser gerada.
A cobrança acontece só pelo uso medido, ou seja, pela quantidade de texto efetivamente processada, e não por uma taxa fixa de acesso. Cada trabalho gera um recibo fixo com quatro informações: o provedor vencedor, o teto de preço acordado, o valor final cobrado e a profundidade da concorrência no momento da premiação, que mostra quantas ofertas estavam na disputa.
Um detalhe técnico importa para quem usa IA em produção. O preço é travado antes da geração do primeiro token. Token é a unidade em que os modelos de linguagem dividem o texto, e o tempo até o primeiro token é uma das medidas usadas para avaliar a velocidade de resposta de um serviço.
O que o comprador pode exigir
As regras disponíveis cobrem quatro frentes: custo, desempenho, localização e privacidade. Segundo o anúncio oficial, o comprador pode vincular a qualquer requisição os seguintes critérios:
- Limite de custo por tarefa, para nenhum trabalho passar de um valor definido
- Tempo máximo até o primeiro token, que controla a demora inicial da resposta
- Vazão mínima, ou seja, a quantidade mínima de texto processada por segundo
- Regiões aprovadas, para restringir onde a requisição pode ser atendida
- Zero retenção de dados, condição para que o provedor não guarde o conteúdo enviado
- Listas de provedores e modelos permitidos, quando o comprador só aceita determinadas empresas ou tecnologias
Há ainda um recurso de roteamento automático: a plataforma pode escolher, sozinha, o modelo mais adequado para cada tarefa específica, dentro das regras do comprador.
O que muda para quem desenvolve
A mensagem da Architect para programadores é direta: basta trocar a base URL, manter o código e deixar os provedores competirem em preço. A base URL é o endereço que um programa usa para conversar com o serviço de IA. Como a plataforma aceita chamadas no padrão da OpenAI e da Anthropic, a troca desse endereço teoricamente migra a aplicação inteira para o leilão.
A compatibilidade foi pensada para ferramentas de programação com assistência de IA. Segundo a empresa, o Liquid Inference funciona de forma encaixável com Claude Code, Codex, OpenCode, Cursor, Pi e Cline. Além da interface de programação, a plataforma também oferece um chat para uso direto, sem código.
Condições de entrada e incentivos
As contas novas recebem um saldo inicial em tokens de inferência, o que permite testar a plataforma antes de depositar dinheiro. Segundo Harrison, da Architect, os primeiros 500 usuários recebem 20 dólares de inferência gratuita. Há também um programa de indicação: quem traz um novo usuário ganha 20% das taxas geradas por ele na forma de inferência gratuita, e 10% sobre indicações feitas por esse usuário, o chamado segundo nível.
Para quem quer atuar do outro lado do mercado, vendendo capacidade de inferência, Harrison afirma que a verificação de novos provedores acontece "em minutos, não em semanas". Os pagamentos a provedores são processados pela Stripe, plataforma de pagamentos usada por empresas de software.
Uma ressalva é necessária. O modelo de negócio depende de concorrência real entre provedores para gerar economia ao comprador, e a Architect não divulgou números de economia observada nem lista oficial de participantes do mercado. Quem tiver conta pode ver as cotações por provedor e por modelo no livro de ofertas publicado pela plataforma, o que permite acompanhar a disputa na prática. Até o lançamento, o anúncio descreve o mecanismo e as regras; a extensão das vantagens será medida pelo uso.
O lançamento acontece num momento em que o custo de acesso a modelos de linguagem virou preocupação central de empresas que colocam IA em produtos. O Liquid Inference aposta que a mesma disciplina de preço que organizou mercados financeiros regulados pode se aplicar ao atendimento de modelos de linguagem, uma requisição de cada vez.
Perguntas frequentes
O que é o Liquid Inference?
É uma plataforma da Architect Financial Technologies, lançada em 7 de outubro de 2026, que promove um leilão em tempo real entre provedores de inferência para atender cada requisição de modelo de linguagem. Vence a oferta mais barata que respeita as regras de custo, desempenho, região e privacidade definidas pelo comprador.
Como um desenvolvedor passa a usar a plataforma?
Segundo a Architect, basta trocar a base URL do código, porque a plataforma aceita chamadas padrão no formato das APIs da OpenAI e da Anthropic. A empresa lista compatibilidade encaixável com Claude Code, Codex, OpenCode, Cursor, Pi e Cline.
Como funciona a cobrança?
A cobrança é apenas pelo uso medido, e o preço máximo de cada requisição é travado antes da geração do primeiro token. Contas novas recebem um saldo inicial em tokens de inferência e, segundo Harrison, da Architect, os primeiros 500 usuários ganham 20 dólares de inferência gratuita.
Quem pode vender capacidade no mercado?
Empresas provedoras de inferência podem se candidatar pela página da plataforma. Segundo Harrison, a verificação de novos provedores é feita "em minutos, não em semanas", e os pagamentos são processados pela Stripe.