

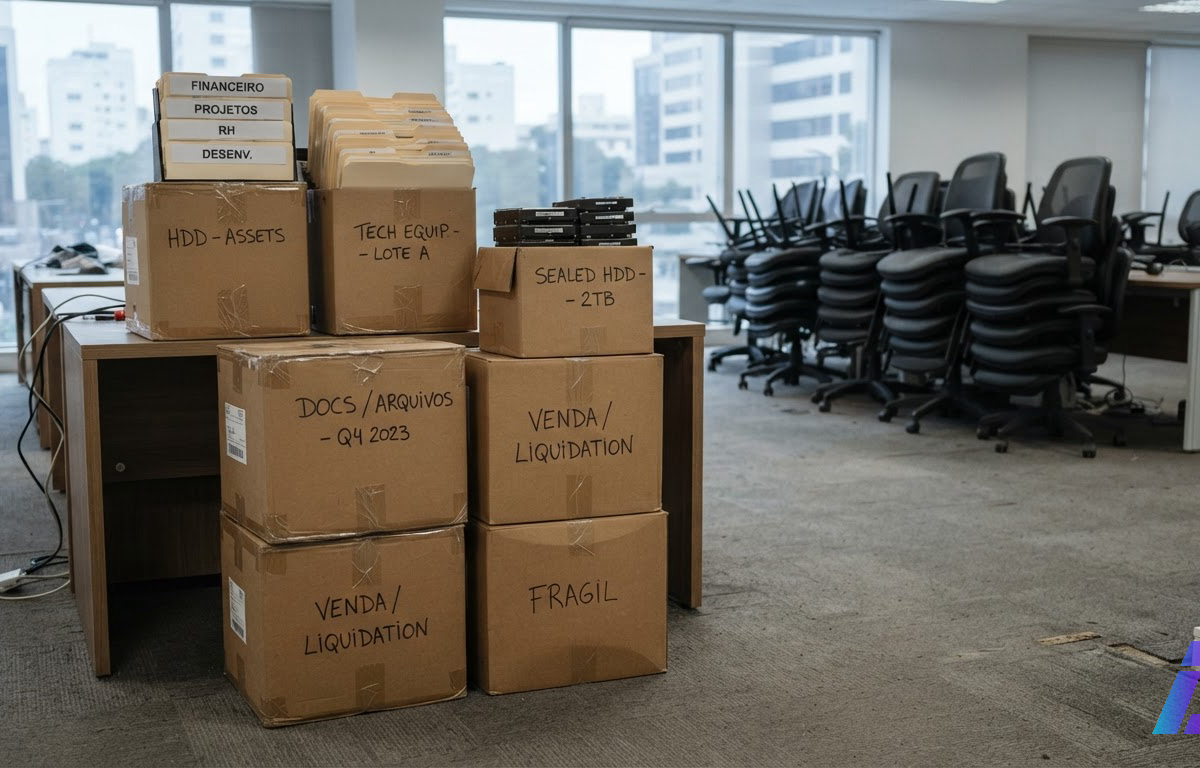
Keelan Miskell achava que o arquivo digital da sua startup de cripto não valia grande coisa. A empresa tinha poucos anos, usuários anônimos e estava sendo fechada. Ele errou. Segundo reportagem de Matthew King na MIT Technology Review, Miskell recebeu cerca de US$ 25 mil pelo código-fonte. Ainda espera algo perto de US$ 15 mil pelos dados de trabalho guardados no Google, Notion, Figma e Slack. Foram dois anos e meio de rotina de uma equipe, empacotados e vendidos.
O caso abriu a edição de 28 de outubro da The Download, newsletter diária da revista. A edição pôs lado a lado duas histórias que parecem não ter relação: laboratórios de IA comprando o espólio de startups mortas e cientistas tentando decifrar a comunicação dos animais. O fio que liga as duas é a fome de dados da inteligência artificial e a distância entre acumular dados e entender o que eles dizem.
Por que o arquivo morto virou mercadoria
Os laboratórios que treinam modelos de IA estão chegando ao limite do texto público disponível e dos dados sintéticos, aqueles gerados por outras máquinas. Agora querem registros reais de como as pessoas trabalham: quem pede o quê no chat, como um problema é discutido, como um documento evolui. É o material de que precisam os agentes de IA, programas criados para executar tarefas de escritório por conta própria.
Startups fechando não faltam. Estimativas da Carta e da AngelList citadas pela reportagem mostram os encerramentos crescendo entre 26% e 56% ao ano nos últimos anos. A SimpleClosure (abre em nova aba), empresa que ajuda startups a fechar as portas e que intermediou a venda de Miskell, criou em abril a Asset Hub, uma área só para vender código e dados como e-mails, conversas e documentos. Já são mais de 150 negócios, e a meta é devolver mais de US$ 10 milhões a startups até o fim de 2026. O CEO, Dori Yona, diz que essas transações, antes raras e "meio tabu", viraram rotina: 47% dos negócios da empresa já incluem venda de código ou dados. A concorrente Sunset, de Brendan Mahony, define o preço pelo número de funcionários, pelos anos de operação, pelo volume de dados e pelo uso de ferramentas.
Do lado de quem compra estão os laboratórios dos grandes modelos, empresas que montam escritórios simulados para treinar IA e companhias de tecnologia maduras que desenvolvem modelos próprios.
Os grandes já entraram no jogo
Isso não se limita a startups de garagem. Em agosto, no processo de falência da Spirit Airlines, o Google superou a oferta da Mercor e levou os dados da companhia aérea por US$ 10 milhões. O pacote inclui 100 milhões de e-mails, 500 milhões de mensagens no Teams e 176 mil registros de funcionários. Em setembro, a Bloomberg informou que a unidade de IA da SpaceX avalia comprar dados de startups em dificuldade.
Quem escreveu os e-mails não está na mesa
Os e-mails e as mensagens vendidos foram escritos por pessoas que não estavam negociando nada. Estavam trabalhando. O advogado Greg Ewing chamou esse tipo de material de "legalmente radioativo". A professora de direito Ifeoma Ajunwa, da Universidade Emory, lembra que o dinheiro costuma ir para credores preferenciais e investidores, e não para os funcionários. Ela também aponta que não existe lei federal nos Estados Unidos proibindo essas vendas. Nem os fundadores sabem direito quem compra ou o que será feito com os dados. O arranjo é conveniente para quase todo mundo, menos para quem produziu o conteúdo.
Há ainda um detalhe que deveria esfriar o entusiasmo. Nick Heiner, da Surge AI (abre em nova aba), empresa que constrói "ginásios de aprendizado por reforço" (ambientes simulados onde a IA aprende tarefas por tentativa e erro), afirma que nenhuma empresa publicou testes comparando o treino com dados reais e com as alternativas. Segundo ele, os preços se apoiam em teses de pesquisa. Na prática, é um mercado de milhões montado sobre uma aposta e pago com a conversa alheia.
Do Slack ao latido
A segunda história da edição, de Cassandra Willyard, faz parte da série "Are we there yet?" ("Já chegamos?") e mostra o problema pelo outro lado. Na comunicação animal também sobram dados. Em 50 anos, hidrofones (microfones subaquáticos) e sensores presos ao corpo dos bichos ampliaram muito a observação. Na última década, a IA passou a detectar chamados, identificar qual animal emitiu cada som e encontrar padrões. O que falta é compreensão. A revista deu nota 4 ao campo em seu medidor de progresso: há montanhas de gravações, e os pesquisadores ainda tentam descobrir como decifrá-las.
Algumas coisas já se sabe. Cães-da-pradaria emitem sequências diferentes de ganidos quando um coiote se aproxima e quando há um gavião por perto. E a comunicação animal não passa só pelo som: inclui sinais visuais, toque, feromônios ou combinações deles.
O Earth Species Project (abre em nova aba), organização sem fins lucrativos criada em 2018, usou aprendizado de máquina para detectar vocalizações de gralhas-pretas e saber qual ave fez cada chamado. A ecóloga comportamental Sara Keen diz que o grupo espera que o NatureLM, modelo treinado com fala humana, música e sons de animais, consiga interpretar vocalizações de várias espécies. O neuroecólogo Yossi Yovel, da Universidade de Tel Aviv, faz o alerta certo: modelos podem agrupar sons parecidos que têm significados diferentes.
Para Con Slobodchikoff, fundador da Zoolingua, que trabalha em comunicação de cães para humanos, decifrar esses sinais poderia ajudar as pessoas a perceber que os animais são seres sencientes, que pensam e têm esperanças e sonhos próprios. Uma conversa de mão dupla, porém, não tem data marcada nem garantia de acontecer. A tradução segue no campo teórico.
Lidas juntas, as duas histórias dizem muito sobre o momento da IA. A indústria age como se mais dados significassem automaticamente mais inteligência. A bioacústica tem montanhas de gravações e ainda recebe nota 4, o que mostra que não é bem assim. Antes de alguém pagar US$ 10 milhões pelos e-mails de uma companhia aérea falida, seria bom que alguém provasse que eles ensinam alguma coisa.