

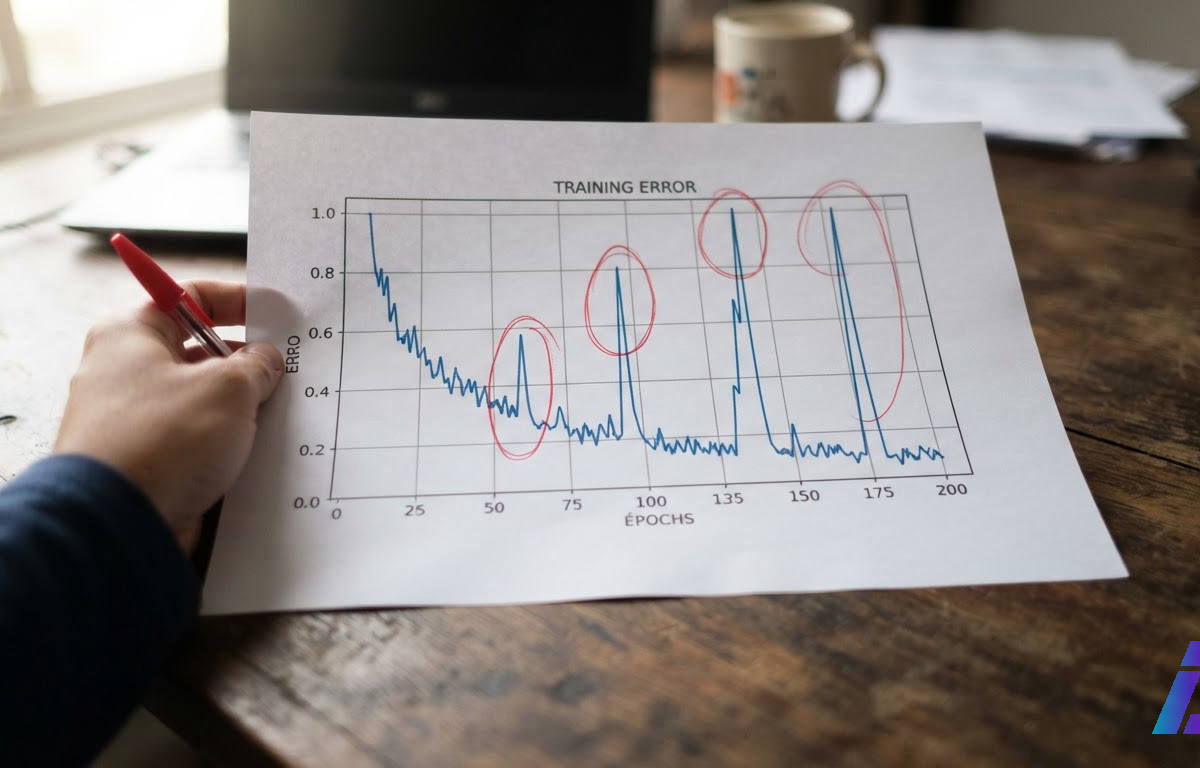
Em 2022, um grupo de pesquisadores descreveu um comportamento estranho de redes neurais, o "slingshot" (estilingue): no meio do treinamento, o erro do modelo dá saltos repentinos. Na quinta-feira (22), três pesquisadores do Google DeepMind propuseram uma explicação bem menos poética. Segundo eles, o fenômeno desaparece quando se corrige um erro de arredondamento em duas das contas mais básicas da inteligência artificial.
No artigo A Fix for Softmax and Cross-Entropy (abre em nova aba), Jonathan T. Barron, Dan Gnanapragasam e Michael Tschannen afirmam que as implementações padrão de softmax, log-softmax e cross-entropy têm dois bugs numéricos. Traduzindo: o softmax converte em probabilidades os "placares" que o modelo dá a cada resposta possível, chamados logits. A cross-entropy mede o erro e gera o gradiente, o sinal que diz ao modelo para que lado se ajustar. Se o sinal sai torto, o aprendizado também sai.
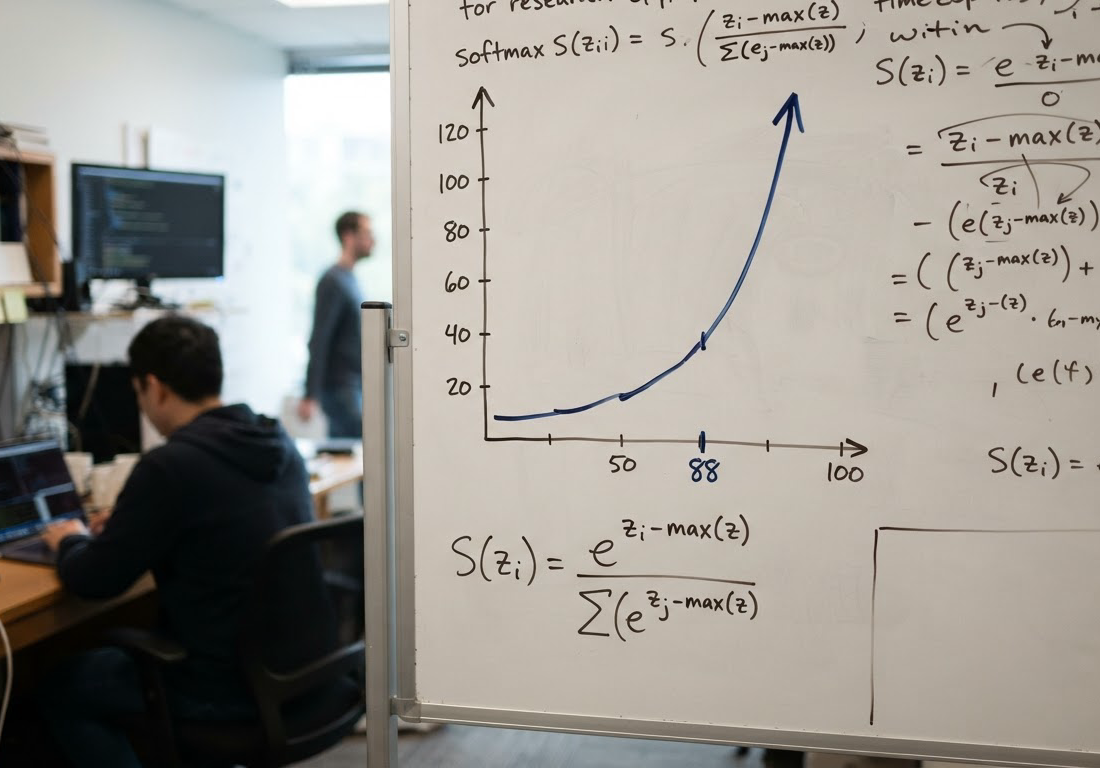
Os frameworks já tratam essas contas com cuidado. Exponenciais crescem rápido, e no formato fp32 valores acima de cerca de 88 estouram. Por isso, segundo a página do projeto (abre em nova aba), JAX, PyTorch, TensorFlow e companhia subtraem o maior placar antes de calcular. O truque resolve o estouro, mas, segundo os autores, deixa dois buracos.
Primeiro bug: o sinal que some
O Softmax Collapse aparece quando o placar da resposta certa fica muito acima dos demais. Nesse caso, o gradiente dela é arredondado para zero, enquanto os sinais minúsculos das respostas erradas continuam lá. Na matemática exata, esses ajustes se compensam e somam zero. Com o arredondamento, deixam de somar, e o modelo recebe empurrões desequilibrados.
O ponto em que isso acontece depende da precisão numérica usada. Segundo os autores, quanto menor a precisão, mais cedo o problema chega:
| Formato | Diferença de placar a partir da qual o gradiente colapsa |
|---|---|
| bf16 | cerca de 5,5 |
| fp32 | cerca de 16,6 |
| fp64 | cerca de 36,7 |
Esse dado pesa porque o bf16 é um formato de baixa precisão popular justamente por acelerar o treino e economizar memória.
O colapso já havia sido identificado por Prieto e colegas em 2025, mas sem uma correção direta. Barron e coautores ligam esses gradientes assimétricos, quando passam pelos otimizadores Adam e AdamW, aos saltos do slingshot. Também os associam a falhas de grokking, o fenômeno em que um modelo que parecia só decorar exemplos de repente passa a generalizar.
Segundo bug: a correção que não para
O Softmax Cancellation afeta duas técnicas. A primeira é a destilação de conhecimento, em que um modelo "aluno" aprende imitando um "professor". A segunda é a regularização KL, que penaliza um modelo por se afastar de outro. Quando as duas distribuições são calculadas separadamente e depois subtraídas, sobra um piso de ruído: mesmo com placares idênticos, o gradiente não zera. É como um professor riscando uma prova sem erro nenhum, e o aluno, obediente, se afastando do gabarito.
A correção proposta é uma reescrita simples das três funções. Segundo o resumo do artigo, ela elimina o slingshot e acelera o grokking quando se usa weight decay, técnica que puxa os parâmetros para valores menores. Também evita o colapso de acurácia sem weight decay e impede que o aluno se desgarre do professor.
"Todas as implementações"? Devagar
Barron, autor principal e pesquisador do Google DeepMind, anunciou o resultado no X com uma frase ainda mais ampla, que inclui até os livros didáticos:
Oi, pessoal, tenho um resultado novo que estou animado para compartilhar. Acontece que todas as implementações existentes de softmax e cross-entropy (ou seja, JAX, PyTorch, livros didáticos etc.) têm um bug sutil. Dois bugs, na verdade. Uma reescrita simples corrige os dois e elimina os "slingshots" no grokking.
Convém separar o que foi demonstrado do que é argumento. O raciocínio dos autores é que todos os frameworks usam a mesma receita e, portanto, herdam os mesmos problemas. O material divulgado não lista versões testadas biblioteca por biblioteca, e o texto é um preprint, ainda sem revisão por pares.
A primeira reação concreta veio de um usuário. No domingo (25), alguém identificado como cbatson abriu uma issue no repositório do PyTorch (abre em nova aba) pedindo a adoção das técnicas do artigo. Ele conta que já tinha esbarrado no colapso em bf16 e contornou o problema calculando a perda em float32. É um pedido de funcionalidade, não uma confirmação dos mantenedores, e a issue não registra nenhuma correção incorporada.
O que dá para fazer agora
O atalho é o desse usuário: calcular a perda em fp32. Isso empurra o ponto de colapso de 5,5 para 16,6, mas não o elimina. O caminho completo é adotar as implementações reescritas que os autores apresentam. Quem trabalha com destilação ou regularização KL tem mais motivo para olhar, porque ali o ruído age justamente quando nada deveria mudar.
Então a fundação da IA está rachada? O que foi divulgado não chega a tanto. Os efeitos destacados pelos autores vêm de experimentos com grokking e destilação, e o resumo não traz medições em grandes modelos comerciais. O incômodo é outro: um fenômeno que ganhou nome e artigo próprio pode ter sido, ao menos em parte, um problema de arredondamento. Se o resultado se sustentar, a lição vale além do softmax, porque às vezes o comportamento misterioso de um modelo está no código, e não no aprendizado.