
Uma ferramenta de código aberto chamada Jevmem (abre em nova aba) foi publicada para dar aos assistentes de programação com inteligência artificial uma memória permanente do projeto em que o usuário trabalha. O projeto é assinado pelo desenvolvedor Avinash Jetwani, apareceu na comunidade Hacker News em 22 de setembro de 2026 e ganhou coberturas publicadas em 25 de setembro de 2026.
Para entender a proposta, vale uma comparação simples. Imagine um caderno de anotações que fica dentro da pasta do projeto. Cada vez que você decide algo importante durante uma conversa com o assistente, alguém escreve uma linha nesse caderno. Na próxima conversa, o assistente lê o caderno antes de responder. É mais ou menos isso que o Jevmem faz, segundo sua documentação.
O problema que a ferramenta tenta resolver
Assistentes de programação com IA, como o Claude Code, funcionam por sessões de conversa. Quando a sessão termina, o contexto costuma se perder, e o profissional precisa explicar de novo o que já havia combinado. O Jevmem tenta reduzir esse retrabalho guardando automaticamente as decisões, restrições, bugs e tarefas pendentes que surgem no bate-papo, para reinjetá-los no contexto das conversas seguintes, de acordo com a descrição do projeto.
Como funciona, em termos simples
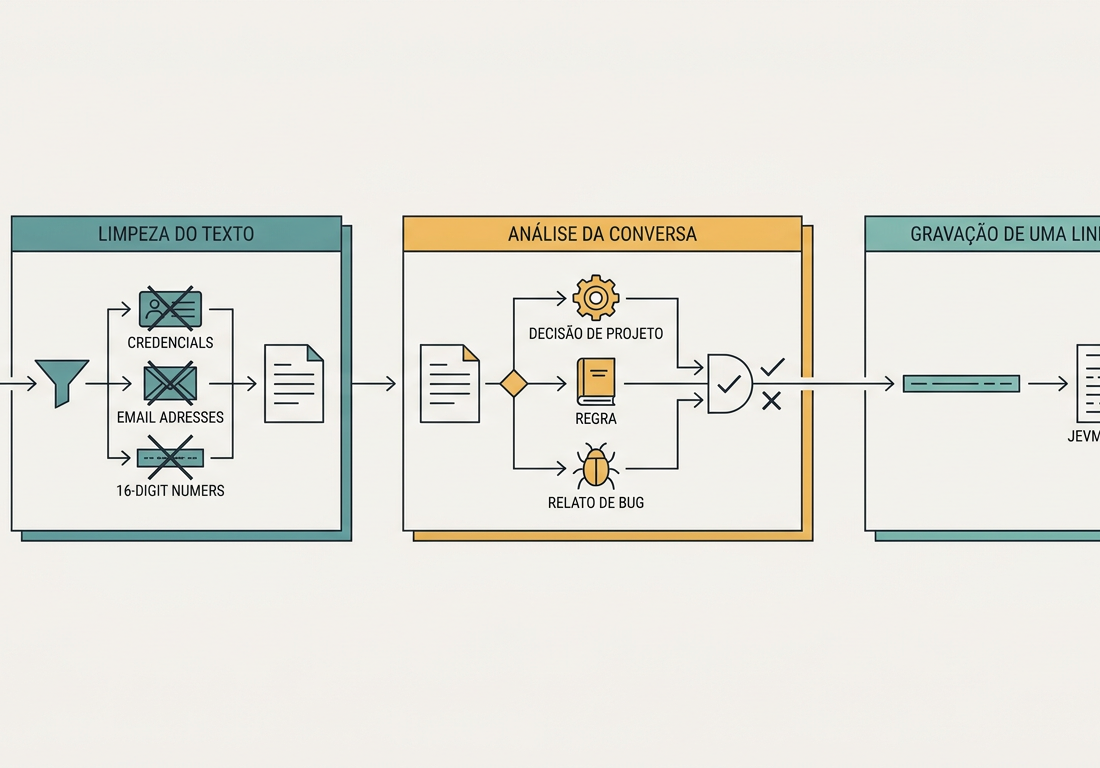
O fluxo descrito nas fontes tem três etapas. Primeiro, uma limpeza local do texto: a ferramenta remove padrões comuns de credenciais, endereços de e-mail e números de 16 dígitos antes de enviar qualquer coisa. Depois, o conteúdo passa por uma análise que estima se aquela conversa contém uma decisão de projeto, uma regra ou um relato de bug. Por fim, se o valor ultrapassar limites definidos, o sistema extrai uma única linha de texto com menos de duzentos caracteres e a grava no arquivo JEVMEM.md, dentro do repositório.
Quando uma orientação nova substitui uma antiga, a linha anterior não é apagada. Ela recebe uma marca indicando que foi superada e fica ligada à nova, formando um histórico auditável de por que o projeto seguiu determinado caminho. Nesse ponto, a ferramenta se comporta mais como um diário de bordo do que como um simples bloco de notas.
Ativação opcional e arquivos criados
Um ponto destacado na documentação é que o Jevmem fica totalmente inerte até ser ativado de propósito dentro de um projeto. Enquanto isso não acontece, seus ganchos e seu servidor de integração não fazem chamadas de rede, não escrevem arquivos e não produzem saída. Há divergência entre as descrições sobre o comando de ativação: uma fonte menciona jevmem enable, enquanto outra fala em jevmem init com opção de ferramenta. A ativação cria o arquivo JEVMEM.md e um jevmem.config.json, ambos pensados para serem versionados, além de uma pasta .jevmem/ adicionada ao arquivo de exclusão do controle de versão. O comando de desativação reverte a configuração, mas preserva o JEVMEM.md, mantendo as anotações acumuladas.
Para funcionar, a ferramenta exige uma chave do serviço TypeSafe AI, e chaves de OpenAI ou Anthropic são opcionais. Como os ganchos nem sempre leem o perfil de terminal do usuário, a recomendação é guardar as credenciais em um arquivo dedicado na pasta pessoal. Por padrão, não há um comando instalado de forma avulsa no sistema, e a maior parte das pessoas deve chamá-lo por meio do utilitário npx. A execução depende de uma instalação de Node.js 20 ou superior localizada automaticamente, e no Windows é necessário ter o utilitário sh do Git for Windows disponível no sistema.
Números divulgados e ressalvas
O projeto apresenta um comparativo com seis modelos de linguagem grandes, medido em 66 turnos de desenvolvimento datados de 23 de setembro. Segundo os números publicados, a configuração automática do Jevmem acertou 98,5% das decisões de guardar ou ignorar e 95,5% na classificação do tipo de anotação, com tempo mediano de 300 milissegundos e custo aproximado de 0,000127 dólar por decisão. Os modelos comparados ficaram entre 2,8 e 4,3 segundos por decisão, com custos que variaram de cerca de 0,000089 dólar a 0,013256 dólar. O próprio autor ressalva que se trata de uma única rodada e que diferenças de um ou dois turnos ficam dentro da variação normal entre execuções.
Privacidade e limitações reconhecidas
A documentação afirma que os dados processados passam pelo serviço TypeSafe AI sem coleta de telemetria e que o usuário pode adotar protocolos de retenção zero. A limpeza automática cobre credenciais e padrões financeiros, mas nomes e endereços físicos não são mascarados por padrão, o que exige consulta à documentação de segurança para controle mais fino. O repositório também reconhece limitações e pontos ainda em aberto.
A captura automática por ganchos está disponível apenas no Claude Code. Nos demais clientes, como Cursor e Codex, existem níveis diferentes de integração. A ferramenta oferece ainda comandos auxiliares, como busca, listagem e auditoria, sendo que a auditoria reavalia as memórias guardadas contra o repositório e marca as que podem estar desatualizadas. O ajuste de pesos e limites exige pelo menos 40 etiquetas fornecidas pelo usuário.
Para quem quiser experimentar, o caminho indicado é consultar diretamente o repositório do projeto e verificar as instruções de instalação e as condições de licença antes de ativar a ferramenta em um repositório real de trabalho.