
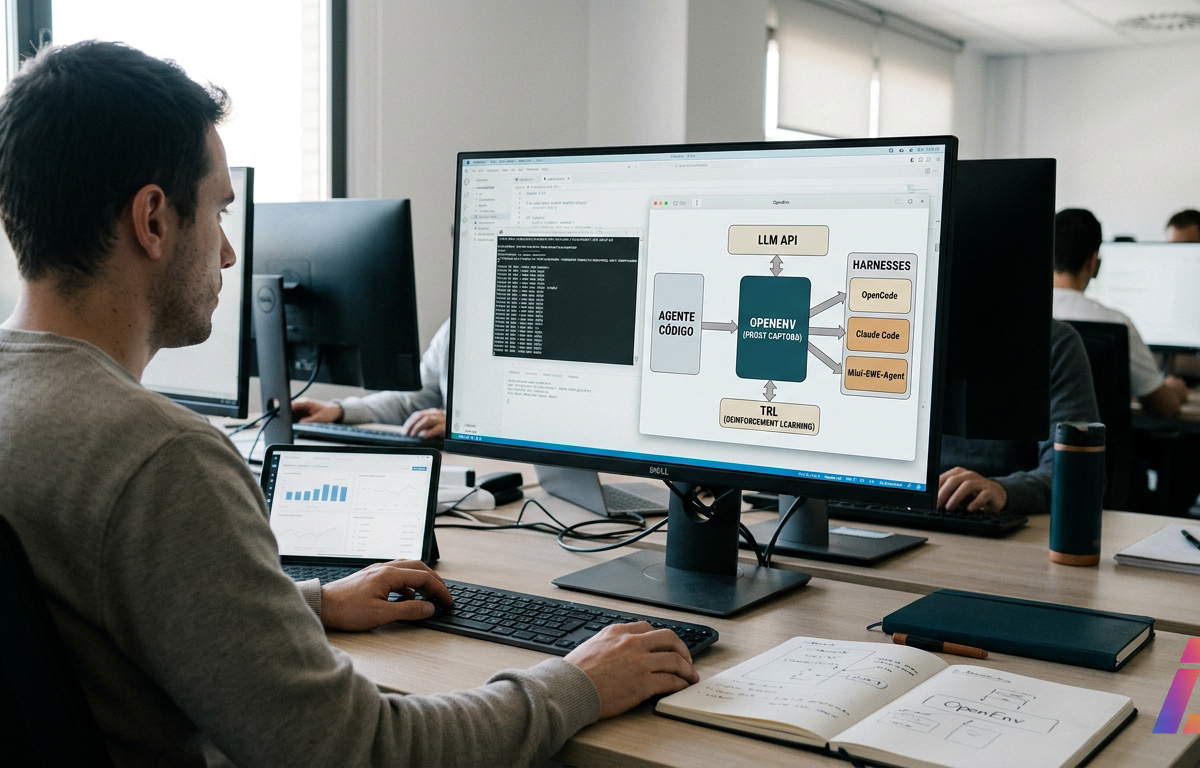
O Hugging Face lançou o OpenEnv (abre em nova aba), uma ferramenta de código aberto que promete revolucionar o treinamento de agentes de codificação usando aprendizado por reforço (RL). A inovação central do OpenEnv reside em sua arquitetura de proxy de captura, que permite que esses agentes sejam treinados em múltiplos ambientes de teste, ou "harnesses", sem a necessidade de modificar o código original desses ambientes. A iniciativa, anunciada publicamente pela primeira vez em outubro de 2025, foi ampliada em junho de 2026 com o apoio de uma ampla coalizão que inclui Meta-PyTorch, Reflection, Unsloth, Modal, Prime Intellect, Nvidia, Mercor, Fleet AI, Microsoft, e RadixArk, além do próprio Hugging Face.
Mas o que é exatamente o OpenEnv e como ele funciona? Imagine que você tem diferentes jogos, e cada jogo tem suas próprias regras e formas de interagir. Treinar um jogador de videogame usando inteligência artificial (IA) para cada jogo individualmente exigiria que você reescrevesse as regras do jogo para a IA entender. O OpenEnv resolve isso de uma forma muito mais inteligente. Ele age como um tradutor universal, um "proxy de captura", entre o agente de codificação e os diversos harnesses, como OpenCode, Claude Code, Codex e Mini-SWE-Agent.
Quando o harness, que é o ambiente de teste onde o código do agente é avaliado, pensa que está conversando diretamente com a API de um modelo de IA, ele está, na verdade, falando com o OpenEnv. O OpenEnv intercepta essa comunicação, traduzindo-a para um dos quatro formatos de API que os agentes de codificação usam (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini). Depois de traduzir, ele encaminha a solicitação para um modelo de linguagem grande (LLM), como os que são otimizados pelo vLLM (abre em nova aba), registra os IDs exatos dos tokens e as probabilidades logarítmicas ("logprobs") amostradas pelo LLM, e então entrega essas sequências ao TRL (TransformeR Reinforcement Learning), uma biblioteca para treinar modelos com RL.
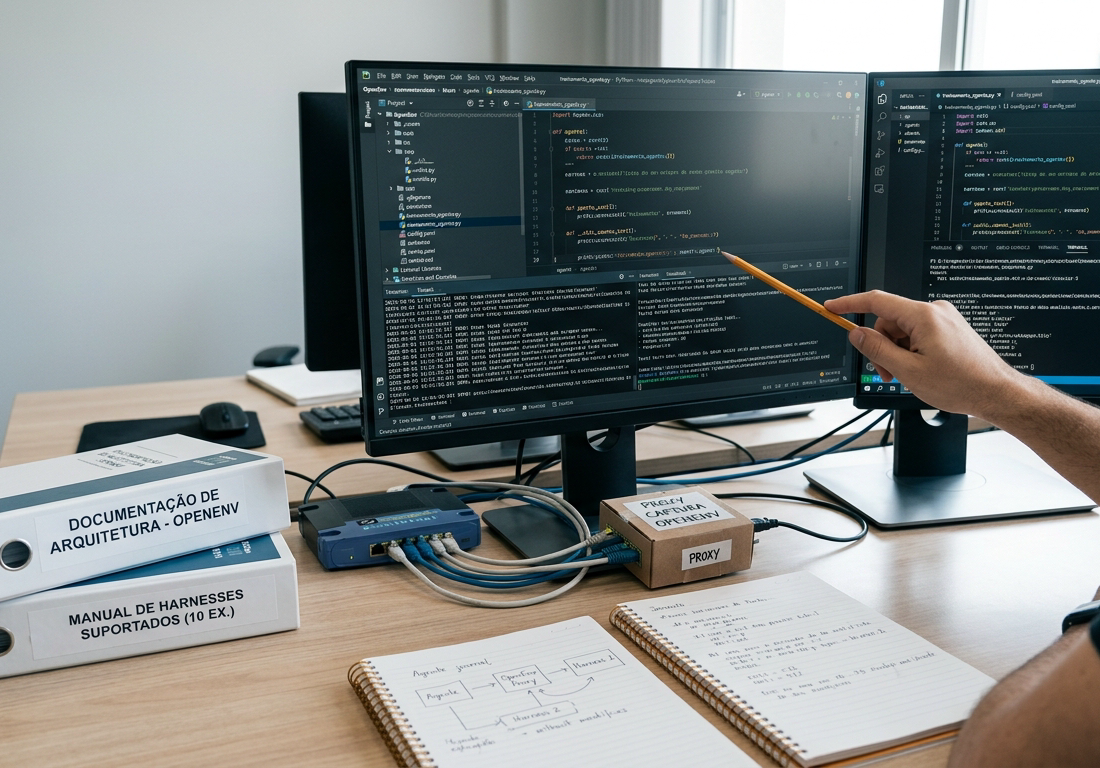
Nós transformamos Claude Code, Codex, Hermes, Pi, @opencode e outros harnesses de codificação em ambientes de RL. Nenhuma alteração nos harnesses, nenhuma alteração no código de treinamento. Qualquer modelo aberto, qualquer conjunto de tarefas, totalmente open source, meus amigos! Mesmo modelo, mesmos pesos: 62% sob Mini-SWE-Agent, 33% sob Claude Code. Mas treinar dentro de um harness real normalmente significa reimplementá-lo como um ambiente, então a maioria dos modelos é treinada em um andaime que ninguém realmente envia. A solução é um proxy, não uma reescrita. O harness pensa que está conversando com uma API de modelo. Na verdade, está conversando com um proxy de captura que fala os 4 formatos que os agentes de codificação usam (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini), encaminha para @vllm_project, registra os IDs exatos dos tokens e logprobs amostrados pelo vLLM, e entrega sequências ao TRL nas quais ele pode treinar. O harness se torna o ambiente. 10 harnesses funcionam através dele hoje, nenhum modificado. E porque você controla a recompensa, você pode moldar o comportamento que o harness nunca pediu. Nós adicionamos um s
Essa abordagem permite que o harness se torne o próprio ambiente de RL, sem que nenhuma linha de código seja alterada nele. O fundador do Hugging Face, Clément Delangue, comentou em 5 de outubro de 2026 que o OpenEnv já suporta 10 harnesses, todos sem modificação. Essa capacidade de não alterar o código original é um diferencial, pois modelos anteriores eram frequentemente treinados em ambientes customizados que não refletiam o uso real.
O OpenEnv já demonstrou resultados promissores em termos de desempenho e eficiência. Um modelo Qwen3.5-2B (abre em nova aba), por exemplo, foi ajustado para tarefas de análise de dados com agentes, utilizando o OpenCode, Claude Code, Codex e Mini-SWE-Agent. O treinamento foi realizado com o método assíncrono GRPO (TRL Async GRPO) e atingiu uma taxa de sucesso geral de 37,0% em 1.000 tarefas em 1º de outubro de 2026, sendo 370 tarefas concluídas com êxito.
Para contextualizar esses números, uma postagem oficial do Hugging Face em 2 de outubro de 2026 destacou que o mesmo modelo, com os mesmos pesos, pode ter um desempenho muito diferente em harnesses distintos: 62% em um e 33% em outro. Isso sublinha a importância de treinar em múltiplos ambientes. O blog da plataforma também detalhou melhorias notáveis:
- Aumento de desempenho: Um modelo LFM2.5-2.6B, treinado em quatro harnesses simultaneamente, viu sua taxa de sucesso aumentar de 42% para 54%.
- Redução de chamadas de ferramentas: Houve uma diminuição de 31% nas chamadas de ferramentas, graças a um bônus por resolver tarefas em menos etapas, o que indica maior eficiência do agente.
- Melhora geral: Embora o treinamento em OpenCode sozinho tenha elevado seu desempenho de 34% para 58%, o modelo treinado em múltiplos harnesses demonstrou melhorias em todos os ambientes.
Para facilitar a integração e o uso, diversos modelos fine-tuned, datasets e pipelines de integração foram disponibilizados publicamente. Um dataset notável é o FineEnvs/SmolDataEnvs-harbor-train (abre em nova aba), publicado em 2 de outubro de 2026. Este dataset é construído a partir de notebooks de ciência de dados reais do Kaggle, oferecendo um sistema de avaliação determinístico sem a necessidade de um juiz baseado em LLM. Para instalar, basta usar pip install "openenv[harbor]".
Em termos de integrações, o OpenEnv se conecta com a biblioteca TRL (TransformeR Reinforcement Learning), permitindo o uso de exemplos como o async_grpo_harbor para treinamento. Tutoriais detalhados fornecem orientações sobre como treinar modelos de raciocínio, usar TRL ou Unsloth, ou coletar rollouts para treinamento supervisionado. Embora alguns tutoriais antigos, como os de OpenCode e Pi, estejam descontinuados, a abordagem via Harbor é a recomendada agora.
Os casos de uso práticos do OpenEnv são amplos. Ele permite que desenvolvedores e pesquisadores criem e treinem agentes de codificação mais robustos e adaptáveis, capazes de performar bem em diferentes contextos e linguagens. A comunidade open-source está ativamente envolvida, com o repositório do OpenEnv agora hospedado em huggingface/OpenEnv. Isso abre caminho para a colaboração e para a expansão do ecossistema de agentes.
No entanto, existem limitações e próximos passos planejados. Embora o OpenEnv seja uma solução poderosa para a interoperabilidade entre ambientes de RL, a complexidade inerente ao treinamento de agentes de codificação em larga escala ainda apresenta desafios. O foco contínuo no suporte a mais harnesses e a otimização dos processos de treinamento são áreas de desenvolvimento ativo. O OpenEnv está em constante evolução, buscando se tornar uma camada fundamental para ambientes de RL, facilitando a construção de um ecossistema de agentes mais aberto e colaborativo.