

Em 13 de outubro de 2026, o Google lançou um modelo de inteligência artificial com uma ambição pouco comum: não escrever textos nem responder perguntas, mas fazer robôs entenderem e executarem ações no mundo físico. O anúncio do Google (abre em nova aba) descreve o Gemini 4 Argon como um modelo de "raciocínio físico" de uso geral, capaz de gerar código para controlar robôs, construir simulações a partir de fotos e vídeos e julgar se uma ação robótica foi bem ou mal executada. Kanishka Rao, engenheiro principal do Google DeepMind, classifica o lançamento como um salto em direção à chamada "AGI física", um estágio em que a IA lida com tarefas do mundo real com a mesma generalidade que os modelos atuais mostram com linguagem. Essa é a promessa. O que os testes até agora mostram é mais matizado.
O que o modelo se propõe a fazer
Os modelos de IA que o público conhece trabalham com texto, imagem e som. O Argon ataca um problema mais duro: traduzir percepção em movimento. Segundo o Google, ele serve para o "ciclo de vida" inteiro da robótica, desde criar simulações de treino até dirigir o robô em tempo real. Os exemplos publicados pela empresa incluem quatro frentes: controle direto de robôs, conversão de imagens do mundo real em simulações, compreensão física de cenas e ferramentas para pesquisas com autoaprimoramento.
O resultado de maior destaque vem de um teste chamado ERQA, sigla em inglês para "Raciocínio Encarnado, Perguntas e Respostas". É um exame de perguntas sobre problemas físicos e espaciais em ambientes tridimensionais: onde um objeto está, como se move, o que acontece se algo for empurrado. São 400 questões, respondidas sem ferramentas auxiliares. O Google afirma que o Argon, usando apenas raciocínio, atingiu 87% e superou todos os demais modelos de ponta.
Vale uma ressalva: o número foi medido pelo próprio Google. O veículo The Decoder, que analisou o anúncio em 15 de outubro, cites o gráfico da empresa para listar os colocados atrás: Claude Opus 5.5 com 82,3%, GPT-6 Astra com 81% e Claude Fable 5.1 com 74%. Ou seja, os comparáveis vêm da empresa interessada, não de avaliação independente.
O vídeo que virou arremesso
A demonstração mais chamativa aparece no comunicado de produto do Google (abre em nova aba): cornhole, um jogo norte-americano em que a pessoa arremessa sacos de grãos tentando acertar um furo em uma prancha inclinada. Em um teste interno descrito pela empresa, o Argon assistiu a um vídeo cru de um humano jogando, mapeou coordenadas espaciais, calculou os movimentos das juntas do corpo inteiro e escreveu o código de uma simulação. Transferido para o Apollo, humanoide da fabricante Apptronik, o robô acertou sete arremessos consecutivos em teste real.
O Google DeepMind resumiu a sequência em sua rede social:
O Gemini 4 Argon ensinou um robô a jogar cornhole apenas assistindo a um vídeo. Ele mapeou a física, criou sua própria simulação e ensinou o humanoide Apollo, da @Apptronik, a acertar 7 arremessos seguidos.
A empresa batiza esse caminho de "Vídeo-Simulação-Real" e afirma que ele comprime semanas de modelagem manual de simulação em poucas horas. São alegações do Google sobre um teste interno, ainda não confirmadas por terceiros.
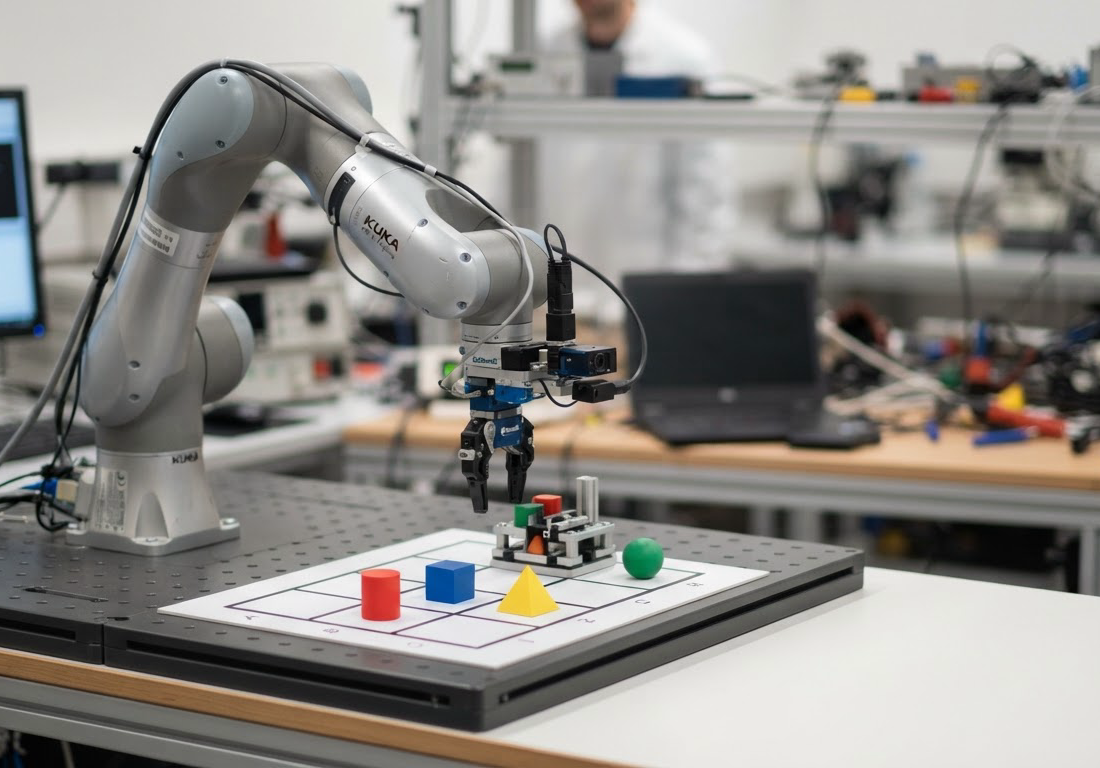
Outros exemplos publicados completam o quadro. O Argon controlou o Spot, robô quadrúpede da Boston Dynamics, para pisar em um pedal de lixeira depois de treinar em MuJoCo, um simulador de física usado em pesquisas de robótica. Dirigiu o modelo Gemini Omni por 33 etapas para soletrar A-R-G-O-N com peças de jogo de tabuleiro. A partir de uma única foto comum de uma mesa, sintetizou mais de 4.500 episódios simulados; ao treinar um robô real com esse material, a taxa de sucesso subiu de 56% para 75% e o tempo de conclusão caiu de 35 para 24 segundos, sempre segundo o Google. Em braços robóticos de seis graus de liberdade (uma medida técnica de quantos movimentos independentes a máquina tem), tarefas de pegar e soltar encurtaram de 58,9 segundos para 17,4 segundos ao longo das repetições.
O teste independente aponta na direção contrária
Um dia depois do anúncio, em 14 de outubro, a empresa de avaliação Artificial Analysis publicou o AA-Robotics v0.1 (abre em nova aba), uma bateria de testes em que cada modelo recebe o controle de um braço robótico de seis eixos e oito tarefas simples de mesa, executadas direto em um robô real, sem treino prévio. Os resultados divergem do benchmark do Google.
| Modelo | Média nas oito tarefas (0 a 100) |
|---|---|
| GPT-6 Astra | 69,4 |
| GPT-6.1 Sol | 64,6 |
| Gemini 4 Argon | 55,3 |
| Claude Opus 5.5 | 48,8 |
| Claude Fable 5.1 | 46,3 |
O Argon ficou em terceiro lugar. Foi também o mais lento dos cinco: 52 minutos em média por tarefa, com 21 minutos gastos antes da primeira ação. Em tentativas de pegar objetos em seis tarefas, teve sucesso em 36% de 75 tentativas. A Artificial Analysis conclui que os modelos de linguagem de hoje são cerca de 100 vezes mais lentos que um humano, meia hora por tarefa contra 20 segundos de uma pessoa, e que isso os torna lentos e caros demais para uso em produção. Para comparação de custo, o GPT-6 Astra gastou em média US$ 16,36 por tarefa e o GPT-6.1 Sol, US$ 1,93.
Duas avaliações, dois retratos. No papel, o Argon lidera. Com as mãos em um robô de verdade, ficou no meio da tabela. A diferença tem explicação parcial: o ERQA mede raciocínio sobre cenas, enquanto o AA-Robotics mede velocidade, custo e execução física, e os dois conjuntos de habilidades ainda não andam juntos.
Prompts escritos à mão
The Decoder apontou outra limitação nos exemplos do Google. As demonstrações ainda dependem de orientação humana detalhada: a tarefa de "controle direto" anunciada como zero-shot (ou seja, executada sem treino prévio) recebe uma imagem de câmera com uma grade em centímetros e comandos prontos, como o de agarrar. Os prompts de simulação vêm com longas listas de proibições, instruções do que o modelo não deve fazer. O Google também não divulgou taxas de falha das demonstrações individuais, e a taxa de sucesso de 75% da foto em simulação aparece sem o número total de tentativas em que se baseia. Nenhuma dessas observações invalida os resultados; elas os delimitam.
O que já está no mercado
Robôs à parte, o modelo em si é produto. O Google afirma que o Argon está disponível globalmente para desenvolvedores e empresas pela Gemini API, a interface paga em que programas de computador consomem o modelo, além dos assinantes nas ferramentas Google Antigravity, no aplicativo Gemini e no AI Mode da Busca, com restrições: o app e o AI Mode pedem assinatura Ultra ou Pro, e o Antigravity exige Ultra.
No período introdutório, o custo é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com entrada em cache 95% mais barata. Tokens são as unidades de texto com que se mede o consumo de um modelo; um milhão de tokens equivale a algumas centenas de milhares de palavras. A partir de 1º de dezembro, o preço passa a US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída, para o modelo de acesso público.
Perguntas frequentes
O que é o benchmark ERQA?
É um teste de 400 perguntas sobre problemas físicos e espaciais em ambientes 3D, respondidas pelo modelo sem ferramentas auxiliares. O Google informa que o Argon acertou 87%, mas a medição é da própria empresa.
O Argon já controla robôs sozinhos em situações reais?
Não de forma autônoma e confiável. Os exemplos do Google dependem de prompts humanos detalhados, e no teste independente da Artificial Analysis o modelo levou em média 52 minutos por tarefa e acertou 36% das tentativas de pegar objetos.
Quanto custa usar o Gemini 4 Argon?
Até 30 de novembro de 2026, US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída pela Gemini API, com entrada em cache 95% mais barata. Depois dessa data, os preços passam a US$ 4 e US$ 20 por milhão, respectivamente.
Os números do Google foram confirmados por terceiros?
Os 87% no ERQA são medição do próprio Google, com os rivais posicionados pelo gráfico da empresa. A única avaliação independente conhecida até agora, a AA-Robotics da Artificial Analysis, colocou o Argon em terceiro lugar entre cinco modelos em robô real.