
Pesquisadores da divisão Google Cloud AI Research, em parceria com as universidades UNC-Chapel Hill, Stanford e Washington University in St. Louis, apresentaram um método para aperfeiçoar agentes de inteligência artificial de maneira contínua. Batizado de RRSI, sigla em inglês para Autoaprimoramento Recursivo Regularizado, o sistema foi detalhado em um artigo científico da pesquisa (abre em nova aba) divulgado em 21 de setembro de 2026, com documentação pública complementar publicada em 29 de setembro de 2026. A proposta permite que os assistentes melhorem seu próprio funcionamento sem sofrer com a perda de capacidade em tarefas inéditas.
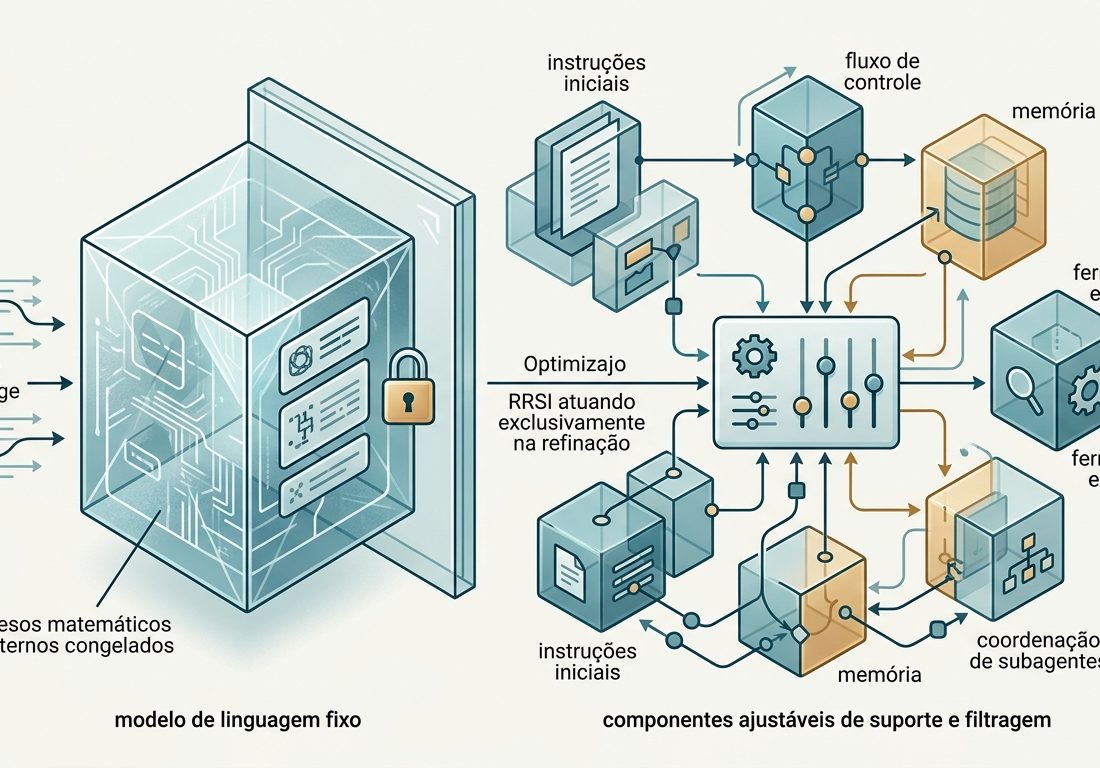
Na prática da inteligência artificial, um agente é composto por um modelo central que processa linguagem e por uma estrutura de suporte ao seu redor, chamada tecnicamente de harness. Essa estrutura engloba as instruções iniciais dadas ao sistema, o fluxo de controle, a memória, as ferramentas externas e a coordenação de subagentes. Em vez de treinar novamente a rede neural do modelo principal, o que demandaria alterar seus pesos matemáticos internos congelados, o RRSI atua exclusivamente na reformulação dessa estrutura externa. Uma analogia útil é pensar em um profissional experiente: o conhecimento básico em sua mente permanece o mesmo, mas sua mesa de trabalho, seus manuais e suas listas de checagem passam por revisões para deixá-lo mais ágil e certeiro.
Quando os agentes tentam reescrever suas próprias ferramentas sem regras estritas, ocorre com frequência o problema do sobreajuste, conhecido no meio técnico como overfitting. Nesse cenário, a inteligência decora os exercícios específicos do teste em que está sendo avaliada. Como consequência, ela obtém notas excelentes no treinamento, mas falha ao lidar com situações novas do dia a dia.
Para solucionar esse obstáculo, o RRSI introduz mecanismos de regularização, que funcionam como freios e filtros durante as tentativas de evolução. O gerador de mudanças opera sob um orçamento controlado, limitando quantas alterações independentes podem ser agrupadas de uma só vez. Além disso, o sistema consulta todo o histórico de tentativas anteriores para nunca repetir hipóteses já descartadas e redireciona os esforços para recursos que ainda não foram explorados.
Na etapa de seleção, atua uma função crítica que barra alterações feitas sob medida para agradar apenas ao gabarito do teste avaliado. Existe também um piso de pontuação ajustado para ruídos estatísticos, impedindo que flutuações casuais sejam interpretadas como progresso real. Por fim, uma regra de custo exige que qualquer aumento no consumo de tokens, que são os pedaços de palavras processados pela máquina, compense o gasto por meio de um ganho mensurável de desempenho, enquanto componentes que deixam de ser úteis acabam podados.
Os experimentos envolveram oito conjuntos de avaliação divididos em três áreas de atuação: programação, espaço de trabalho de agentes e projetos de engenharia. O modelo de linguagem Claude Opus 4.8 serviu como política padrão, e os pesquisadores também realizaram testes com o Gemini 3.5 Flash. As medições revelaram que o aprimoramento se manteve firme mesmo em tarefas nunca vistas durante a fase de ajuste.
| Domínio de teste | Avaliação | Papel na pesquisa | Desempenho original | Desempenho com RRSI | Variação |
|---|---|---|---|---|---|
| Programação | Terminal-Bench 2.1 | Base de evolução | 74,2% | 80,2% | +6,0 |
| Programação | SWE-bench Verified | Teste externo | 82,0% | 83,8% | +1,8 |
| Espaço de trabalho | Harvey LAB | Base de evolução | 89,4% | 90,5% | +1,1 |
| Espaço de trabalho | Harvey LAB | Validação interna | 86,9% | 89,2% | +2,3 |
| Espaço de trabalho | JobBench | Teste externo | 36,0% | 40,7% | +4,7 |
| Espaço de trabalho | GDPval | Teste externo | 48,8% | 52,3% | +3,5 |
| Espaço de trabalho | APEX-Agents | Teste externo | 34,2% | 37,9% | +3,7 |
| Engenharia | EngDesign | Base de evolução | 50,0 | 54,9 | +4,9 |
| Engenharia | Frontier-Eng | Teste externo | 17,7 | 22,0 | +4,3 |
Ao avaliar o Gemini 3.5 Flash na tarefa de terminal do Terminal-Bench 2.1, a taxa subiu de 64,6 para 78,7, enquanto no SWE-bench Verified o índice passou de 76,8 para 79,0. Paralelamente, os pesquisadores notaram uma redução no uso de recursos computacionais. No ambiente de trabalho de agentes, o consumo foi de 2,42 milhões de tokens por tentativa contra 3,80 milhões de métodos sem regularização. Há uma divergência pontual nos documentos: o resumo do artigo acadêmico registra uma economia de 30% em tokens de política, ao passo que o site oficial do projeto (abre em nova aba) calcula esse ganho de eficiência em 36%.
Todo o código foi disponibilizado publicamente sob a licença de software livre Apache 2.0 por meio de um repositório no GitHub (abre em nova aba). Projetado como uma estrutura de pesquisa, o pacote exige ambiente Python 3.10 ou superior e aceita conexões com diversos modelos de linguagem. Cada tentativa de melhoria é organizada em ramificações do sistema de versionamento Git, permitindo rastrear detalhadamente o que foi alterado e comprovar se as mudanças trouxeram benefícios reais.
A comunidade tem como foco inicial a aplicação do método em três frentes práticas: agentes que operam terminais de programação, sistemas voltados para análise e manipulação de documentos de escritório e assistentes dedicados a cálculos e projetos de engenharia.