
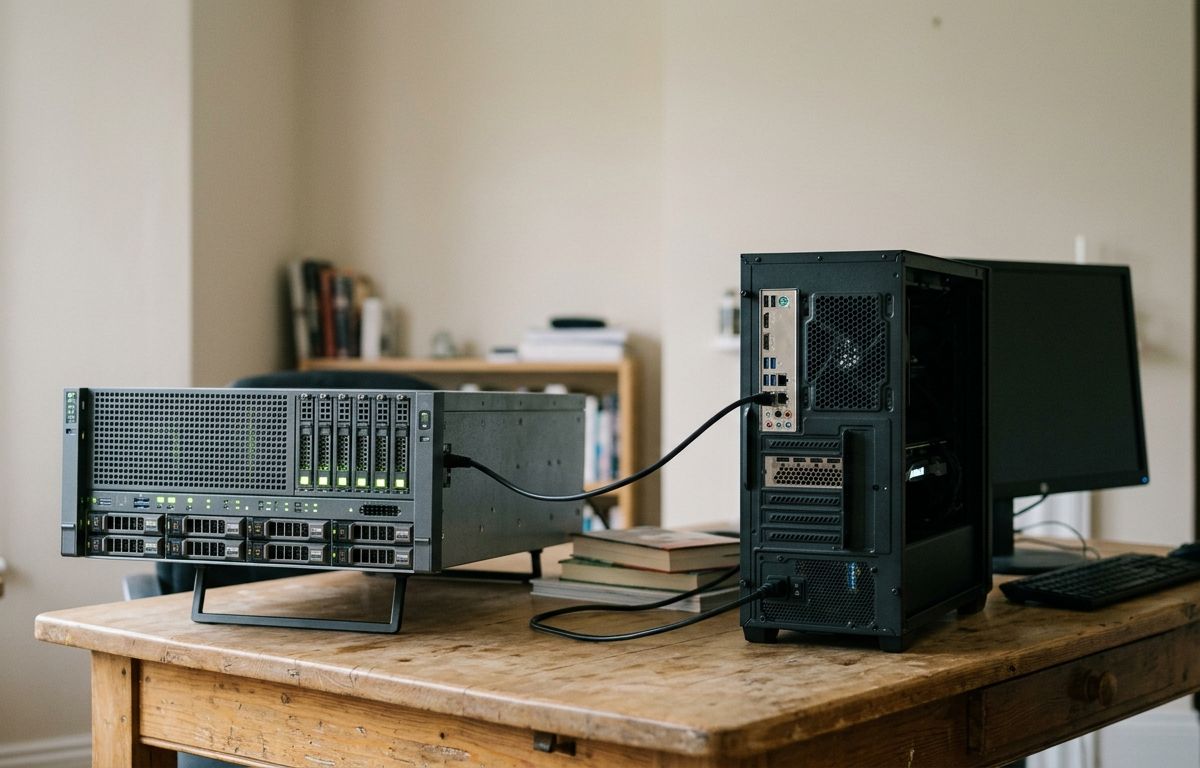
Em 28 de setembro de 2026, foi disponibilizada a ferramenta de código aberto chamada remote-dspark (abre em nova aba), criada para resolver um dos principais limites no uso de modelos de inteligência artificial em servidores potentes: o espaço na memória de vídeo, conhecida tecnicamente como VRAM. O projeto permite transferir uma etapa específica do processamento para uma placa de vídeo comum de computador pessoal, conectada à mesma rede local.
Para entender a função dessa tecnologia, ajuda pensar no funcionamento da técnica chamada de decodificação especulativa. Nessa abordagem, o trabalho de escrita da inteligência artificial é dividido entre dois componentes. Um deles é o modelo rascunho (conhecido pelo termo em inglês draft model), que funciona como um assistente ágil gerando sugestões rápidas de palavras. O segundo é o modelo principal, muito maior e detalhista, que atua como um revisor aprovando ou corrigindo o rascunho. Manter esses dois modelos funcionando juntos dentro dos servidores corporativos de grande porte consome um espaço valioso de memória.
O que o remote-dspark faz na prática
O remote-dspark funciona instalando pequenas modificações de software, chamadas de mods, no sistema de inferência vLLM (abre em nova aba). No cluster principal, essas modificações ativam um intermediário que envia o rascunho para ser processado fora dali. Na ponta externa, uma placa gráfica comum, como os modelos comerciais RTX 3060, RTX 3080 ou RTX 3090 com capacidade de 10 a 24 gigabytes de memória de vídeo, executa um servidor dedicado para responder a essas solicitações.
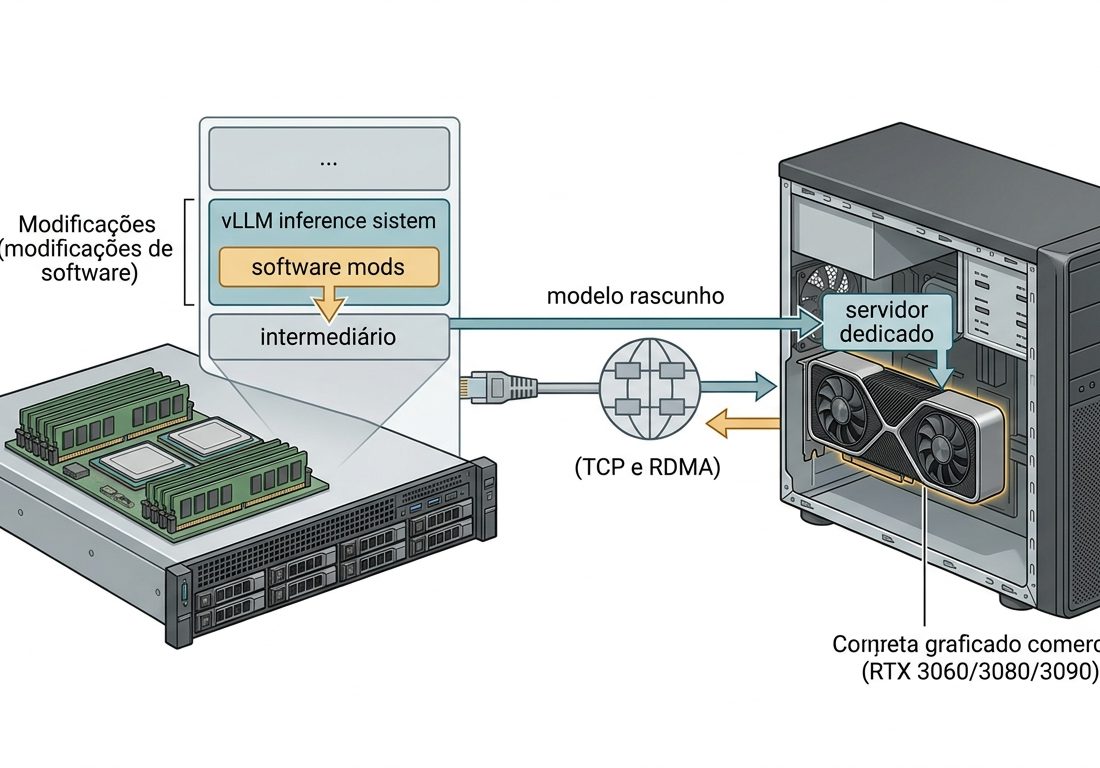
Essa divisão alivia o peso sobre os servidores corporativos NVIDIA DGX Spark com chips GB10. Em um exemplo prático validado com o modelo GLM-5.3 em configuração de quatro nós GB10, a ferramenta liberou cerca de 2,8 gibibytes de VRAM por nó. No conjunto completo dos quatro computadores do cluster, a quantidade total de memória transferida para a placa externa superou os 10 gigabytes.
A memória recuperada com a transferência não fica ociosa. Ela pode ser convertida imediatamente em melhorias práticas para a inteligência artificial:
- Capacidade de contexto ampliada: o espaço extra pode ser usado para expandir o cache KV (que guarda o histórico da conversa), permitindo textos mais longos.
- Maior fidelidade nas respostas: a memória livre permite usar configurações de quantização superiores, que preservam melhor a qualidade original dos cálculos matemáticos do modelo.
- Viabilidade em limites rígidos de hardware: acelera sistemas com orçamentos restritos de memória nos quais o modelo rascunho simplesmente não caberia localmente.
Tecnologias de conexão e compatibilidade
A comunicação entre a máquina com a placa de vídeo comum e o cluster de inteligência artificial pode acontecer por duas vias técnicas distintas. A primeira alternativa usa o protocolo tradicional de rede TCP/IP com o auxílio da biblioteca ZMQ, exigindo apenas que os computadores consigam conversar pelo endereço de rede normal. A rota em TCP/IP é baseada no projeto myshytf/vllm e foi adaptada para aceitar diferentes modelos.
A segunda opção de conexão utiliza a tecnologia RDMA, compatível com redes RoCE versão 2 e InfiniBand. O RDMA permite que os dados viajem direto para a memória sem sobrecarregar a fila do sistema operacional, aproveitando comandos diretos chamados ibverbs. Ambas as vias compartilham os mesmos códigos de operação interna, permitindo que o usuário escolha qual protocolo deseja ativar em suas receitas de configuração.
O fundador e executivo Ciprian Veg, autor do projeto, detalhou o objetivo da ferramenta na data de seu lançamento:
Você precisa de alguma memória extra no seu DGX Spark? Criei este repositório para ajudar os usuários do DGX Spark que possuem uma GPU sobressalente de 10-24 GB em casa a extrair alguma memória extra de um único Spark ou de um cluster de Sparks. Ele move o modelo de rascunho de decodificação especulativa dos seus Sparks para essa GPU: os GB de memória liberados podem ser usados para contexto extra ou melhor qualidade de quantização. Suporta tanto TCP quanto RDMA, distribuído como modificações compatíveis com eugr-vllm.
Em termos de compatibilidade de software, a ferramenta foi projetada no formato compatível com o fork eugr do vLLM, funcionando com imagens baseadas no vLLM versão 0.29 para nós GB10. Do lado da placa externa, o sistema roda um ambiente pronto em contêiner Docker feito para a arquitetura gráfica sm86, correspondente às placas da série 30. O sistema é flexível e não fica preso a uma família fechada de inteligência artificial, tendo validação comprovada tanto no modelo GLM-5.3 quanto no Kimi K3 com rascunhos dedicados. Para quem não deseja usar a rede externa, o sistema opera de forma opcional: basta desmarcar a configuração de endereço remoto para que o cluster volte a rodar o rascunho internamente.