

Nick Cammarata teve papel importante na construção de uma das ideias mais influentes sobre como a IA funciona por dentro. Segundo essa ideia, os "neurônios" de uma rede neural são uma mistura difícil de decifrar. Agora ele diz que essa explicação estava errada. Hoje pesquisador da Goodfire, um laboratório de interpretabilidade, o ex-funcionário da OpenAI (abre em nova aba) publicou um ensaio de cerca de 26 mil palavras. Nele, afirma que já dá para entender a maior parte dos neurônios em modelos de até trilhões de parâmetros.
O texto se chama Neural Networks Are Already Clean (abre em nova aba) ("redes neurais já são limpas", em tradução livre). Na semana passada, segundo a revista The Atlantic, ele ocupou o Vale do Silício por um dia inteiro. Recebeu rótulos como "o ensaio mais importante" e "a melhor notícia" do ano, e foi elogiado até por Sam Altman, CEO da OpenAI.
Se a história chegou a você como uma "descoberta massiva", convém saber de uma coisa antes de qualquer outra. Por enquanto, o que existe é um ensaio que o próprio autor chama de "informal" e de "hipótese de trabalho". O artigo técnico que deveria detalhar os números ainda não tinha sido publicado quando o debate começou.
Mesmo assim, o caso merece atenção. Se a tese se sustentar, ficaria bem mais fácil examinar o que acontece dentro de um modelo de IA. Com isso, seria possível encontrar comportamentos perigosos antes que eles causem dano.
A disputa, em linguagem simples
Modelos de IA são formados por um número enorme de unidades numéricas chamadas neurônios. A interpretabilidade mecanicista é o campo que tenta mapear o funcionamento interno desses sistemas, e um dos seus objetivos é olhar cada neurônio e dizer o que ele faz. A Atlantic lembra por que isso importa: entender o interior dos modelos é um caminho para reduzir riscos como invasões de sistemas feitas pela própria IA, sem ninguém no comando, chatbots que alimentam delírios de usuários e modelos que parecem enganar os pesquisadores.
O obstáculo sempre foi que muitos neurônios pareciam reagir a coisas sem nenhuma relação entre si. A explicação dominante ganhou o nome de superposição. A rede teria mais conceitos para guardar do que neurônios disponíveis e, por isso, espremeria vários conceitos em cada unidade. Se for assim, examinar neurônio por neurônio não leva muito longe.
Cammarata agora discorda. Segundo ele, a confusão vista nos primeiros modelos estudados "não era superposição". Era resultado de "vários problemas comuns, em grande parte corrigíveis".
O neurônio "gato e carro" era um detector de V
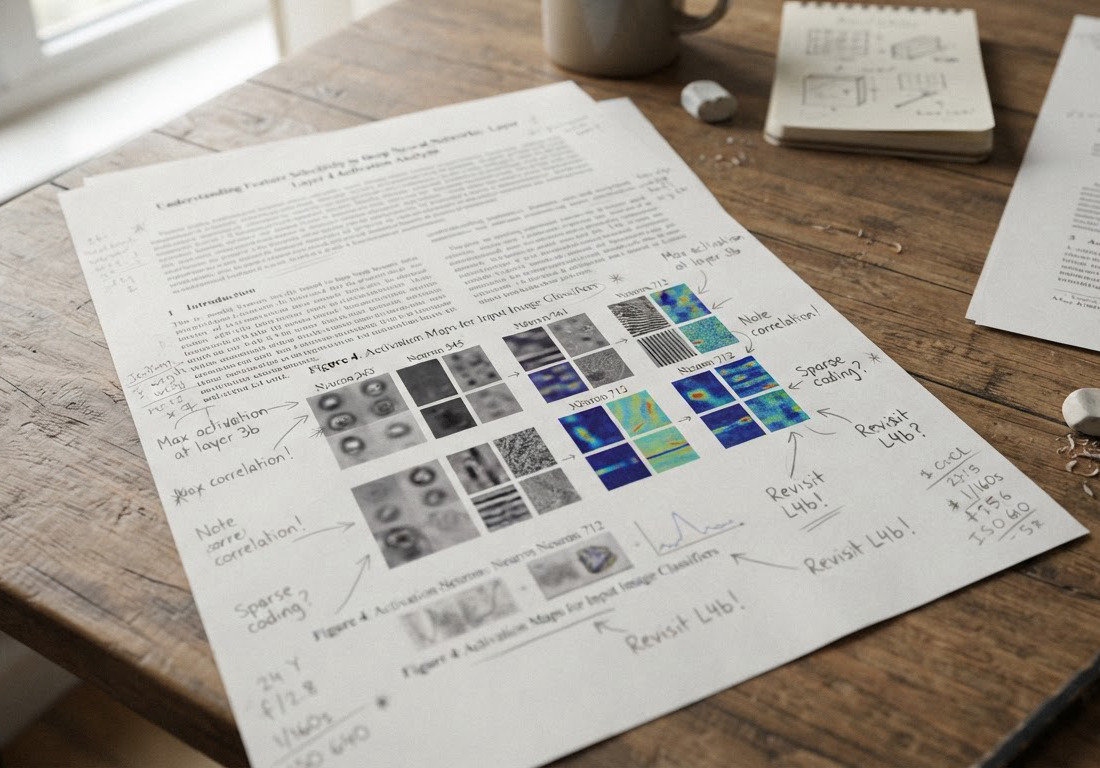
O argumento mais forte do ensaio é também o mais pessoal. Zoom In é um trabalho que Cammarata escreveu com Chris Olah. Nele, um neurônio do InceptionV1, um modelo de reconhecimento de imagens muito estudado na área, virou símbolo do problema. O neurônio 4e:55 disparava para caras e patas de gato e também para a frente de carros. O texto da época dizia que ele não respondia a nenhuma característica comum entre carros e gatos.
A nova leitura de Cammarata é que se trata de um detector de formato em V. O mesmo neurônio é ativado por chamas em forma de V, por jatos de água de barcos de bombeiros e por focinhos de raposa. Na direção oposta, que o ensaio chama de polo negativo, ele reage a formas redondas, como a letra O.
Cammarata também revisa o único circuito de superposição apresentado em Zoom In: um traço de "carro" que aparecia no meio de neurônios ligados a cães. Para ele, isso é só generalização e combinação comuns de conceitos. "Nada lê essa combinação", escreve.
É raro um pesquisador desmontar em público o exemplo mais citado do próprio trabalho, e isso dá peso ao ensaio. Essa também é a parte mais fácil de conferir, porque envolve um neurônio específico de um modelo antigo que a área conhece bem. Já os números sobre os grandes modelos de linguagem são outra história.
De 1,7% para 90%, mas com réguas diferentes
Cammarata conta que, em 2023, iniciou na OpenAI um projeto de interpretabilidade automatizada. O resultado foi que só cerca de 1,7% dos neurônios eram compreensíveis, mesmo pelo critério mais generoso. As auditorias preliminares da Goodfire, com contribuição de Curt Tigges na parte sobre modelos de linguagem, apontam o contrário.
| Medição | Modelo | Resultado relatado |
|---|---|---|
| Projeto automatizado iniciado por Cammarata na OpenAI (2023) | não especificado | cerca de 1,7% dos neurônios interpretáveis, pelo critério mais generoso |
| Auditoria preliminar da Goodfire | Qwen3-32B | ~90% dos polos com uma tarefa principal; ~7% com duas tarefas relacionadas; 2% a 4% ainda não compreendidos |
| Retreino com melhorias comuns de arquitetura, sem mudar tamanho nem dados | InceptionV1 (última camada) | 99% a 100% dos neurônios "facilmente interpretáveis" |
O ensaio conta separadamente as duas direções em que um neurônio pode ser ativado, a positiva e a negativa. Por isso fala em "polos". No caso do gato e carro, o polo positivo seria o V e o negativo, as formas redondas. Cammarata diz ter encontrado resultados parecidos em modelos de até trilhões de parâmetros, como o Kimi K3. Os detalhes ficaram para o artigo técnico.
É o salto de 1,7% para 90% que rende manchete. Só que as duas medições vêm de anos, modelos e métodos diferentes. O próprio autor avisa que os percentuais dependem do critério usado para decidir que um neurônio faz "uma coisa só". Com outro critério, o número muda.
Para quem trabalha com IA, o dado mais interessante talvez seja o do retreino do InceptionV1. Bastaram melhorias comuns de arquitetura, sem aumentar o modelo nem trocar os dados, para que quase toda a última camada ficasse legível. Se isso se repetir em modelos de linguagem, tornar uma IA mais transparente pode virar uma questão de engenharia, e não de reinventar a área. Por enquanto, porém, é um resultado obtido em uma única camada de um modelo de imagem.
O que está provado e o que não está
As reações confirmam que a questão está em aberto. Roon, funcionário da OpenAI que publica sob pseudônimo, escreveu que o trabalho "pode ser lembrado como um grande momento da história da ciência", mas ressalvou que outros ainda precisam confirmar os resultados.
Neel Nanda, que lidera a equipe de interpretabilidade do Google DeepMind, achou o trabalho interessante, mas disse que ele não muda o quadro geral. Ele continua achando que a superposição é real e espera que a análise baseada em neurônios tenha falhas sérias.
Parte dos elogios mais entusiasmados veio de dentro da OpenAI, a casa onde Cammarata trabalhou. A crítica mais dura veio de quem comanda uma equipe rival dedicada exatamente a esse problema. Por enquanto, o entusiasmo está à frente das provas.
O que muda para quem lê
Na prática, nada por enquanto. Não há código, modelo, API ou produto associado ao ensaio, e ninguém documentou ganho de custo ou de eficiência para empresas. O que existe é o próprio texto, publicado na web e em inglês.
Vale acompanhar três coisas. A primeira é o artigo técnico, que precisa mostrar como os números foram medidos e qual critério define "uma tarefa só". A segunda são as tentativas de outros grupos de reproduzir os resultados, sobretudo os que defendem a superposição. A terceira é se os 90% observados no Qwen3-32B se repetem em outros modelos com o mesmo rigor.
Até lá, a melhor descrição continua sendo a do próprio Cammarata: uma hipótese de trabalho, defendida por alguém que já esteve do outro lado dessa discussão.