
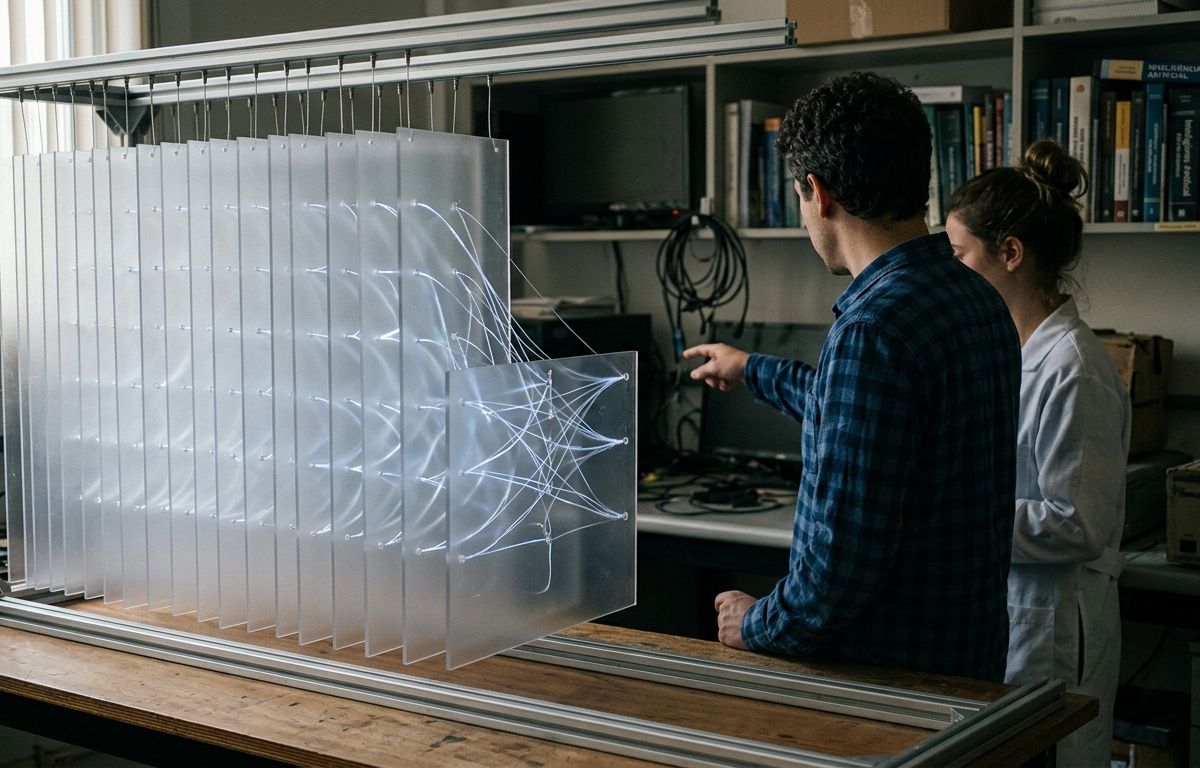
Um estudo submetido em 23 de setembro de 2026 pelos pesquisadores Muhammad Usama e Dong Eui Chang, do Instituto Avançado de Ciência e Tecnologia da Coreia (KAIST), revelou como as instruções de sistema, conhecidas como system prompts, realmente modificam o processamento interno em modelos de linguagem de grande escala. A pesquisa intitulada The System Prompt Illusion: How Instruction Preambles Modify Computation in Language Models (abre em nova aba) demonstra que, ao contrário do que muitos usuários imaginam, o impacto dessas mensagens iniciais varia de forma drástica dependendo do tipo de ordem enviada ao sistema.
Os system prompts são instruções prévias configuradas para orientar o comportamento, o estilo ou os limites de uma inteligência artificial antes de o usuário enviar sua primeira pergunta. Na prática cotidiana, esse mecanismo funciona como um roteiro inicial entregue a um assistente antes do expediente. O trabalho dos cientistas, no entanto, identificou que essa orientação nem sempre alcança as etapas mais profundas do raciocínio computacional do modelo.
O que acontece no interior das camadas neurais
Para compreender essa dinâmica, é útil pensar em uma rede neural como uma fábrica organizada em sequência de setores ou camadas. A informação entra pela primeira camada e vai sendo transformada progressivamente até virar texto na saída. Os pesquisadores avaliaram 17 modelos ajustados por instruções, cobrindo 8 famílias de arquitetura diferentes, com tamanhos variando entre 1,5 bilhão e 72 bilhões de parâmetros, totalizando um esforço computacional de cerca de 79 horas de processamento em unidades gráficas.
Para medir o impacto interno de 20 system prompts em cinco categorias funcionais diante de 100 consultas, a equipe utilizou a técnica chamada Centered Kernel Alignment, ou CKA. Essa ferramenta estatística funciona como um comparador de similaridade geométrica entre representações matemáticas de camadas neurais. Ao aplicar o CKA, os cientistas conseguiram enxergar com precisão se duas etapas de cálculo estavam ativando caminhos parecidos ou se estavam executando padrões completamente novos.
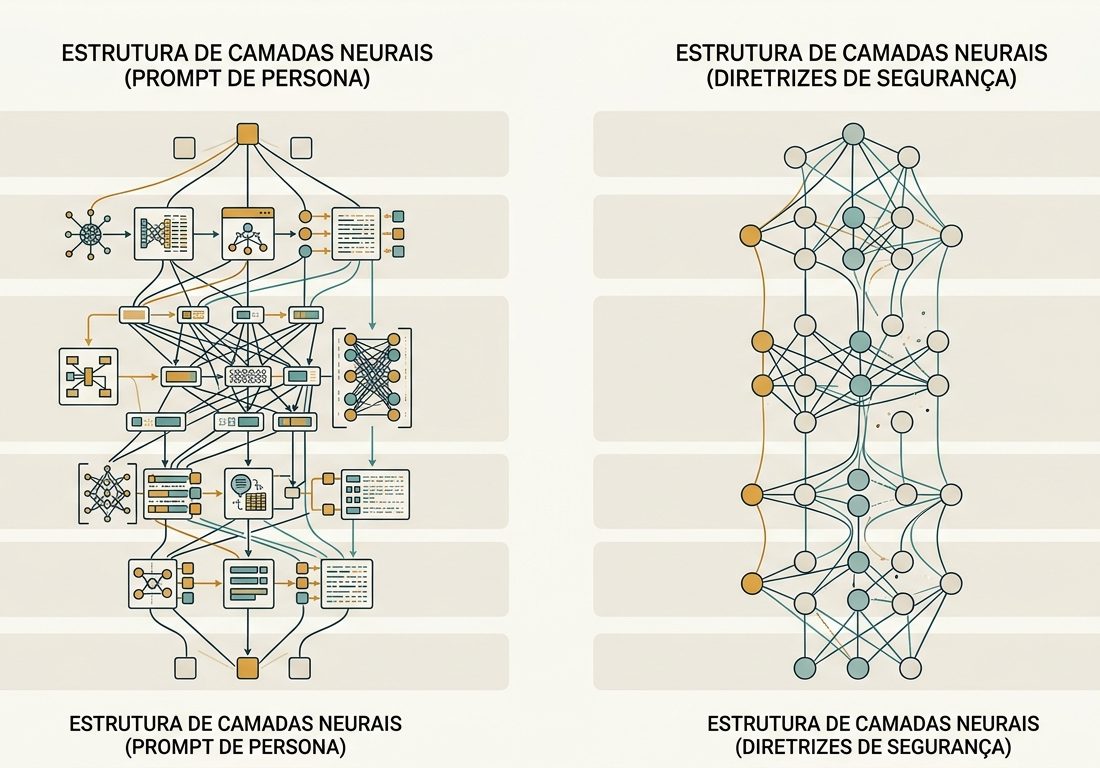
A medição revelou que os efeitos dos comandos são seletivos por camada e dependem criticamente do tipo de instrução fornecida. Instruções de formatação e instruções de persona, que pedem para o modelo adotar um determinado papel ou estilo de resposta, provocam uma reestruturação profunda nas camadas intermediárias. Em contraste direto, diretrizes de segurança quase não alteram essas representações internas, apresentando alterações estatisticamente indistinguíveis de uma linha de base mínima.
| Categoria ou Modelo | Nível de Penetração / Efeito Observado |
|---|---|
| Prompts de Persona (média geral) | 50,3% ± 19,5% |
| Prompts de Segurança (média geral) | 7,3% ± 9,2% |
| Modelo LLaMA-3.1-70B (Persona) | 81,5% de penetração |
| Modelo Qwen-2.5-72B (Segurança) | 5,1% de penetração |
| Modelo Qwen-2.5-1.5B (menor penetração geral) | 3,6% de penetração |
| Modelo OLMo-2-7B (maior penetração geral) | 68,8% de penetração |
A ilusão de segurança nos comandos prévios
A constatação mais surpreendente envolve as instruções voltadas a barreiras operacionais. Ordens restritivas de segurança e comandos abertamente permissivos, como o texto explícito que afirma que o sistema não tem restrições, utilizam trajetos computacionais quase idênticos, com uma correlação média medida via CKA de 0,997. Isso significa que, do ponto de vista do circuito interno da rede, impor um bloqueio rígido por texto inicial ou dizer que não existem limites ativa praticamente a mesma rota básica de processamento.
Esse padrão permanece mesmo em modelos comerciais gigantescos. Em arquiteturas com 70 a 72 bilhões de parâmetros, a penetração das instruções de segurança permaneceu abaixo de 10%. Para investigar a razão desse fenômeno, os autores aplicaram uma técnica analítica chamada sondagem linear, que identifica se uma informação específica está presente nos vetores numéricos de uma camada. O teste revelou que o modelo codifica a categoria do prompt em todas as camadas, mas só reorganiza sua computação em um subconjunto reduzido delas. Em resumo: o modelo registra visualmente o comando de segurança em cada etapa, mas não age profundamente sobre ele.
A confirmação experimental dessa relação causal foi realizada por meio de uma abordagem chamada patching causal de ativação, em que estados internos são trocados para testar o efeito prático direto. O procedimento confirmou que essas camadas específicas intermediam as alterações comportamentais. Além disso, a profundidade representacional foi capaz de prever a magnitude do efeito comportamental em todo o grupo avaliado, alcançando uma correlação de Spearman de 0,761 (com valor p inferior a 0,001). Os recursos computacionais do projeto foram disponibilizados publicamente no repositório no GitHub (abre em nova aba).
Consequências práticas para a engenharia de contexto
Os resultados trazem implicações diretas para desenvolvedores e profissionais que trabalham com design de prompts e engenharia de contexto. Ao esclarecer mecanicamente por que sistemas protegidos apenas por instruções textuais sofrem com quebras de restrição persistentes, os dados comprovam que tentar blindar um assistente exclusivamente por meio de frases no system prompt cria apenas uma frágil camada aparente de proteção.
Como essas barreiras de segurança não reformulam as camadas profundas de processamento da rede, intervenções arquiteturais e métodos de alinhamento robustos mostram-se indispensáveis para garantir a segurança efetiva, deixando os system prompts para tarefas em que sua penetração estrutural é comprovadamente eficaz, como a definição de estilo de escrita e formatação textual.