
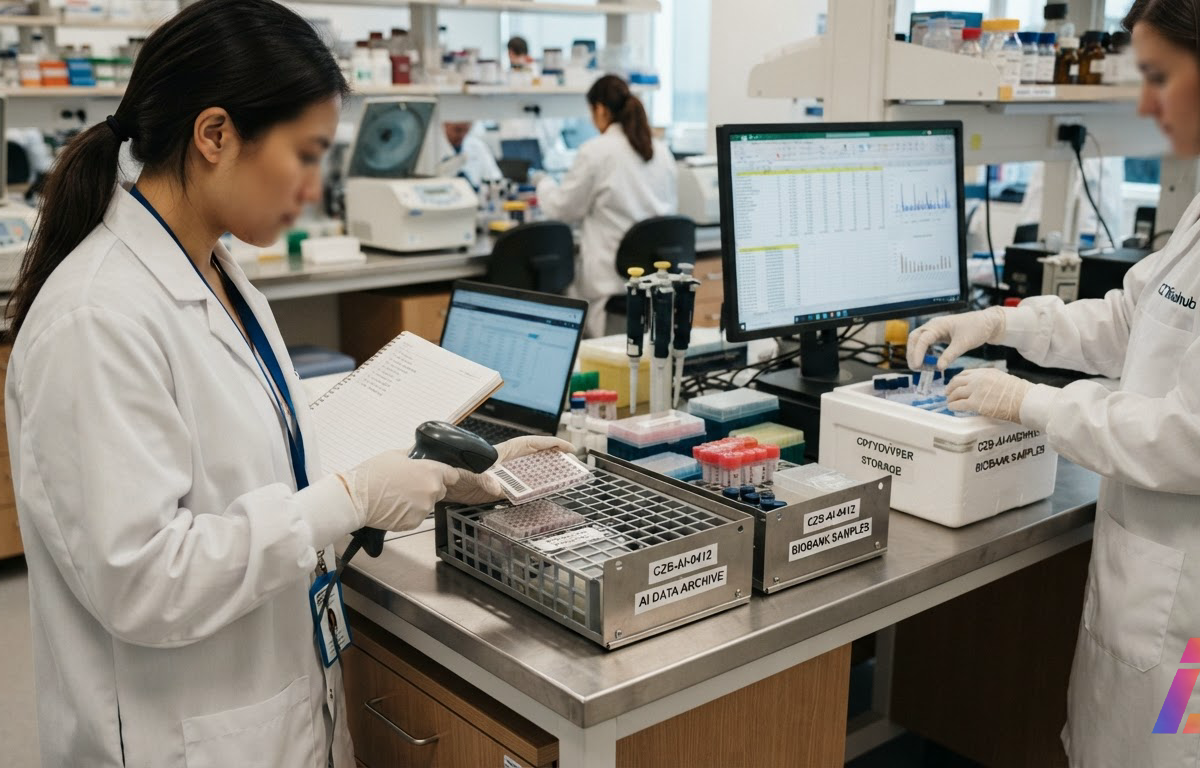
A inteligência artificial aprendeu a ler e a escrever porque alguém, em algum momento, organizou a bagunça. Os modelos de linguagem que hoje respondem perguntas foram treinados com volumes enormes de texto digitado, digitalizado e padronizado. Na biologia, a matéria-prima é bem menos colaborativa: décadas de experimentos vivem espalhados em formatos incompatíveis, artigos, planilhas de laboratório e arquivos de imagem que um programa de computador não consegue combinar. Um modelo de IA diante disso lembra menos um cientista e mais um estagiário genial contratado para organizar um arquivo cujas pastas ninguém sabe onde estão.
Foi contra essa desordem que o Chan Zuckerberg Biohub (abre em nova aba) anunciou, em 7 de outubro de 2026, uma expansão da Virtual Biology Initiative. A organização sem fins lucrativos, ligada ao CEO da Meta, Mark Zuckerberg, e à médica Priscilla Chan, apresentou o plano junto com o Departamento de Energia dos Estados Unidos (DOE), os Institutos Nacionais de Saúde (NIH) e novos financiadores. O total comprometido soma US$ 1,8 bilhão em dinheiro, dados, capacidade de computação e tecnologia de medição. Segundo o próprio Biohub, trata-se do maior compromisso coordenado já feito para gerar dados biológicos que possam treinar modelos de IA.
Quem entra com o quê
Os recursos vêm de fontes diferentes, com papéis diferentes. Vale olhar a divisão antes de tratar o número como um bloco só:
| Participante | Aporte anunciado | Para quê |
|---|---|---|
| Chan Zuckerberg Biohub | US$ 500 milhões (compromisso fundador, de abril de 2026) | US$ 400 milhões em tecnologias de medição e US$ 100 milhões em pesquisa fora do Biohub |
| Departamento de Energia (DOE) | Mais de US$ 500 milhões em cinco anos | Medição em laboratório, modelagem e computação, por meio do projeto Genesis Mission |
| NIH | Mais de US$ 500 milhões (investimento federal anterior) | Coordenação de bases de dados e repositórios já existentes |
| Google DeepMind, Isomorphic Labs e Meta | US$ 300 milhões somados | Tecnologias e conjuntos de dados para modelos preditivos |
Uma ressalva importa. Os valores vêm do comunicado do Biohub. A Reuters noticiou os números atribuindo-os ao anúncio e registrou que não teve acesso a documentos separados do DOE, do NIH ou das empresas que confirmassem os totais de forma independente. O compromisso, portanto, está anunciado; a liberação de cada parcela ainda precisará ser acompanhada.
O que são dados "prontos para IA"
O termo que aparece no anúncio, "AI-ready biological data", descreve dados digitais padronizados, descritos de modo que algoritmos consigam usá-los para aprender padrões. Não basta ter muitas imagens de células ou muitas estruturas de proteínas: os dados precisam ser comparáveis entre si, com formatos comuns e informações que expliquem o que cada medida significa. É a diferença entre uma gaveta com mil fotos soltas e um álbum datado e legível.
O objetivo declarado da iniciativa é gerar exatamente esse tipo de material para treinar modelos preditivos da biologia. A conta oficial do Biohub na rede X resumiu a parte empresarial do plano:
Além disso, Google DeepMind, Isomorphic Labs e Meta estão investindo coletivamente US$ 300 milhões na Virtual Biology Initiative para criar as tecnologias e os conjuntos de dados multimodais necessários para construir modelos preditivos da vida.
"Multimodal" aqui significa dados de tipos distintos combinados: imagens de células, estruturas moleculares, medidas de laboratório. A Meta entra pelo braço de pesquisa, o Google DeepMind é o laboratório de IA do grupo Alphabet e a Isomorphic Labs atua no desenvolvimento de medicamentos apoiado em IA.
O que já existe e o que é promessa
A Virtual Biology Initiative não nasceu agora. Ela havia sido anunciada em abril de 2026, com os US$ 500 milhões fundadores do próprio Biohub, divididos em US$ 400 milhões para tecnologias de medição (entre elas tomografia crioeletrônica, uma técnica que fotografa moléculas e células congeladas em detalhamento quase atômico, e microscópios capazes de registrar de milhões a bilhões de células em tecido vivo) e US$ 100 milhões para pesquisa conduzida fora da organização.
A expansão adiciona o poder público americano. O DOE vai direcionar mais de US$ 500 milhões em cinco anos ao projeto Genesis Mission, que envolve supercomputadores da classe exaescala (as máquinas mais rápidas em operação, capazes de bilhões de bilhões de cálculos por segundo), dispersão de raios X e nêutrons para sondar materiais, microscopia crioeletrônica e laboratórios autônomos, nos quais robôs executam experimentos sem intervenção humana a cada etapa.
O NIH, por sua vez, não é dinheiro novo: a organização vai coordenar bases de dados e repositórios construídos com mais de US$ 500 milhões em investimento federal anterior, e o Biohub trabalhará para padronizá-los para treinamento de modelos. Outros participantes citados no anúncio incluem o Allen Institute, o Broad Institute, os Gladstone Institutes, o Wellcome Sanger Institute, a NVIDIA, a Renaissance Philanthropy e dois grandes projetos de catalogação biológica, o Human Cell Atlas e o Human Protein Atlas, que mapeiam células e proteínas humanas.
Os prazos, nesses casos, são expectativa, não resultado medido. Alex Rives, chefe de ciência do Biohub, disse à Reuters que um trabalho desse porte levaria normalmente décadas e que o objetivo dos parceiros é comprimi-lo em cinco anos. Segundo ele, um primeiro conjunto de dados deve ficar pronto em cerca de um ano, e ele espera modelos preditivos precisos dentro de cinco anos. A meta final é uma "célula virtual": um modelo capaz de prever o comportamento de uma célula diante de estímulos, do mesmo jeito que um modelo de previsão do tempo antecipa a chuva. Nenhum desses marcos existe ainda; são promessas de um projeto em curso.
Dados abertos, com condições ainda pouco detalhadas
A Reuters descreveu o objetivo como conjuntos de dados abertos para treinar modelos de IA na pesquisa biológica. Para quem trabalha com ciência no Brasil, isso teoricamente amplia o alcance: dados abertos dispensam parcerias formais com as instituições originais para serem consultados. O anúncio disponível, porém, não detalha licenças de uso, requisitos de cadastro ou eventuais restrições por país. Quem planejar usar o material precisará aguardar a publicação dos primeiros conjuntos e das regras que os acompanharão.
Há uma tensão embutida no plano. A promessa é de dados abertos, mas quem coloca dinheiro inclui empresas que competem entre si no desenvolvimento de modelos biológicos e de medicamentos, e a coordenadora do esforço é uma organização financiada por um casal de bilionários ao lado de agências públicas. Como essas forças vão dividir o controle sobre um ativo tão disputado, os comunicados não explicam.
Por ora, o que se tem é um compromisso de US$ 1,8 bilhão, um cronograma otimista e a adesão de quase todos os grandes nomes da área. O primeiro teste prático chega quando o primeiro conjunto de dados for publicado, em cerca de um ano, segundo a previsão de Rives. Até lá, a maior aposta em dados biológicos para IA continua sendo exatamente isso: uma aposta.
Perguntas frequentes
O que significa "dados biológicos prontos para IA"?
São dados digitais padronizados e descritos de forma comparável, para que algoritmos consigam treiná-los e extrair padrões. O problema atacado pelo projeto não é a falta de dados biológicos, mas a falta de organização deles.
Os US$ 1,8 bilhão são dinheiro novo?
Em parte. O Biohub já havia comprometido US$ 500 milhões em abril de 2026, e parte do total se refere a mais de US$ 500 milhões em investimento federal anterior do NIH, cujos dados serão coordenados e padronizados. O anúncio de 7 de outubro soma todas essas parcelas.
O que é a "célula virtual" buscada pelo projeto?
É um modelo preditivo capaz de antecipar o comportamento de células biológicas a partir de dados. Segundo Alex Rives, chefe de ciência do Biohub, a expectativa é de modelos preditivos precisos em até cinco anos, mas isso ainda é uma meta, não um resultado comprovado.
Pesquisadores brasileiros vão poder acessar esses dados?
O objetivo divulgado é produzir conjuntos de dados abertos, o que em princípio permite consulta por qualquer pessoa interessada. As licenças, os requisitos de cadastro e as eventuais restrições de uso ainda não foram detalhados no anúncio.