

Uma das ideias mais influentes da DeepSeek (abre em nova aba) é um jeito de economizar memória. Chama-se atenção latente multi-cabeça (MLA, na sigla em inglês) e foi apresentada em maio de 2024 no artigo do DeepSeek-V2 (abre em nova aba). Dois anos e meio depois, virou peça de série. Está no DeepSeek-V3 e no R1, aparece também no Kimi K2 e no GLM-5, e programas populares para rodar modelos já guardam os dados no formato compacto que ela permite.
O alvo da técnica é o chamado cache KV. Para escrever cada nova palavra, um modelo de linguagem precisa consultar tudo o que já foi dito na conversa. Para não refazer essas contas toda vez, ele guarda resultados intermediários de cada token (os pedaços de palavra que o modelo lê). Esses resultados se chamam "chaves" e "valores", daí o K e o V. O problema é que essa memória cresce a cada token, cresce de novo a cada usuário atendido ao mesmo tempo e ocupa a memória da placa de vídeo, que é limitada.
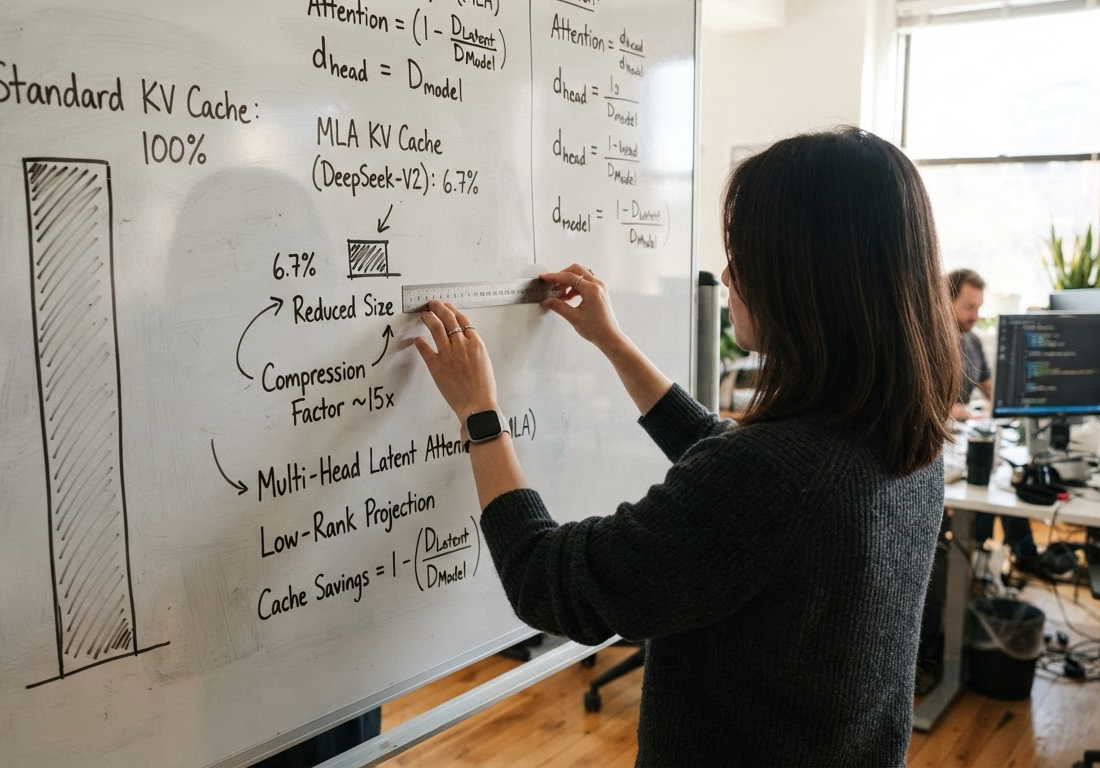
A DeepSeek afirma que a MLA reduziu esse cache em 93,3%. O número é real, mas vale entender contra o que foi medido, quanto dele se confirma fora da empresa e quem, de fato, sente a diferença no bolso.
Um resumo no lugar de 128 cópias
Num modelo convencional, cada "cabeça" de atenção guarda a própria chave e o próprio valor para cada token. As cabeças são as várias partes do mecanismo que olham o texto em paralelo, e no DeepSeek-V2 elas são 128. A MLA troca isso por um único vetor comprimido por camada, com 512 números, e o modelo trabalha a partir desse resumo.
A informação sobre a posição de cada palavra no texto é codificada por uma técnica chamada RoPE. Ela ficou fora da compressão e ganhou uma fatia separada de 64 números, que também precisa ir para o cache. A conta final é de 576 números por token em cada camada.
Segundo a DeepSeek, isso deixa o cache do tamanho do de um esquema já bem enxuto, o GQA, que faz várias cabeças compartilharem a mesma chave e o mesmo valor, configurado com apenas 2,25 grupos. A empresa diz ainda que a qualidade supera a da atenção completa, sem compartilhamento. A economia de memória pode ser conferida por qualquer um na configuração pública dos modelos. A parte da qualidade continua sendo alegação da DeepSeek.
De onde vem o 93%
O corte de 93,3% compara o DeepSeek-V2 com o DeepSeek 67B, modelo denso anterior da própria empresa. A régua, portanto, é caseira. Na mesma comparação, a DeepSeek relata 42,5% menos custo de treinamento e uma capacidade máxima de geração 5,76 vezes maior. Em números absolutos, são mais de 50 mil tokens por segundo num único servidor com 8 GPUs H800, medidos com a distribuição real de pedidos do serviço que rodava o 67B.
Esses números precisam ser lidos com cuidado. A economia no treino vem principalmente da outra metade da arquitetura, a DeepSeekMoE, que ativa só 21 bilhões dos 236 bilhões de parâmetros a cada token. A velocidade, por sua vez, foi medida com os pesos convertidos para FP8 e com cada elemento do cache comprimido para cerca de 6 bits em média. A MLA é uma peça importante do salto de 5,76 vezes, mas não explica o salto sozinha.
A conta feita fora da DeepSeek
Duas calculadoras de memória publicadas entre 16 e 18 de outubro de 2026 partem do arquivo de configuração do DeepSeek-V3 e chegam ao mesmo resultado: cerca de 69 KB de cache por token, ou 70.272 bytes nas 61 camadas, em precisão FP16. Numa conversa de 32 mil tokens, isso dá 2,1 GB. Se o mesmo modelo guardasse chaves e valores completos para todas as cabeças, seriam 53,4 GB. O corte fica em torno de 96%, na mesma ordem de grandeza do que a DeepSeek anunciou, ainda que a comparação seja outra.
A economia não fica só no papel. Segundo uma das calculadoras, o vLLM (abre em nova aba) e o llama.cpp (abre em nova aba), dois dos programas mais usados para rodar modelos abertos, guardam diretamente o vetor comprimido, e não a versão expandida.
O contraste mais revelador está dentro da própria família R1. As versões "destiladas", que muita gente baixa para rodar em casa, são construídas sobre o Llama e o Qwen e usam o esquema tradicional de cabeças compartilhadas, sem MLA:
| Modelo | Cache por token (FP16) | Cache com 32 mil tokens | Cache com 128 mil tokens | Pesos em 4 bits |
|---|---|---|---|---|
| DeepSeek R1 Distill Llama 8B | 128 KB | 4 GB | 16 GB | 5 GB |
| DeepSeek R1 Distill Qwen 32B | 256 KB | 8 GB | 32 GB | 20 GB |
| DeepSeek-V3 / R1 (671B, com MLA) | ~69 KB | 2,1 GB | 9,2 GB | 369 a 405 GB |
O modelo de 671 bilhões de parâmetros gasta, por token, pouco mais da metade do cache do modelo de 8 bilhões e cerca de um quarto do de 32 bilhões. No destilado de 8B com contexto máximo, o cache chega a ocupar três vezes mais memória do que o próprio modelo.
O preço da economia: mais contas
Comprimir não sai de graça. Em junho de 2025, Robin Geens e Marian Verhelst publicaram o que descrevem como a primeira análise da MLA centrada em hardware (abre em nova aba). Eles identificaram duas maneiras de executar a técnica. A primeira reaproveita as matrizes que fazem a ponte entre o resumo comprimido e o resto do modelo. A segunda recalcula essas matrizes. Cada opção troca cálculo por acesso à memória em proporções diferentes.
A conclusão principal é que a MLA desloca o gargalo. Num modelo convencional, a fase de geração passa boa parte do tempo esperando dados chegarem da memória. Com a MLA, o limite tende a passar a ser a capacidade de cálculo do chip. Segundo os autores, o desempenho fica mais estável e eficiente do que na atenção tradicional, sobretudo em hardware com pouca banda de memória.
Há uma ressalva importante: os resultados vêm de simulações feitas com a ferramenta de modelagem Stream, em várias plataformas hipotéticas, e não de medições em chips reais. Mesmo assim, a análise ajuda a explicar por que a técnica se espalhou. Ela dá a quem desenha ou escolhe hardware uma variável a mais para ajustar.
O que muda para quem usa
Para quem quer rodar o DeepSeek completo em casa, quase nada muda, porque o problema são os pesos do modelo, não o cache. Pelas contas de uma das calculadoras, os números ficam assim:
- Em FP8: o V3/R1 ocupa 671 GB só de pesos e pede 746 GB para atender um usuário numa conversa de 8 mil tokens.
- Em 4 bits: são 411 GB.
- Com 32 usuários de 8 mil tokens em FP8: a conta sobe para 766 GB. Os 31 usuários extras acrescentam só uns 20 GB.
Esse último dado mostra quem mais ganha com a MLA: quem atende muita gente ao mesmo tempo ou oferece contextos longos. São os provedores de API e as empresas que mantêm servidores próprios. A economia de cache, por si só, não aparece como redução de preço em nenhuma tabela pública. Mas atender mais conversas com a mesma máquina é exatamente o tipo de alavanca que permite cobrar menos, e a DeepSeek vem construindo sua reputação justamente em cima de eficiência.
A técnica também ajuda a separar o nome da coisa. Se você usa o R1 por API ou num servidor com vLLM, a MLA já está trabalhando a seu favor. Se baixou um "R1" de 8B para o notebook, ela não está lá.