
Notícia
CLM-8B supera Jev em velocidade, mas perde acurácia em dois testes
Modelo aberto da classe Contrastive Language Models usa codificadores separados de estado e ação para tomar decisões mais rápido que o Jev, com troca de acurácia em tarefas de ferramentas e navegação.
O que foi anunciado
O CLM-8B (abre em nova aba) foi apresentado como o primeiro modelo aberto da classe dos Contrastive Language Models, ou CLMs. Em vez de gerar texto token a token, ele recebe uma descrição do estado atual de uma tarefa e uma lista de ações candidatas, compara representações vetoriais e devolve probabilidades para cada opção. O anúncio é atribuído a Jacky Kwok, de Stanford, em trabalho conjunto com Hazy Research, na data de 23 de setembro de 2026. Uma descrição inicial do projeto cita pesquisadores de Stanford e Nvidia, uma divergência de atribuição que as evidências não resolvem. O TypeSafe Jev, modelo proprietário da mesma categoria chamada System One, entrou em acesso antecipado limitado em 15 de setembro de 2026 e devolve valores tipados com probabilidades em vez de texto.
A proposta do CLM-8B é atacar decisões limitadas, como roteamento de ferramentas, triagem de tickets, seleção de resultados de recuperação e escolha entre saídas propostas. Já o Jev, segundo a TypeSafe, é um amostrador paralelo que calcula todas as saídas em uma única passagem. A empresa também afirma que o Jev é 193,6 vezes mais rápido e 444,6 vezes mais barato que LLMs de fronteira, uma alegação corporativa que não aparece acompanhada de medição independente nas evidências disponíveis.
Como o CLM-8B decide
A arquitetura separa estado e ação em dois codificadores. O backbone é um Qwen3-8B (abre em nova aba) congelado, e sobre ele ficam dois cabeçotes de projeção treináveis, um para estados e outro para ações, com cerca de 20 milhões de parâmetros cada. O treinamento usa uma perda contrastiva chamada InfoNCE, que aproxima pares corretos de estado e ação e afasta pares incorretos. O processo ocorre em três etapas: cerca de 60 milhões de pares de perguntas e respostas para ensinar correspondência semântica ampla, aproximadamente 30 milhões de negativos difíceis sintéticos e cerca de 1 milhão de trajetórias de agentes para adaptar o modelo a decisões.
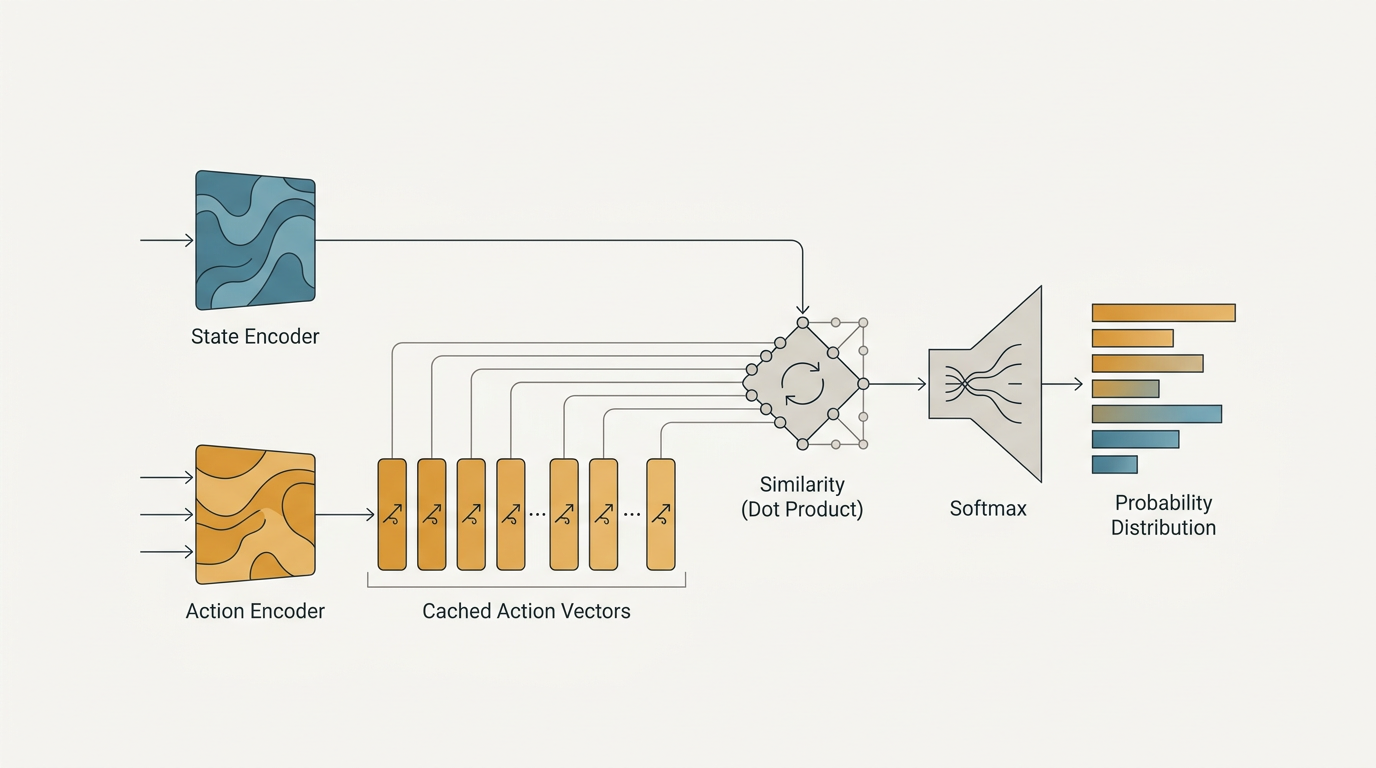
Na inferência, o modelo codifica o estado, compara essa representação com as ações candidatas e escolhe a mais próxima. A similaridade é calculada por produto escalar, e um softmax transforma os escores em distribuição de probabilidades. Como os dois lados são codificados separadamente, um conjunto fixo de ações pode ser codificado uma vez e armazenado em cache. Cada nova requisição exige apenas codificar o estado que muda e compará-lo com as ações já cacheadas. O repositório oficial (abre em nova aba) publica o modelo com API compatível com a interface da TypeSafe e três tipos de pergunta: probabilidade de uma afirmação ser verdadeira, escolha entre opções declaradas e escore em uma escala ordenada.
Números e benchmarks
Nos testes zero-shot divulgados, o CLM-8B foi até 9 vezes mais rápido que o Jev e igualou a taxa de sucesso em duas tarefas de jogos. Em outras duas, perdeu acurácia. No benchmark de chamadas de ferramentas BFCL v4, marcou 95,2% contra 99,2% do Jev. No WikiRacing, completou 26 de 30 tarefas, enquanto o Jev completou as 30. No T-Rex, o CLM-8B levou 16,5 milissegundos por decisão, contra 149,8 milissegundos do Jev, e ambos acertaram as cinco tentativas. Os maiores ganhos de velocidade aparecem quando o modelo reutiliza ações em muitos estados ou escolhe entre um conjunto grande de candidatos.
Há divergência sobre o teto do ganho. A documentação do modelo informa que, com cerca de 1.000 candidatos, o CLM-8B é 13 vezes mais rápido que o Jev. Um resumo comunitário cita medições de 4 a 13 vezes. Os 9 vezes aparecem como resultado principal em testes de zero-shot. Além disso, testes separados com cabeçotes verificadores ajustados para tarefas específicas superaram o Jev em subconjuntos reservados: 81,6% contra 71,1% no DeepSWE e 87,6% contra 83,1% no Terminal-Bench 2.1. Esses resultados não estabelecem desempenho zero-shot nem acurácia no benchmark completo.
Limitações e implicações
A velocidade não é uma vitória limpa. O próprio conjunto de testes mostra troca entre tempo e qualidade: o CLM-8B é mais rápido, mas comete mais erros em chamadas de ferramentas e no WikiRacing. O ganho de cache depende de um conjunto de ações limitado, estável e enumerável. Se as ações candidatas forem regeneradas a cada chamada, não há o que cachear e a vantagem desaparece. O modelo ainda executa um codificador de 8 bilhões de parâmetros, e os pesquisadores não apresentam comparação direta de custo em dólares com APIs de fronteira, portanto não há redução específica de custo de hospedagem estabelecida.
Para desenvolvedores, a adaptação a um domínio não exige ajustar todo o modelo de 8 bilhões de parâmetros. O backbone Qwen3-8B permanece congelado enquanto os cabeçotes menores de estado e ação são treinados. A equipe afirma que o objetivo contrastivo tende a ser eficaz em tarefas de decisão quando comparado ao ajuste supervisionado padrão com perda de entropia cruzada, e que inicializar a partir de um checkpoint pré-treinado do CLM permite adaptação rápida a tarefas específicas. Um CLM multimodal de 35 bilhões de parâmetros está em treinamento, com lançamento anunciado para o início de outubro de 2026. A questão prática é se cada fluxo de trabalho tolera a perda de acurácia em troca da latência menor.
Fontes
- Stanford and Nvidia's open CLM-8B caches reusable ... — venturebeat.com · 25/09/2026
- Contrastive-LM Releases an Open Model for Faster Agent ... — superpowerdaily.com · 24/09/2026
- Empirical Comparison of 40% Inference Token Reduction Models and the Emergence of Open-Source CLM Alternatives to Jev|東リ屋 — note.com
- What is a Contrastive Language Model (CLM)? — sanity.io · 24/09/2026
- Contrastive-LM Releases CLM-8B: An Open System One ... — marktechpost.com · 24/09/2026
- Jev AI Explained: TypeSafe's 100x Faster Model — levelup.gitconnected.com · 21/09/2026
Comentários
Faça login para comentar nesta notícia.
Nenhum comentário ainda. Seja o primeiro!