
Uma operação coordenada criada para capturar o modo de pensar interno de sistemas avançados de inteligência artificial foi recentemente desmantelada. A prática, conhecida na área como destilação adversarial, consiste em utilizar de forma sistemática e não autorizada os processos de um modelo para treinar, reproduzir ou melhorar outro sistema concorrente. A revelação foi compartilhada em 30 de setembro de 2026 pela OpenAI (abre em nova aba), que detalhou os esforços para proteger sua tecnologia contra a cópia indevida de dados.
Apesar da contenção realizada nos sistemas diretos da empresa, testes independentes demonstraram que a técnica de extração continuou operando por semanas dentro do serviço de computação em nuvem Microsoft Azure, apontando descompassos na aplicação de defesas em plataformas parceiras.
O que é raciocínio protegido e por que ele importa
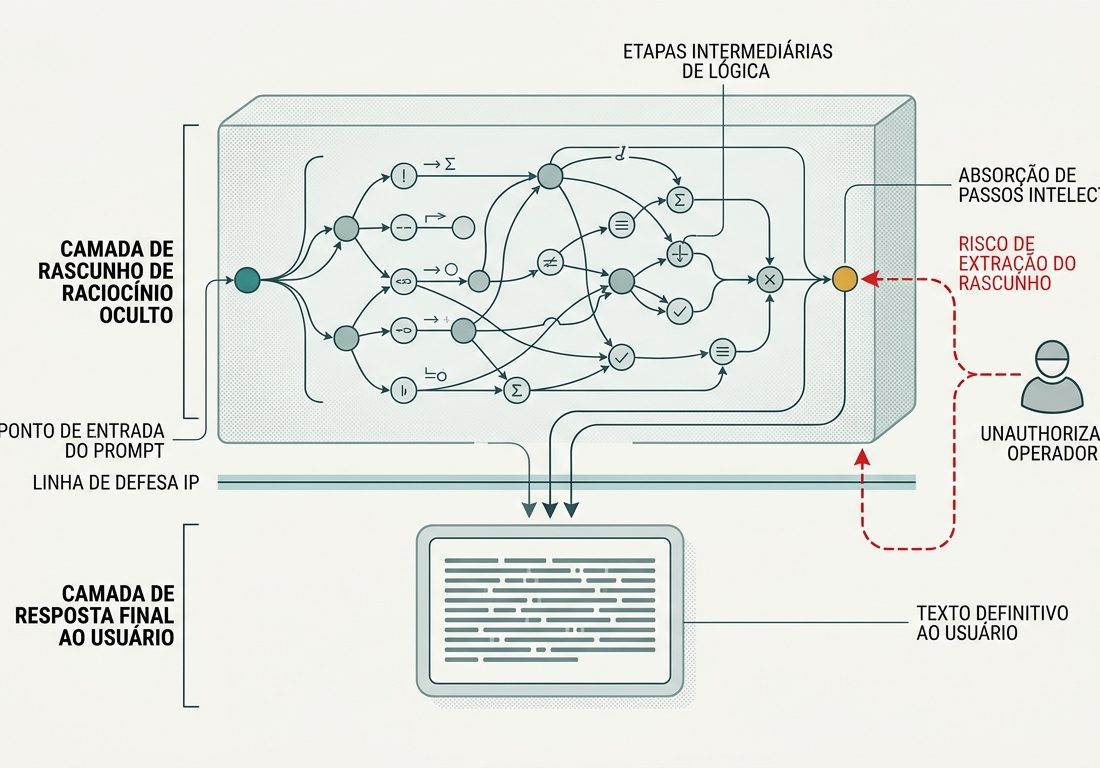
Para entender essa questão, pense em um estudante resolvendo um problema difícil de matemática. Esse estudante utiliza uma folha de rascunho para rabiscar hipóteses, testar fórmulas e corrigir erros antes de entregar apenas a resposta limpa na folha oficial.
Nos modelos de inteligência artificial mais modernos, o raciocínio protegido funciona exatamente como essa folha de rascunho. O sistema processa etapas intermediárias de lógica antes de entregar o texto definitivo ao usuário. Quando operadores tentam extrair esse rascunho oculto, o objetivo é absorver os passos intelectuais da ferramenta, permitindo clonar suas capacidades sem arcar com o imenso custo de pesquisa e treinamento. Trata-se de um risco direto à propriedade intelectual e à segurança dos dados gerados no processo.
Como funcionava o método das 15 mil contas
De acordo com o relato da desenvolvedora, a investida começou com baixa intensidade em 1º de julho de 2026. Entre os dias 24 e 25 de julho, o volume disparou para 16 mil requisições vindas de mais de 4 mil usuários distintos, todos empregando um modelo repetitivo de instruções. As apurações revelaram uma rede de mais de 15 mil contas associadas ao esquema, inteiramente derrubadas até o dia 28 de julho. A organização pontuou que os registros correspondem a tentativas de extração, que nem sempre obtiveram êxito.
O método utilizado não exigiu a invasão de bancos de dados nem a quebra de criptografia. Os operadores se aproveitaram da dinâmica das conversas:
- Obtinham blocos de raciocínio criptografados gerados pelo modelo em uma interação inicial.
- Abriam uma conversa separada e inseriam esse material codificado.
- Solicitavam ao próprio modelo que decifrasse o texto e o transcrevesse por extenso na resposta final.
O grupo principal por trás dessa operação foi vinculado a pessoas ligadas à empresa chinesa Moonshot AI, criadora do modelo de linguagem Kimi. A desenvolvedora americana ponderou que não é possível afirmar se todas as mais de 15 mil contas pertenciam a um único mandante.
A persistência da brecha no Microsoft Azure
Mesmo após as contas terem sido desativadas e as correções implementadas nas interfaces diretas da criadora da tecnologia, a fragilidade permaneceu aberta em serviços de terceiros. O pesquisador Joachim Schaeffer e sua equipe já haviam documentado o funcionamento desse padrão em um artigo acadêmico. Ao realizarem novos testes práticos em 13 de setembro de 2026, os especialistas constataram que a investida estava bloqueada nos canais oficiais da OpenAI e da Anthropic, mas continuava funcionando no Microsoft Azure.
No ambiente do Azure, bastava uma única tentativa para extrair o raciocínio oculto na íntegra, palavra por palavra. A situação revelou que um mesmo modelo matemático pode apresentar níveis de segurança completamente diferentes dependendo da infraestrutura que o disponibiliza.
| Modelo ou Plataforma | Situação observada em 13 de setembro de 2026 |
|---|---|
| Canais diretos da OpenAI | Ataque bloqueado com sucesso |
| Canais diretos da Anthropic | Ataque bloqueado com sucesso |
| Microsoft Azure (Modelos OpenAI) | Vulnerável em todos os modelos testados, incluindo o GPT-6 Astra |
| Microsoft Azure (Modelos Anthropic) | Vulnerável até a versão Sonnet 5 |
O modelo GPT-6 Astra havia sido lançado em plataformas parceiras sem a inclusão prévia dessas barreiras protetivas. Conforme a linha do tempo documentada pelos pesquisadores, as salvaguardas necessárias só foram adicionadas ao ponto de acesso do Azure em 27 de setembro de 2026, quase dois meses após a interrupção da campanha nas contas primárias.
Medidas adotadas para proteger os dados
Para neutralizar a campanha de destilação e evitar novas brechas estruturais, foram aplicadas diversas ações conjuntas:
- Banimento permanente das contas que apresentaram comportamento fraudulento.
- Aumento do rigor no processo de cadastro e reforço na segurança da infraestrutura de acesso.
- Eliminação do mecanismo que permitia a um usuário reaproveitar rascunhos criptografados de outras conversas para decodificá-los.
- Criação de filtros capazes de inspecionar e interromper transmissões de respostas que ameacem exibir o raciocínio protegido.
- Articulação com fornecedores terceirizados e compartilhamento de informações técnicas com órgãos governamentais e fóruns de cooperação do setor.
Essas providências visam garantir que o rascunho interno das inteligências artificiais permaneça devidamente isolado, impedindo a reprodução não autorizada de suas capacidades intelectuais em qualquer plataforma.