
Notícia
Astra e Opus decifram mensagens Enigma que resistiam desde 2005
Dois pesquisadores usaram modelos de inteligência artificial da OpenAI e da Anthropic para decifrar mensagens da máquina Enigma que resistiam há décadas. Uma das soluções foi validada por um especialista em criptologia, mas segue em aberto qual acervo o modelo consultou.
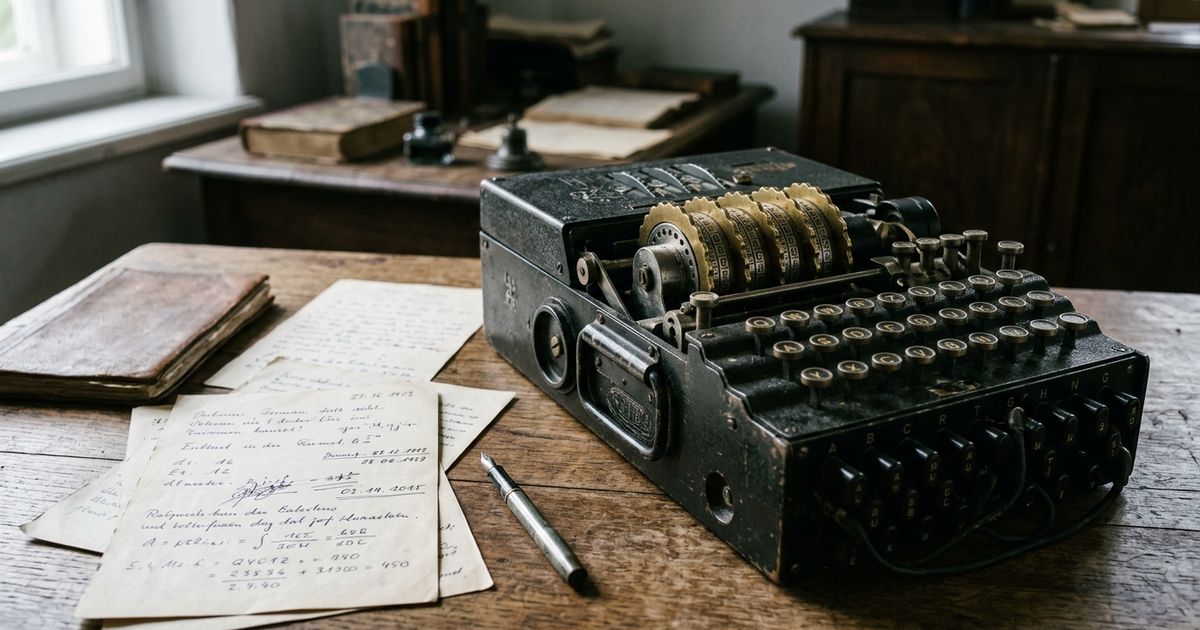
Duas mensagens cifradas por máquinas Enigma durante a Segunda Guerra Mundial e que resistiam a pesquisadores há décadas ganharam texto claro decifrado com ajuda de modelos de inteligência artificial de grande porte. Os resultados circularam a partir de 25 de setembro de 2026, quando relatos sobre o feito começaram a ser publicados, e envolvem dois pesquisadores que trabalharam de forma independente, cada um com um modelo diferente.
A história importa por dois motivos. O primeiro é histórico: o matemático britânico Alan Turing é mais conhecido pelo teste que leva seu nome, criado para avaliar se é possível distinguir uma máquina de um ser humano em uma conversa. O segundo motivo é prático: os dois casos mostram modelos de linguagem não apenas respondendo a perguntas, mas pesquisando arquivos, reunindo pistas e construindo ferramentas para chegar a uma resposta.
O que é a máquina Enigma e o que significa decifrá-la
A Enigma era uma máquina de cifrar usada pela Alemanha nazista na Segunda Guerra Mundial. Cifrar significa embaralhar uma mensagem de modo que apenas quem conhece a chave consiga lê-la. Na Enigma, cada vez que o operador apertava uma tecla, a máquina acendia uma letra diferente daquela que havia sido digitada, e a configuração interna mudava a cada dia. Por isso, sem conhecer a configuração correta, o texto parecia uma sequência aleatória de letras.
Para ler essas mensagens, Turing e sua equipe de criptanalistas construíram uma máquina chamada Bombe, um dos primeiros computadores, que permitiu ao Reino Unido traduzir mensagens da Enigma durante a guerra. Criptanalista é o profissional que tenta quebrar códigos e cifras sem ter a chave original. Ainda assim, um pequeno conjunto de mensagens arquivadas permaneceu sem solução, normalmente por causa de erros de transcrição ou de equívocos cometidos pelos próprios operadores que cifraram o texto na época.
O pedido aberto que virou resultado
O desenvolvedor Carter Leffen deu ao Astra, modelo mais recente da OpenAI (abre em nova aba), uma tarefa ampla: procurar em um banco de dados de mensagens Enigma uma que ainda não tivesse sido decifrada e decifrá-la. Ele não indicou qual mensagem deveria ser atacada nem forneceu a cifra específica.
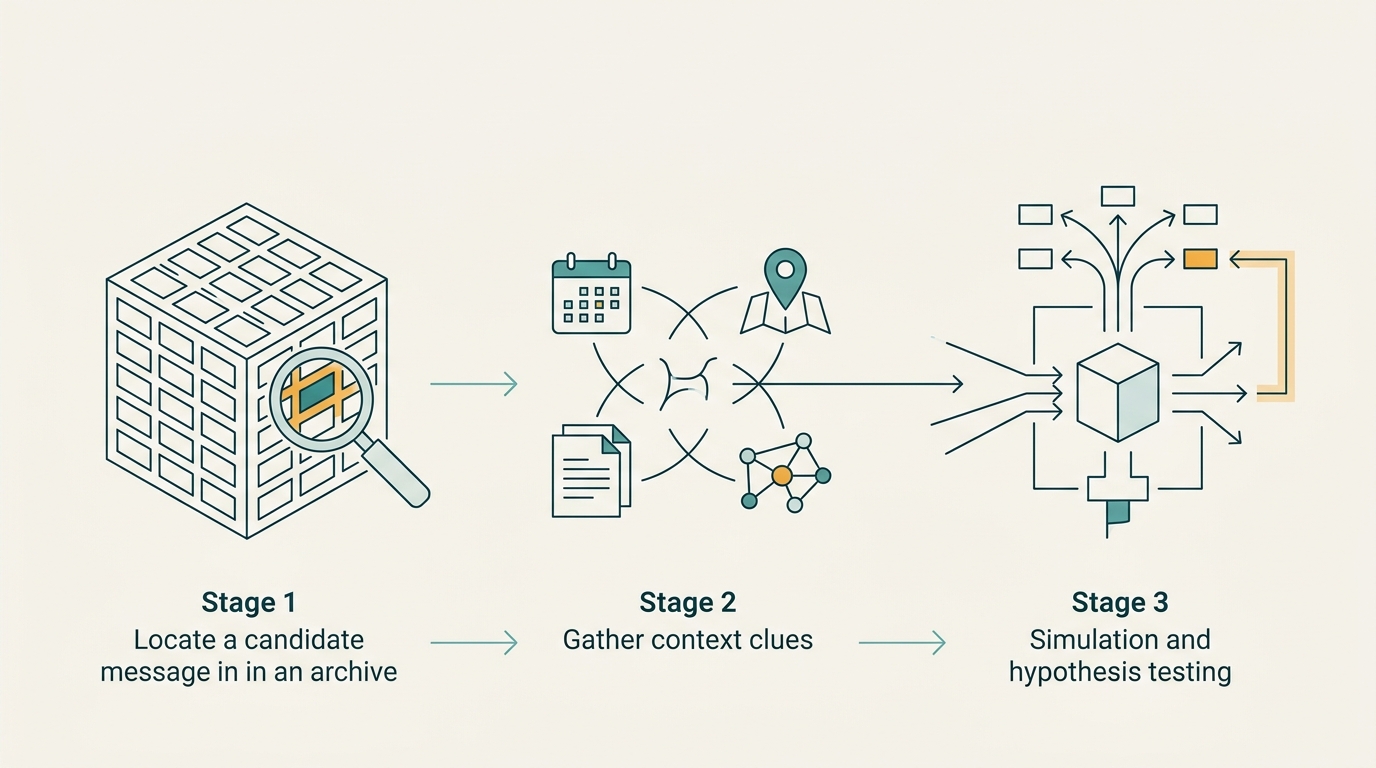
Segundo os relatos publicados, o modelo percorreu material de arquivo, reuniu pistas de contexto e construiu um simulador da máquina Enigma antes de chegar ao texto claro. Texto claro é o nome que se dá à mensagem legível, depois de desfeita a cifra. A mensagem recuperada resistia a pesquisadores desde 2005.
Esse encadeamento de etapas é o ponto central do caso. Não se tratou apenas de ler uma mensagem cifrada, e sim de localizar uma candidata, juntar informações que ajudassem a interpretá-la e testar uma hipótese de decifração com um simulador. Leffen também usou o Astra para construir um site interativo que explica a mensagem e o problema de decifração envolvido.
A conferência humana
Frode Weierud, engenheiro elétrico aposentado com interesse em criptologia desde a juventude, mantém um site com recursos, registros e um banco de mensagens da Enigma. Na semana anterior à publicação dos relatos, ele verificou e validou a solução apresentada por Leffen, dizendo que o resultado o deixou espantado. Validar, aqui, significa que uma pessoa com conhecimento profundo do assunto conferiu o texto claro e o considerou correto. O nome do pesquisador aparece grafado de duas formas diferentes nos materiais consultados, Weierud e Weirerud, uma divergência de grafia que não altera o conteúdo do que foi dito.
Weierud também estimou o esforço envolvido. Segundo ele, o Astra fez em dois dias um trabalho que levaria um pesquisador humano semanas ou até meses. Em declaração reproduzida nos relatos, ele afirmou que o modelo se comporta como um criptanalista e pesquisador de arquivo bastante profissional, e acrescentou que passou pessoalmente várias semanas pesquisando os arquivos do Bundesarchiv, o arquivo federal alemão, aos quais o modelo fez referência.
A segunda mensagem e a diferença de método
O outro caso envolve o criptanalista Jack Willis. Em 21 de setembro, ele procurou Weierud para dizer que havia usado o modelo Claude Opus 5, da Anthropic (abre em nova aba), para quebrar uma mensagem ainda não solucionada, diferente daquela trabalhada por Leffen. Nesse caso, houve muito mais orientação humana: Willis forneceu mais indicações ao modelo, que acabou conseguindo decifrar a mensagem usando a assinatura conhecida do nome de um oficial como ponto de partida.
A comparação entre os dois episódios é reveladora. No primeiro, o modelo recebeu apenas um objetivo amplo. No segundo, recebeu um caminho mais detalhado. Ambos chegaram a resultados validados pela mesma pessoa, mas por rotas diferentes, o que sugere que a quantidade de orientação fornecida ao modelo influencia o modo como o trabalho se desenrola.
A pergunta que ficou sem resposta
Nem tudo no caso do Astra está esclarecido. Os registros de atividade do modelo mencionam mensagens arquivadas em uma coleção privada que Weierud não mantém. Ele afirma não saber se o modelo realmente acessou esse material. Como hipóteses, levanta que os conteúdos podem ter sido compartilhados por outro pesquisador em algum lugar da internet, ou que o modelo conseguiu acessar arquivos públicos do governo alemão.
Essa distinção importa para quem quiser repetir o trabalho. Uma resposta confirmada não revela automaticamente todas as fontes usadas para chegar até ela. Se o modelo consultou uma coleção particular que não está disponível ao público, outros pesquisadores podem não conseguir refazer o mesmo caminho. A pergunta em aberto, portanto, é qual acervo o Astra consultou de fato ao longo da busca.
Por que isso interessa a quem não é técnico
Modelos de linguagem de grande porte são sistemas treinados em enormes quantidades de texto para prever e produzir linguagem. Nos últimos anos, passaram a ser usados também como agentes, isto é, sistemas que executam sequências de ações para cumprir uma tarefa, em vez de apenas responder a uma pergunta isolada. O caso da Enigma é um exemplo desse uso: o modelo precisou decidir o que procurar, onde procurar e como testar suas próprias hipóteses.
Ao mesmo tempo, o episódio mostra os limites desse tipo de resultado. Existe uma diferença entre encontrar uma resposta e documentar de forma completa como ela foi encontrada. Sem essa documentação, fica difícil separar o que o sistema deduziu sozinho do que ele apenas localizou em algum acervo.
O que ainda falta
Weierud contabiliza sete mensagens Enigma ainda não decifradas, além de uma cujo texto claro já é conhecido, mas cujo código continua sem solução. São poucas, e o ritmo recente sugere que esse número pode diminuir.
Para acompanhar o assunto, vale observar três coisas. A primeira é se os responsáveis pelos dois casos vão publicar detalhes suficientes para que outras pessoas reproduzam o trabalho. A segunda é se ficará claro qual acervo o Astra consultou. A terceira é se as mensagens restantes serão atacadas com o mesmo tipo de abordagem, com objetivo amplo, ou com orientação humana mais detalhada, como no caso do Claude Opus 5. Os relatos foram publicados entre 25 e 26 de setembro de 2026, com horários distintos conforme o material, e a validação das soluções por Weierud ocorreu na semana anterior a essas publicações.
Fontes
- Astra and Opus just passed Turing's other test — techcrunch.com · 25/09/2026
- Developer Uses Astra to Decode an Enigma Message ... — superpowerdaily.com · 25/09/2026
- Astra and Opus just passed Turing's other test | daily.dev — daily.dev · 25/09/2026
- Astra and Opus just passed Turing's other test — ground.news · 25/09/2026
- Astra and Opus just passed Turing’s other test — tech.yahoo.com · 25/09/2026
- AI Yi-Yi! - Blue's News Story — bluesnews.com · 25/09/2026
Comentários
Faça login para comentar nesta notícia.
Nenhum comentário ainda. Seja o primeiro!