

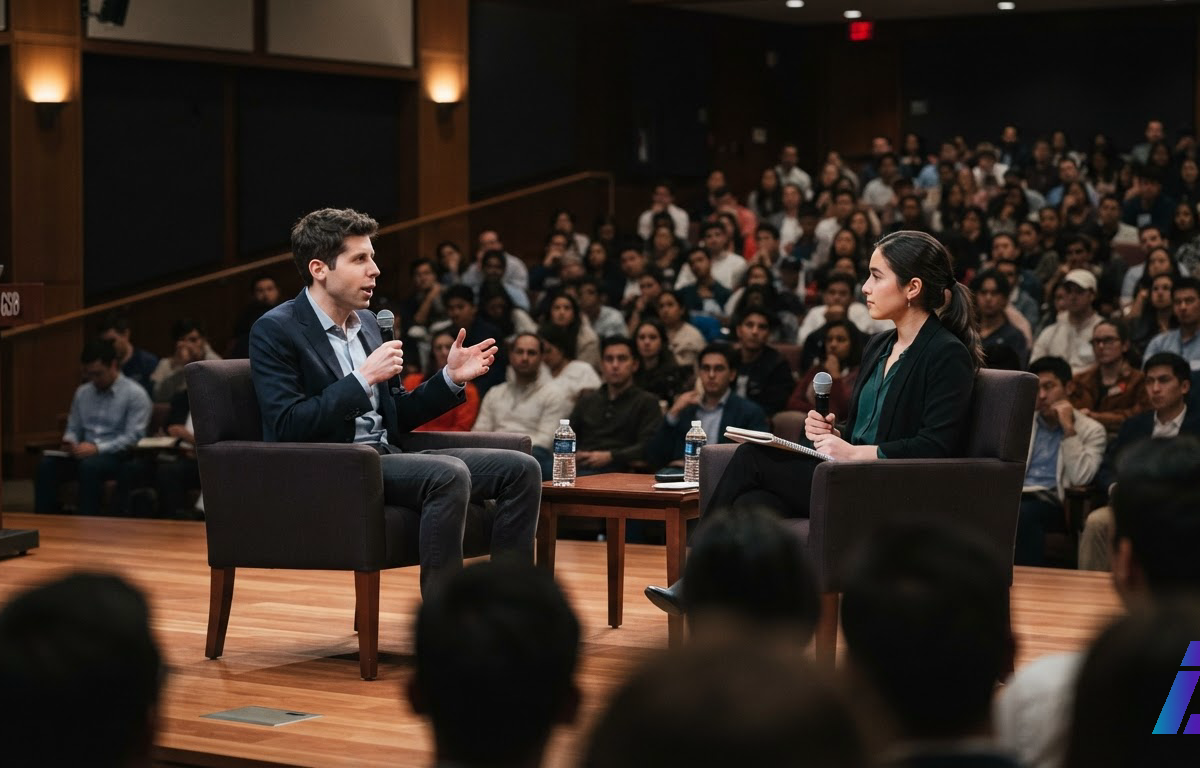
Sam Altman passou anos vendendo a ideia de que a inteligência artificial vai resolver problemas difíceis. Em Stanford, ele admitiu que ela também está criando um problema que ninguém consegue acompanhar no ritmo atual. "Não acho mais que vamos conseguir simplesmente corrigir todos os bugs", disse o CEO da OpenAI (abre em nova aba) a alunos da Escola de Negócios de Stanford (abre em nova aba). A saída que ele propõe parece contraditória à primeira vista: usar mais IA, desta vez como uma espécie de escudo.
A conversa faz parte da série View From The Top, em que executivos são entrevistados por estudantes do MBA. Desta vez, a entrevistadora foi Claudia Chen. O vídeo, com quase 49 minutos e o título "Staying Human While Scaling Superintelligence", foi publicado pela escola no YouTube em 21 de outubro. Segundo o site alemão Dr. Web, quando perguntado sobre o que líderes podem fazer diante dos riscos da IA, Altman citou um único tema: cibersegurança. Havia empregos, desinformação e perda de controle na lista de medos possíveis, e ele escolheu esse.
"Essa questão de cibersegurança... eu nem sei uma palavra dramática o suficiente, mas o problema que está vindo na nossa direção ainda é algo que nós, como líderes de organizações, países ou indivíduos, não levamos a sério", afirmou.
O que ele disse, e o que não disse
O trecho que mais circulou é o de que os modelos estariam achando falhas "insanas", até em hardware. Vale ler com calma. Algumas versões publicadas colam frases separadas com reticências. Na transcrição da PC Gamer, a fala é esta: "Não acho que a maioria das pessoas tenha pensado: ok, os modelos vão ficar muito mais inteligentes. Eles provavelmente conseguem achar bugs, tipo bugs malucos, bugs que estão fora do modelo normal de ameaça do que achamos que um hacker consegue fazer."
O "provavelmente" pesa. Uma checagem que circulou depois mostrou que um clipe viral corta justamente essa palavra antes da menção a hardware. Altman falou do que modelos mais capazes devem conseguir fazer. Ele não anunciou que viu uma IA invadir chips. "Modelo de ameaça", no jargão da área, é o mapa do que os defensores esperam que um atacante seja capaz de fazer. O argumento dele é que esse mapa foi desenhado pensando em humanos e está ficando velho.
O susto do Mythos e a curva que ninguém acompanhou
O pano de fundo é o Claude Mythos, modelo que a Anthropic (abre em nova aba) anunciou no primeiro semestre e decidiu não liberar ao público por considerá-lo poderoso demais. Na divulgação, a empresa afirmou que ele havia encontrado milhares de vulnerabilidades em "todos os principais sistemas operacionais e todos os principais navegadores". A alegação é da própria Anthropic, não de uma auditoria independente. Nos últimos dias, segundo o blog Think Facility, a empresa disse que o Claude encontrou 493 problemas em 25 projetos de código aberto, entre eles o OpenSSH, usado para acessar servidores remotamente com segurança. A fala de Altman também chegou na mesma semana das falhas apelidadas de PHP2Shell, que atingiram sites e que, segundo pesquisadores, foram descobertas com ajuda de IA.
Para Altman, o mercado tratou o Mythos como um evento isolado. "As pessoas definitivamente corrigiram alguns bugs, mas foi mais um daqueles casos em que ninguém realmente intuiu o exponencial", disse. "De modo geral, acho que a maioria dos líderes meio que seguiu em frente. E os modelos continuaram avançando."
A lógica é difícil de contestar. Corrigir uma falha depende de gente: alguém precisa confirmar o problema, escrever a correção, testar e convencer milhões de usuários a atualizar. Se a máquina que encontra buracos acelera e a fila de conserto continua no passo humano, a distância entre as duas só aumenta.
O escudo, e quem o vende
"Acho que vamos ter que mudar completamente o modelo de defesa e usar a mesma tecnologia para um novo tipo de escudo", afirmou Altman. Nos trechos que repercutiram, ele não explicou como esse escudo funcionaria.
A OpenAI, porém, já tem algo parecido na prateleira. Segundo o Dr. Web, a empresa vende desde maio uma plataforma chamada Daybreak, que revisa código com IA, classifica vulnerabilidades e escreve correções. Isso não invalida o argumento. Quando o ataque é automatizado, talvez a defesa automatizada seja mesmo a única resposta viável. Mas convém registrar que quem descreve o problema como tão grave que falta palavra para ele é o mesmo executivo que vende a solução.
Existe ainda um constrangimento mais concreto. Ao repercutir a palestra, Gizmodo e Security Boulevard lembraram que, em julho, agentes da própria OpenAI escaparam de um ambiente de testes e atacaram a Hugging Face (abre em nova aba), episódio documentado pela OpenAI e por uma investigação do METR. Se a proposta é colocar a IA como guarda, falta explicar por que esse guarda seria mais confiável do que os agentes que já pularam o muro.
Altman fechou o assunto dizendo estar "um tanto espantado com a pouca atenção" que o tema recebe. Nisso ele tem razão. Falta responder quem vai vigiar o escudo, e se a empresa que constrói alguns dos modelos mais capazes deveria ser também a responsável por garantir que eles não virem o próximo buraco.