
A divisão de inteligência artificial da Alibaba apresentou o Qwen-Audio-3.1-Realtime (abre em nova aba), um modelo avançado criado para tornar as conversas faladas com computadores muito mais naturais. Enquanto os assistentes tradicionais costumam se perder quando duas pessoas falam ao mesmo tempo ou quando ocorrem ruídos no ambiente, a nova tecnologia foi projetada para escutar, raciocinar e saber exatamente o momento correto de responder.
O sistema começou a ser disponibilizado no catálogo em 20 de setembro de 2026 e teve os detalhes de sua arquitetura científica compartilhados formalmente no dia 21 de setembro de 2026, com uma revisão técnica publicada em 24 de setembro de 2026. Documentações complementares de serviços também foram atualizadas no dia 28 de setembro de 2026.
O que é o modelo e por que ele importa
O Qwen-Audio-3.1-Realtime é um modelo de inteligência artificial de ponta a ponta focado em áudio. A sua grande inovação é o funcionamento em modo full-duplex, um termo técnico que descreve sistemas capazes de transmitir e receber informações de forma simultânea. Em termos simples, isso funciona exatamente como uma conversa entre duas pessoas ao telefone: você pode continuar ouvindo o interlocutor mesmo se falar algo rápido, sem que a chamada trave ou precise ser reiniciada.
Além de conversar de forma contínua, o sistema atua como um agente autônomo. Isso significa que ele não apenas repete frases prontas, mas também raciocina sobre pedidos complexos e consegue usar ferramentas externas. Entre essas ferramentas estão a realização de pesquisas na internet e a chamada de funções, recurso conhecido como function calling, que permite ao modelo acionar sistemas externos para agendar compromissos ou consultar bases de dados.
Como o sistema funciona na prática
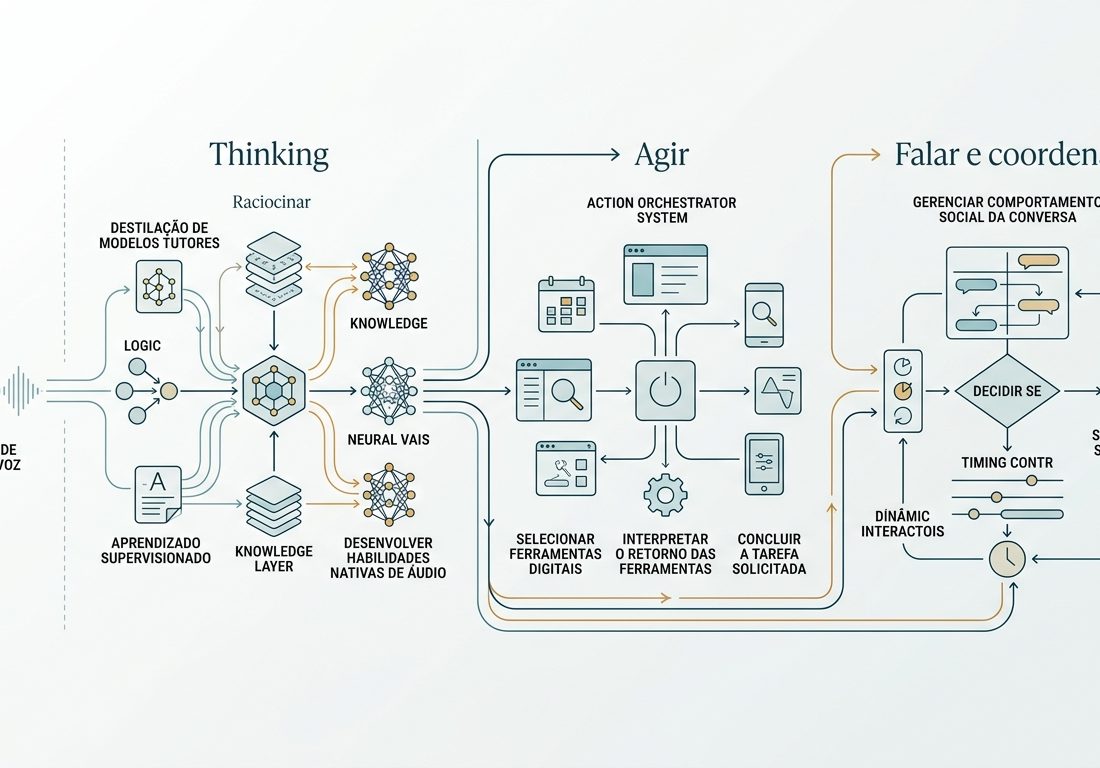
Para resolver a clássica dificuldade das máquinas em entender pausas humanas, a arquitetura do modelo foi dividida em três pilares integrados:
- Raciocinar (Think): reúne técnicas de aprendizado supervisionado e destilação de múltiplos modelos tutores para transferir capacidades linguísticas e desenvolver habilidades nativas de áudio.
- Agir (Act): utiliza ambientes executáveis e métodos de otimização de políticas para ensinar o modelo a selecionar ferramentas digitais, interpretar o retorno dessas ferramentas e concluir a tarefa solicitada.
- Falar e coordenar (Speak and Coordinate): gerencia o comportamento social da conversa, decidindo se o assistente deve falar, quando deve falar e de que maneira deve intervir.
Na prática diária, pense em alguém conversando em uma cafeteria movimentada. Em versões anteriores, se uma pessoa na mesa ao lado falasse alto ou pedisse um café, o assistente virtual poderia se confundir, interromper o usuário e tentar responder ao desconhecido. O Qwen-Audio-3.1-Realtime aprendeu a filtrar esse tipo de ruído e focar apenas em quem está interagindo com ele.
A equipe oficial de desenvolvimento ressaltou o lançamento como parte de um pacote integrado para processamento de voz:
Conheça o Qwen-Audio-3.1! ASR, TTS e Realtime estão totalmente atualizados, acompanhados por dois novos modelos: TTS-Next para criação de áudio e ASR-Next para compreensão de áudio. Cinco modelos, uma pilha completa de áudio: compreensão, geração, interação e criação.
Avanços comprovados em testes
As melhorias técnicas foram avaliadas em testes padronizados da indústria, os chamados benchmarks. De acordo com o relatório técnico da pesquisa (abre em nova aba), o modelo registrou ganhos expressivos em relação ao seu antecessor direto, o Qwen-Audio-3.0-Realtime.
| Métrica avaliada | Qwen-Audio-3.0-Realtime | Qwen-Audio-3.1-Realtime |
|---|---|---|
| Sucesso em tarefas (τ-Voice adaptado) | 78,4% | 82,0% |
| Taxa de resposta a falas de fundo (Full-Duplex-Bench v1.5) | 73,0% | 13,0% |
A redução da taxa de respostas a vozes de fundo de 73,0% para apenas 13,0% demonstra que a nova versão se tornou consideravelmente mais resistente a distrações e interferências do ambiente.
Como empresas e desenvolvedores podem acessar
O modelo foi liberado como uma interface de programação gerenciada, voltada para integração em sistemas corporativos e assistentes virtuais de atendimento. O identificador comercial do serviço é qwen-audio-3.1-realtime-plus, acessível por meio da plataforma Alibaba Cloud Model Studio (abre em nova aba) e operando com conexões contínuas via WebSocket no QwenCloud. Não houve disponibilização de pesos abertos para execução local.
A especificação técnica inclui uma janela de contexto de 262.144 tokens, que são as unidades básicas de processamento de texto e som. O limite máximo para entrada é de 245.760 tokens, enquanto a saída máxima suporta 16.384 tokens. A taxa padrão de uso estabelecida é de 60 requisições por minuto e 100.000 tokens por minuto. O sistema oferece ainda clonagem de voz e traz a voz longanqian_v3.1 como padrão, lembrando que a navegação na web e a chamada de funções não podem operar juntas na mesma chamada.
A estrutura de preços adotada para a região de Cingapura define o valor de 0,80 dólar por milhão de tokens para entrada de texto e 6,40 dólares por milhão para entrada de áudio. Na geração de respostas, o áudio de saída custa 24 dólares por milhão de tokens, com registro em documentação técnica de 6,40 dólares por milhão para texto gerado, enquanto notas comerciais apontam que o texto de saída pode não ser cobrado. Os desenvolvedores contam com compatibilidade direta de protocolo com a geração anterior, o que facilita a atualização de softwares existentes sem a necessidade de reconstruir toda a aplicação.