

Os modelos de inteligência artificial para genômica leem DNA cada vez melhor. Eles continuam fracos em explicar o que esse DNA faz dentro de um corpo humano. É o que mostra uma reportagem do jornalista científico Philip Ball publicada pela WIRED neste sábado (17), depois de sair na Quanta Magazine em junho. Os geneticistas ouvidos chegam a uma conclusão incômoda para quem vende a ideia de um "ChatGPT do genoma". O gargalo não é o algoritmo. São os dados que ninguém coletou ainda.
A discussão tem consequência prática. Em 8 de setembro, o Google DeepMind lançou o AlphaGenome Atlas, um banco de previsões já calculadas que, segundo a IEEE Spectrum, cobre 9 bilhões de variantes possíveis de DNA. Ele pode ser consultado sem rodar o modelo. Com isso, ficou muito mais fácil puxar uma nota sobre o impacto provável de uma mutação. Também ficou mais fácil ler nesse número mais do que ele diz.
O problema está nos 98% que não são genes
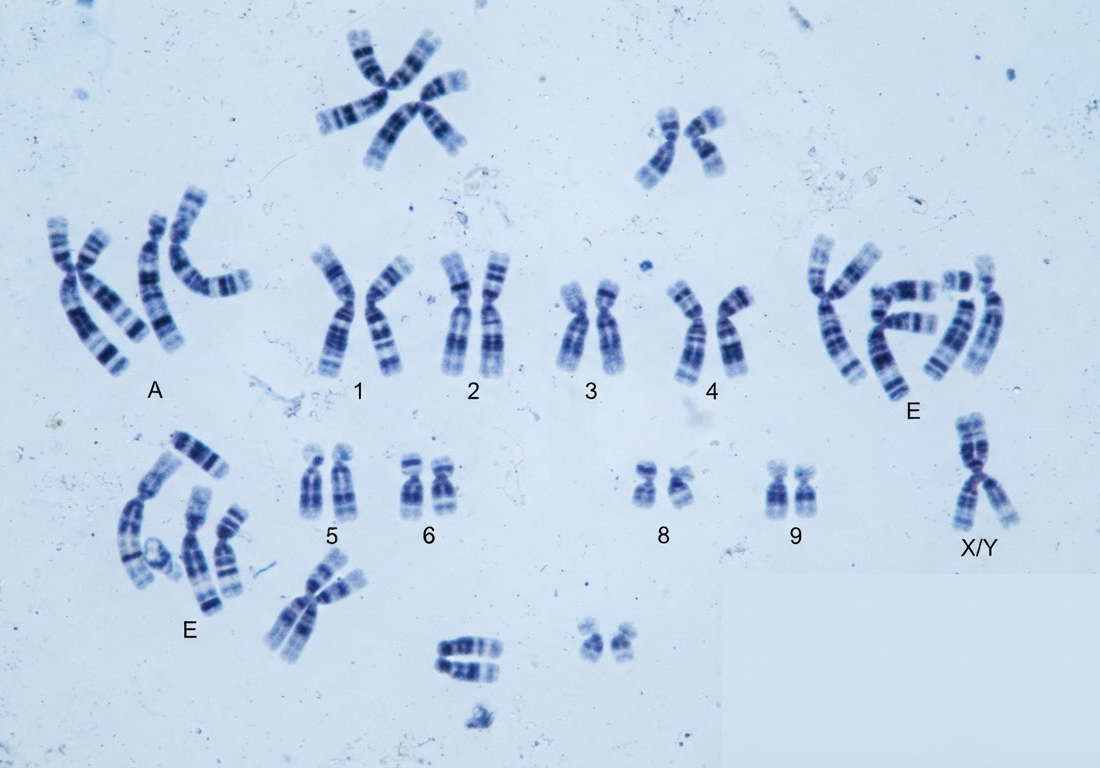
O Projeto Genoma Humano (1990–2003) praticamente concluiu a leitura das cerca de 3 bilhões de "letras" do nosso DNA. Só que pouco mais de 2% disso são genes propriamente ditos. São cerca de 20 mil, com tamanhos que vão de algumas dezenas a quase 3 milhões de letras. O resto não fabrica proteína, mas abriga boa parte dos controles que definem quando, onde e quanto cada gene funciona.
Os principais desses controles são os enhancers (intensificadores). O genoma tem centenas de milhares deles, talvez milhões, e alguns ficam a milhões de letras de distância do gene que comandam. A geneticista Wendy Bickmore, da Universidade de Edimburgo, resume o atraso:
"É constrangedor que, 25 anos depois do Projeto Genoma Humano, a gente não saiba onde estão todos os enhancers do genoma, muito menos o que eles fazem quando agem e quais genes controlam."
Os próprios cientistas não têm esse mapa. Por isso a IA não tem de onde aprendê-lo.
O que o AlphaGenome faz, segundo quem o fez
O AlphaGenome (abre em nova aba) é a referência dessa geração de modelos, que inclui também o Evo 2 e o Genos. Ele recebe um trecho de até 1 milhão de letras de DNA e prevê milhares de propriedades moleculares. Entre elas estão:
- quanto um gene é expresso;
- quais regiões da cromatina estão acessíveis;
- onde se ligam as proteínas que regulam genes;
- quais pontos distantes do DNA entram em contato;
- como o RNA é cortado e emendado, processo chamado splicing.
Foi treinado com dados de consórcios públicos como ENCODE, GTEx, 4D Nucleome e FANTOM5, que cobrem centenas de tipos de células e tecidos de humanos e camundongos.
Os números de desempenho impressionam, mas foram medidos pela própria empresa. No artigo publicado na Nature (abre em nova aba) em janeiro de 2026, os autores afirmam que o modelo iguala ou supera os melhores concorrentes externos em 25 de 26 testes de previsão do efeito de variantes. No anúncio de junho de 2025, a conta era 24 de 26. Eles também relatam ganho relativo de 14,7% sobre o Borzoi, um modelo concorrente, na previsão de mudanças de expressão gênica específicas de cada tipo de célula. Essas avaliações são dos autores, não uma confirmação independente.
O dado mais revelador é a lista de limitações que o DeepMind publica sobre o próprio produto:
- elementos reguladores muito distantes, a mais de 100 mil letras, continuam difíceis de capturar;
- padrões específicos de cada célula e tecido precisam melhorar, e o artigo da Nature acrescenta a eficiência intermediária do splicing como ponto fraco;
- o modelo não foi desenhado nem validado para prever o genoma de uma pessoa;
- ele não explica como variantes levam a doenças complexas, que dependem também do desenvolvimento e do ambiente;
- as previsões são para pesquisa, sem validação para uso clínico direto.
Há ainda uma questão de alcance. O AlphaGenome olha para cerca de 1 milhão de letras ao redor de uma variante, mas alguns enhancers regulam genes a distâncias maiores que essa janela. Além disso, muitas doenças envolvem várias variantes ao mesmo tempo, não uma só, como lembra a IEEE Spectrum.
Falta o corpo, não a sequência
Bickmore não descarta a ferramenta. "Tenho certeza de que vai ser útil, mas com limitações", disse sobre o AlphaGenome. "Para mim, a grande lacuna é a complexidade do corpo humano: todos os tipos de célula e como eles mudam ao longo do desenvolvimento. E todos esses dados estão faltando."
Esse é o ponto central, e é o que mais se perde no discurso comercial. Um neurônio e uma célula do fígado carregam o mesmo DNA, mas o usam de formas diferentes, e esse uso muda do embrião ao adulto. Um modelo treinado com algumas centenas de tipos de células vê só parte dessa história. Ganhar mais parâmetros não preenche o pedaço que ninguém mediu. Adrian Woolfson, cofundador da Genyro, vai além no livro On the Future of Species, lançado em abril de 2026. Para ele, a informação relevante não está só na sequência.
Quando a IA escreve DNA, a cópia é detectável
Os limites ficam mais visíveis quando se pede ao modelo que gere DNA em vez de interpretá-lo. Um preprint no bioRxiv (abre em nova aba) de janeiro de 2026 testou o Evo 2 na criação de genomas sintéticos de bactérias, vírus e eucariotos. Eucariotos são o grupo que inclui animais e plantas. O estudo testou também o megaDNA com genomas de bacteriófagos.
As sequências geradas acertavam a estatística local e, de perto, pareciam DNA de verdade. Falhavam, porém, em vários pontos:
- na organização de longo alcance;
- na composição dos trechos repetitivos, a maior dificuldade;
- na arquitetura dos pontos de ligação das proteínas reguladoras;
- nas restrições impostas pela evolução.
Para medir isso, os autores treinaram uma rede neural para separar DNA real de sintético. A métrica usada, o AUROC, vai de 0,5, equivalente a chutar, a 1, acerto perfeito. A rede chegou a 0,97 em eucariotos e a 0,82 em procariotos. E quanto mais longe do trecho inicial fornecido ao modelo, mais fácil era reconhecer a sequência artificial.
Os autores falam em limitações fundamentais das arquiteturas atuais e apontam um efeito colateral. Avaliações de biossegurança que dependem de distinguir DNA sintético de natural precisam considerar esse comportamento. O trabalho ainda é um preprint, sem revisão por pares, e mede geração de sequências, não os testes de variantes do AlphaGenome.
O que muda para quem lê
Carl de Boer, pesquisador sem vínculo com o DeepMind, chamou o AlphaGenome de "modelo líder da área" em entrevista à IEEE Spectrum. Também o descreveu como "muito lento e computacionalmente intensivo". O Atlas resolve parte desse custo ao entregar as contas prontas. Mas de Boer faz o alerta que interessa ao leitor. Uma nota única de impacto "tem um uso claro, mas provavelmente vai ser facilmente mal interpretada", porque se trata de "um sistema muito complexo, com muitas peças se movendo".
Na prática, a situação fica assim:
- Para pesquisadores, a ferramenta serve para escolher quais variantes vale a pena testar em laboratório. Esse é o uso de pesquisa para o qual o DeepMind liberou a API, restrita a fins não comerciais.
- Para pacientes e médicos, a nota não é diagnóstico. O próprio fabricante diz que o modelo não foi validado para uso clínico nem para o genoma de uma pessoa específica. Diante de qualquer serviço que prometa interpretar seu DNA "com IA" usando essas previsões, a pergunta certa é para que aquilo foi validado.
- Para quem investe ou empreende na área, a vantagem competitiva está menos em treinar um modelo maior e mais em obter dados sobre tipos de célula e etapas do desenvolvimento que hoje não existem.
Enquanto esses dados não existirem, uma nota do AlphaGenome Atlas indica qual experimento fazer. Ela não diz nada conclusivo sobre a saúde de alguém.