
A forma como os grandes modelos de linguagem escrevem está passando por uma transformação perceptível. Em vez de parágrafos prolixos e cheios de rodeios, novos sistemas começaram a adotar uma cadência mais firme, direta e concentrada em significado. Esse padrão textual prioriza transmitir a maior quantidade de conteúdo com o menor número possível de termos, recorrendo a escolhas lexicais exatas e estruturas lógicas bem amarradas.
Para compreender essa mudança, é útil pensar na linguagem do modelo como uma bagagem de viagem com limite rigoroso de peso. Cada palavra ou pedaço de palavra processado pelo computador é chamado de token, a unidade básica de medida nesses sistemas. Se o espaço da mala for preenchido com roupas vazias ou enroladas de qualquer jeito, sobra pouco lugar para o essencial. A densidade semântica funciona como a técnica de dobrar tudo a vácuo, garantindo que cada partícula textual carregue substância prática.
O que impulsiona a máxima densidade de informação
A busca por síntese não é apenas uma questão estética, mas uma necessidade técnica. Em abril de 2026, pesquisadores documentaram o chamado Efeito de Densidade Semântica (abre em nova aba). O estudo revelou que instruções carregadas de termos informativos de alto valor superam formulações diluídas em uma média de 8,4 pontos percentuais nos testes de precisão, sem consumir processamento extra.
Outro fator determinante veio das investigações sobre raciocínio lógico. Em março de 2026, a proposta do framework InfoDensity (abre em nova aba) demonstrou que respostas muito longas durante etapas intermediárias de cálculo representam fragilidade no raciocínio. Ao analisar a incerteza estatística a cada passo, os pesquisadores concluíram que trajetórias intelectuais de alta qualidade resolvem dúvidas rapidamente. Assim, criaram recompensas em treinamento que incentivam o sistema a ser breve e eficiente sem perder coerência.
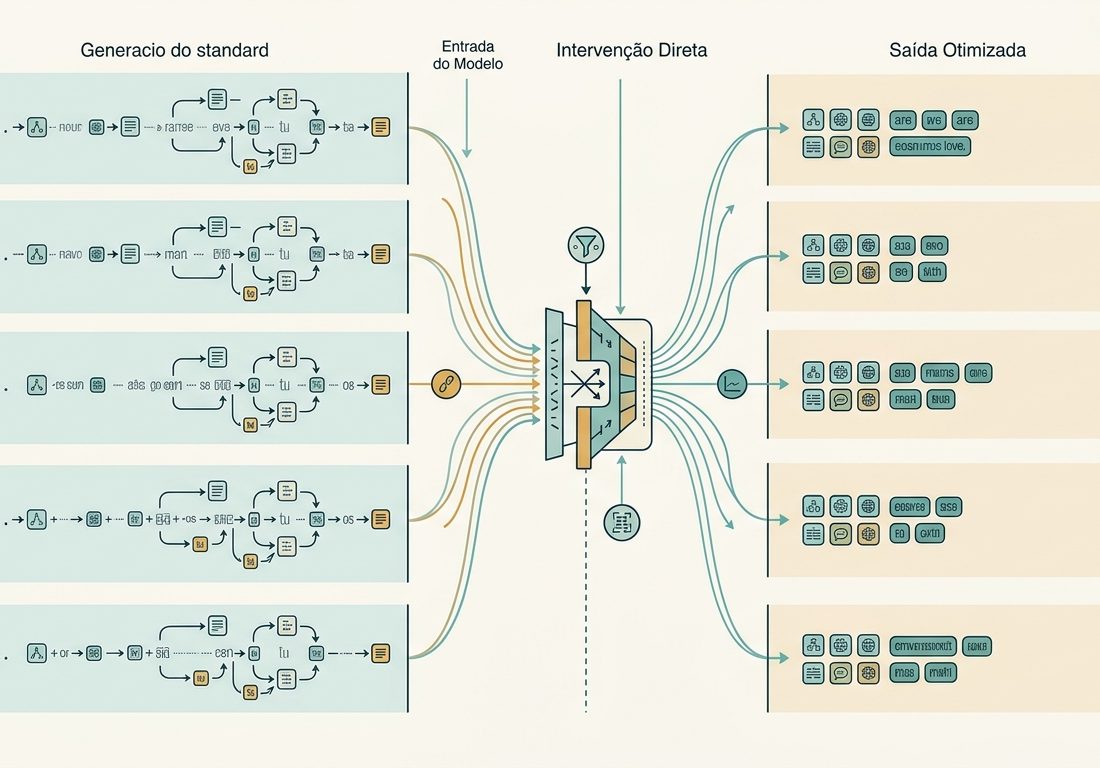
Complementarmente, técnicas aplicadas diretamente no momento de geração, sem necessidade de retreinar toda a rede, reforçaram esse movimento. O projeto DenseSteer (abre em nova aba), publicado em setembro de 2026 a partir de análises na família Qwen 2.5, orientou representações internas dos modelos para um raciocínio matemático concentrado, comprovando que menos etapas com maior densidade trazem saltos consistentes de exatidão.
Como os modelos expressam esse novo comportamento
As famílias mais conhecidas de modelos expõem diferentes facetas dessa tendência textual:
- Claude Opus: Em testes comparativos de tarefas idênticas, o Opus utilizou 237 palavras onde o GPT-5.4 precisou de 462 para cobrir o mesmo escopo. Na versão Opus 5.5, mapeada em outubro de 2026 pela análise da Graphite (abre em nova aba), a pontuação de prosa floreada caiu 37 por cento em relação à edição anterior. O modelo praticamente baniu pontuações expressivas como o travessão, reduzindo seu uso em 99 por cento, embora repita certas marcas como as expressões que destacam a relevância de um fato.
- Linha GPT: Modelos como o GPT-5.5 demonstraram contenção em índices gerais, consumindo cerca de 72 milhões de tokens de saída para concluir testes complexos, enquanto o GPT-6 Astra apresentou uma tendência a modular afirmações com cautela formal e reduziu o uso de travessões em 88 por cento em comparação a textos humanos.
- Família GLM: O relatório de desempenho do GLM-5.2 (abre em nova aba), divulgado no fim de junho de 2026, indicou que o sistema usou 141 milhões de tokens no índice geral de inteligência, com 95 por cento voltados ao raciocínio interno. Já o GLM-5.3-Flash revelou comportamentos de alta verbosidade por padrão, emitindo quatro vezes mais tokens que concorrentes diretos quando ajustado em esforço máximo.
Reações e impactos práticos para quem usa e programa
A chegada dessa cadência mais concentrada gera opiniões divididas entre desenvolvedores e usuários cotidianos. No desenvolvimento de software, modelos prolixos costumam ser vistos como vantajosos para projetos colaborativos, pois entregam códigos recheados de comentários explicativos, estruturas de apoio e alertas de segurança que facilitam revisões futuras.
Por outro lado, os modelos concisos atraem programadores que priorizam respostas rápidas e diretas ao ponto operacional, ainda que isso transfira ao leitor a tarefa de deduzir o contexto que não foi explicitado. Além do impacto na leitura, a verbosidade afeta diretamente a fatura dos serviços de computação em nuvem, onde etapas longas de raciocínio oculto elevam custos sem necessariamente elevar o índice de acertos em tarefas triviais.
Os passos seguintes do setor concentram-se em equilibrar a clareza didática e a precisão econômica, estabelecendo parâmetros em que o usuário possa escolher se deseja uma explicação detalhada e guiada ou uma síntese densa preparada para execução imediata.