
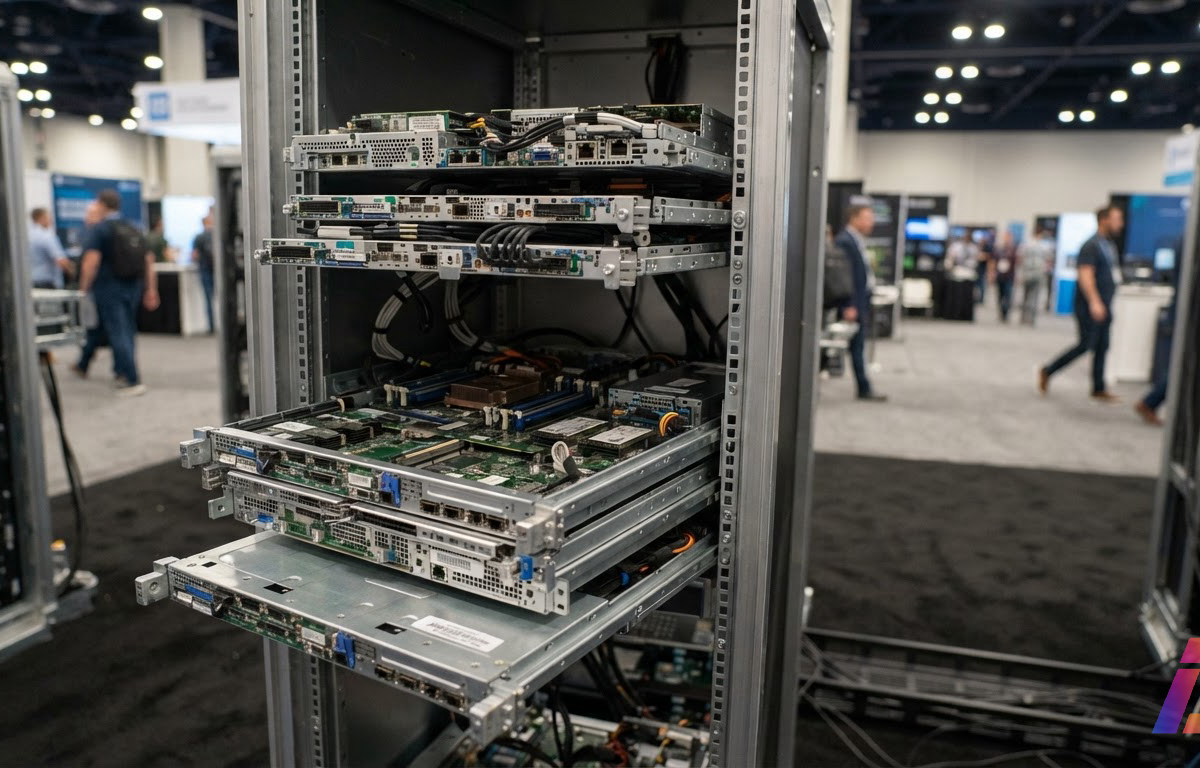
A palavra "aberto" leva uma vida difícil no mercado de infraestrutura. Serve para código, para especificação, para padrão de indústria e, com frequência, para a promessa vaga de que alguém vai publicar um diagrama. Quando a NVIDIA disse no OCP Global Summit deste ano (abre em nova aba) que "abriu" a arquitetura Vera Rubin, a pergunta que interessa não é se abriu, mas o quê, exatamente — e para quê.
A resposta tem duas camadas. Na superfície, há uma lista concreta de designs e especificações entregues ao Open Compute Project (abre em nova aba), a fundação que padroniza hardware de data center, conhecida pela sigla OCP. No fundo, há uma decisão estratégica sobre onde termina a commodity e onde começa o produto. As duas camadas explicam por que o anúncio importa para quem opera AI factories — e por que "aberto", neste caso, não significa o que um leitor apressado poderia imaginar.
O que foi colocado na mesa, item por item
No evento realizado em São Jose, na Califórnia, a NVIDIA anunciou a contribuição dos designs de rack e de compute tray (a bandeja que abriga os módulos de computação) da Vera Rubin ao OCP, por meio da MGX, a arquitetura modular de referência da própria empresa. A versão 1.2 dessa especificação traz um conjunto de mudanças físicas substantivas: refrigeração líquida em nível de rack com conexão do tipo blind-mate — o encaixe fluido que acopla a bandeja ao circuito de água sem mangueiras aparafusadas à mão —, interconexão interoperável entre racks, um barramento de distribuição de energia refrigerado a líquido capaz de 5.000 amperes, suporte nativo a equipamentos de 19 polegadas e implantações de até 250 kW por rack.
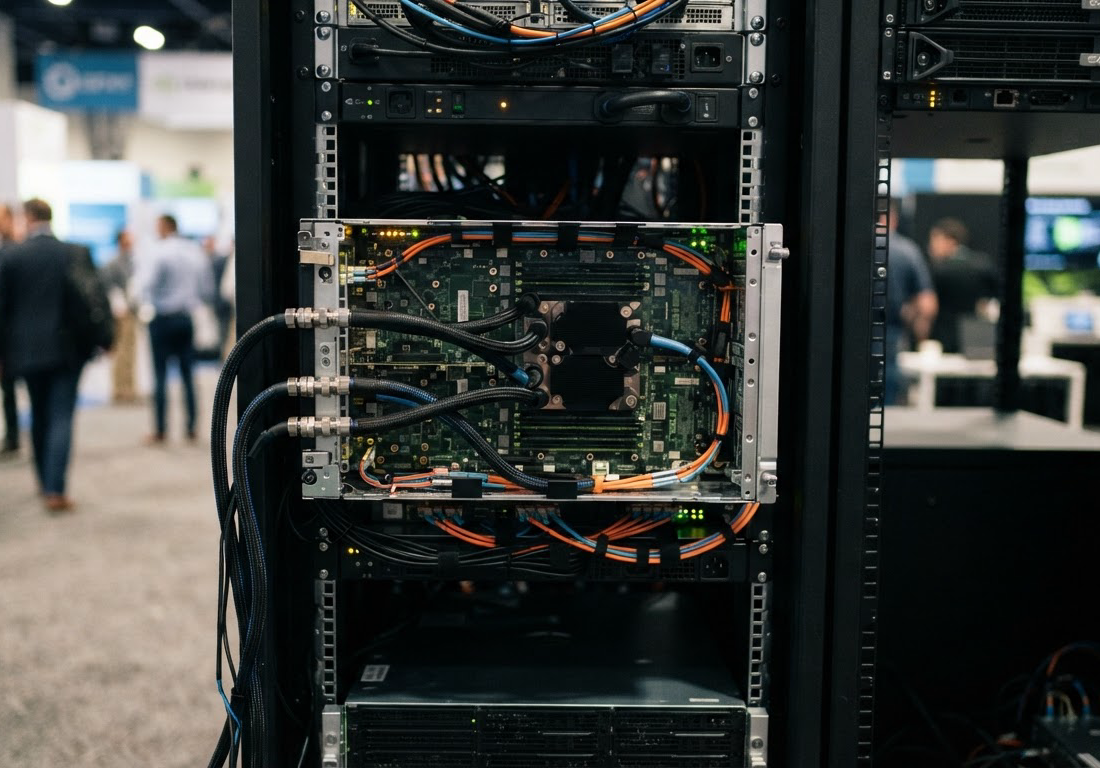
A bandeja de computação contribuída, segundo Joe DeLaere, gerente sênior de AI factory da NVIDIA, não tem cabos, mangueiras nem ventiladores: é refrigerada a líquido, modular e cobre energia, refrigeração e mecânica. Ele resumiu a lógica em um briefing de imprensa:
"O gargalo das construções de AI factories é a velocidade com que conseguimos fabricar e implantar."
A frase, ainda que venha da própria empresa, dá nome ao problema certo. Um rack de 250 kW não é um servidor maior: é uma obra de engenharia elétrica, hidráulica e mecânica que multiplica por dezenas a densidade do que os data centers tradicionais foram projetados para abrigar. Quando a especificação disso é fechada, cada fornecedor espera a encomenda de um único cliente para começar a produzir. Quando é aberta, fabricantes de servidores e de componentes podem montar cadeia de fornecimento antes de existir comprador — e o prazo entre a decisão de construir uma AI factory e o rack ligado na parede encurta.
Há também continuidade de projeto: o mesmo footprint do rack MGX que hoje abriga o GB300 NVL72, geração anterior, serve para o Vera Rubin NVL72, posicionado pela NVIDIA como base para treinamento e inferência em larga escala, e para o rack de CPU Vera Rubin, destinado a chamadas de ferramentas, orquestração e execução em ambiente isolado — o tipo de carga que domina quando agentes de IA passam a consumir mais máquina do que o próprio treinamento do modelo.
Software: o DSX sai de portas adentro
A abertura não parou na chaparia. A NVIDIA publicou como open source quatro componentes do DSX AI Factory, a plataforma de software da empresa para operar fábricas de IA: o Config Manager, o Cluster Readiness Engine, o Rack Management Service e um provedor de Cluster API — o mecanismo padrão do ecossistema Kubernetes para provisionar infraestrutura por código. Os quatro têm repositórios públicos no GitHub.
Em paralelo, a NVIDIA, a AMD, o Google e a Meta publicaram juntos a versão 0.7 da Open Data Center Specification, e a NVIDIA, o Google, a Meta e a Microsoft divulgaram a OCP Grid Resilience Specification, que segundo a NVIDIA exige que o data center permaneça conectado durante distúrbios na rede elétrica e recupere carga quase total em menos de dois segundos. Esse último número é afirmação da empresa, não medição independente — mas o tema em si é o que separa um data center comum de uma fábrica de IA que consome potência na escala de usinas: a sensibilidade do grid elétrico passa a fazer parte do desenho do produto.
Rede: onde o ecossistema se encaixa de verdade
A terceira frente do anúncio foi a rede, e aqui aparecem os nomes que dão peso ao pacote. A Meta anunciou adoção do Spectrum-6, o switch Ethernet de 102,4 Tb/s da NVIDIA, dentro do seu próprio rack refrigerado a líquido, o IcePack, rodando FBOSS — o sistema operacional de rede desenvolvido pela própria Meta. O Spectrum-6, sempre segundo os números da NVIDIA, dobra a capacidade de comutação e a banda por via em relação ao Spectrum-4, com Ethernet sem perdas a 200 G por via. Com o Spectrum-X Multiplane, que distribui tráfego em até oito planos usando o Spectrum-6 e os SuperNICs ConnectX-9 — chips de rede de alta performance para GPUs, , a arquitetura foi apresentada como capaz de sustentar fábricas de mais de 100.000 GPUs.
Com a Cisco, o anúncio mais específico foi o USFP, o Ultra-Dense Small Form Factor Pluggable: um módulo óptico plugsável de 400 Gb/s por via, com pegada física do tamanho do OSFP, o formato de módulo hoje comum em switches, , 16 vias full-duplex no primeiro modelo, plano de escalar a 32, e capacidade de até 12,8 Tb/s por módulo. A NVIDIA e a Cisco afirmam 4x a densidade de banda e cerca de 1,3x a eficiência energética em relação aos módulos de 200 Gb/s por via. Vale registrar: esses números são alegações do anúncio conjunto, não resultados de laboratório independente. O ponto estrutural é outro, com TE Connectivity e Amphenol no grupo, o formato nasce com pretensão de ecossistema multi-fornecedor, e não como peça exclusiva.
O Google entra com suporte ao Falcon Transport nos futuros ConnectX-10 e BlueField, os DPUs da NVIDIA, com interoperabilidade declarada entre SuperNICs e DPUs. Para quem administra redes de IA, essa é a parte mais pragmática do anúncio: transporte de alto desempenho que não exige trocar o mundo inteiro de fornecedor.
O que abriu, e o que não abriu
Posta lado a lado, a fronteira fica visível:
| Entrou no OCP ou em repositórios públicos | Continua sob controle da NVIDIA |
|---|---|
| Designs de rack e compute tray Vera Rubin (mecânica, energia, refrigeração) | Silício: GPU Vera, CPUs, SuperNICs, switches |
| Especificação MGX 1.2 (até 250 kW por rack) | Drivers, bibliotecas e o stack de software de alto nível |
| Quatro componentes open source do DSX | Roadmap e ritmo das gerações de produto |
| Padrões Open Data Center v0.7 e Grid Resilience | Estratégia de plataforma que amarra hardware e software |
| Formato óptico USFP, com Cisco, TE e Amphenol | CUDA e o ciclo de atualização de geração em geração |
A leitura que faço é direta: a NVIDIA abriu o chão de fábrica e manteve fechada a sala das máquinas. Tudo que é caro, lento e repetitivo de construir, rack, refrigeração, distribuição de energia, óptica, provisão de software, virou especificação aberta, para que o ecossistema produza em escala e a custo de mercado. Tudo que é diferenciador, o silício e o software que rodam em cima dele, continua proprietário. Não é hipocrisia; é a estratégia mais racional possível para quem domina a camada de valor. O precedente existia: a empresa já havia aberto designs na era Blackwell, e o que vemos é o playbook replicado com a geração seguinte.
Isso não torna a abertura vazia. O caso da Meta é o contraponto mais forte: uma hyperscaler rodando switch da NVIDIA com sistema operacional próprio, dentro de rack próprio, é interoperabilidade real, não vitrine. O mesmo vale para o Falcon Transport sobre hardware NVIDIA. Onde existe pressão de comprador grande o suficiente, a pilha abre. Onde o comprador é pequeno, ela fecha.
O que fazer com isso, na prática
Para equipes técnicas, o anúncio deixa três consequências operacionais verificáveis nas especificações.
Primeiro, engenharia elétrica de data center muda de patamar: barramento de 5.000 A refrigerado a líquido e racks de 250 kW puxam o ecossistema para alimentação em corrente contínua de alta tensão, a NVIDIA já anunciara em 2025, no mesmo evento do ano anterior, mais de 20 empresas apoiando data centers em 800 VDC, incluindo fornecedores como ABB, Eaton, Schneider Electric, Siemens e Vertiv. Quem projeta instalações precisa começar a tratar 800 VDC como requisito de arquitetura, não como curiosidade.
Segundo, MGX 1.2 vira critério de compra: ao avaliar fornecedores para os próximos ciclos, perguntar conformidade com a especificação, suporte a racks de 250 kW e desenho de refrigeração líquida com conexão blind-mate é due diligence razoável, não modismo.
Terceiro, para times de plataforma, os componentes open source do DSX mudam o custo de integração: um provedor de Cluster API para infraestrutura NVIDIA significa provisionar racks por manifestos Kubernetes, no mesmo fluxo do resto do parque. A inferência prática, minha, não da NVIDIA, é que a fronteira entre "operar servidores" e "operar fábrica de IA" se desloca para o código.
A abertura da Vera Rubin, no fim, é um documento sobre onde está o gargalo de uma indústria. Em 2023, o gargalo era o chip. Em 2026, segundo a própria NVIDIA, é a velocidade de fabricar e implantar. A empresa resolveu abrindo tudo que atrasa a obra, e guardando a chave do que ainda vende.
Perguntas frequentes
A contribuição ao OCP inclui as GPUs da Vera Rubin?
Não. A abertura cobre designs de rack e de bandeja de computação, mecânica, refrigeração líquida e distribuição de energia, , a especificação MGX 1.2, componentes open source do DSX e padrões de rede e de data center. O silício, incluindo GPUs, CPUs, SuperNICs e switches, permanece proprietário da NVIDIA.
O que é a especificação MGX 1.2?
É a versão mais recente da MGX, a arquitetura modular de referência da NVIDIA para servidores de data center. A 1.2 adiciona refrigeração líquida em nível de rack com conexão blind-mate, interconexão interoperável entre racks, barramento de energia de 5.000 A refrigerado a líquido, suporte nativo a equipamentos de 19 polegadas e suporte a implantações de até 250 kW por rack.
O que o USFP muda na prática para redes de IA?
O USFP é um formato de módulo óptico anunciado pela NVIDIA e pela Cisco que suporta 400 Gb/s por via elétrica, com 16 vias full-duplex em pegada do tamanho do OSFP e capacidade de até 12,8 Tb/s por módulo. Isso permite conectar mais pontos de 1,6 Tb/s sem adicionar camadas de rede. Os números de densidade e eficiência são alegações das duas empresas, ainda sem medição independente.
A Vera Rubin já está disponível para compra?
Os materiais do anúncio não confirmam disponibilidade geral. A NVIDIA posiciona o Vera Rubin NVL72 como base para treinamento e inferência em larga escala e o rack de CPU Vera Rubin para cargas de orquestração e execução de ferramentas. Uma afirmação de que o rack de CPU já estaria sendo embarcado aparece em cobertura de terceiros, mas não consta no texto oficial da NVIDIA revisado para este artigo.