
Resumo executivo
O avanço da inteligência artificial aplicada ao desenvolvimento de software, jogos e entretenimento digital tem sido historicamente marcado pela centralização em grandes servidores de nuvem. Esse paradigma impõe custos elevados de infraestrutura por requisição, latência imprevisível e dependência de conectividade constante. Na contramão dessa abordagem convencional, a Supersonic Labs (abre em nova aba) estrutura sua atuação com foco em modelos compactos projetados para executar decisões diretamente no dispositivo do usuário final.
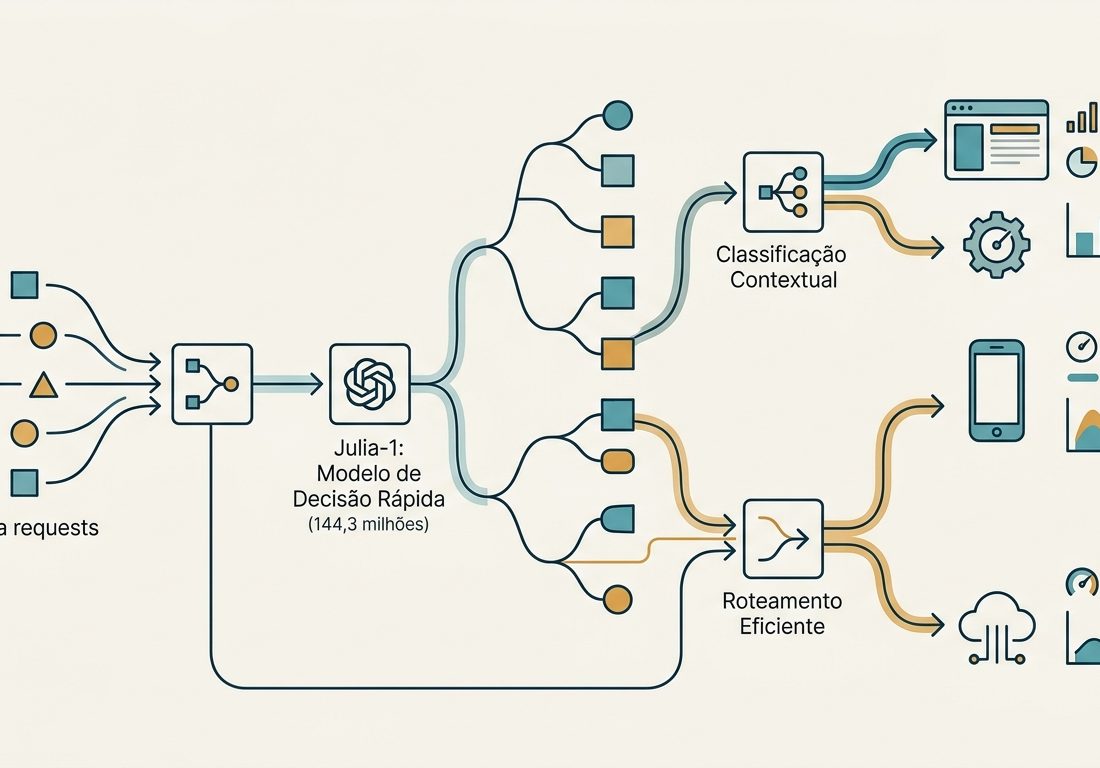
Com o lançamento do Julia-1, primeiro modelo público de sua família de sistemas de decisão, a startup apresenta uma alternativa técnica baseada em eficiência computacional. Ao empacotar capacidades de classificação contextual e roteamento em apenas 144,3 milhões de parâmetros sob licença Apache 2.0, a organização demonstra que componentes decisórios inteligentes podem ser integrados localmente em navegadores e dispositivos modestos. Para executivos e líderes técnicos, esse movimento sinaliza uma oportunidade de repensar a arquitetura de produtos interativos, equilibrando gastos com processamento e privacidade de dados.
O que mudou na dinâmica dos modelos decisórios
A indústria de tecnologia acostumou-se a tratar modelos de linguagem com dezenas ou centenas de bilhões de parâmetros como a resposta padrão para qualquer tarefa automatizada. No entanto, em sistemas interativos como motores de jogos, assistentes de interface e pipelines de atendimento, a necessidade primária raramente é a geração de textos prolixos. A prioridade quase sempre reside na tomada de decisão rápida e determinística a partir de um conjunto delimitado de possibilidades.
A proposta da Supersonic Labs foca na premissa de aproximar a inteligência das máquinas que já fazem parte do cotidiano dos usuários, reduzindo a distância operacional entre o processamento e a ação. O modelo Julia-1 sintetiza essa visão ao operar como um roteador e classificador de decisões que não exige processos lentos de retreino para acomodar novas opções de escolha.
Em termos arquiteturais, o modelo baseia-se no mmBERT-small, um codificador multilíngue ModernBERT desenvolvido pelo JHU CLSP que converte texto em representações vetoriais. A startup desenvolveu uma camada de classificação especializada sobre essa base e treinou o conjunto integrado em formatos específicos de decisão. Embora os pesos do modelo e o código de inferência tenham sido tornados públicos, o pipeline completo de treinamento permanece proprietário, estabelecendo o ativo intelectual que sustenta a evolução da empresa.
Funcionamento técnico e diferenciação arquitetural
Diferente de modelos generativos tradicionais que geram tokens sequenciais de forma probabilística, o Julia-1 funciona processando três elementos em cada chamada de inferência: um estado de contexto (state), uma pergunta ou objetivo (question) e uma lista dinâmica de opções candidatas (options), variando entre duas e vinte alternativas.
O modelo avalia e pontua essas opções na ordem em que são fornecidas. Pelo fato de o significado das respostas candidatas integrar a própria requisição em tempo de execução, os desenvolvedores conseguem alterar rótulos, ramificações de diálogo ou categorias de produtos instantaneamente. Isso elimina o ciclo tradicional de ajuste fino de pesos ou a necessidade de reimplantar cabeças de classificação dedicadas para cada pequena alteração nas regras de negócio.
A interface opera em três modos tipados padronizados:
- Escolha categórica: seleção da melhor opção disponível entre as alternativas apresentadas.
- Pontuação ordenada: classificação e ordenamento de critérios com base em métricas qualitativas ou diretrizes prévias.
- Decisões booleanas: determinação binária simples para bifurcações lógicas de fluxo.
Nos testes técnicos de referência, a arquitetura alcança 73,15% de precisão em decisões tipadas gerais, 94% no conjunto de dados AG News, 86% em detecção de emoções no Emotion e 71,5% no MASSIVE, cobrindo 52 localidades linguísticas.
O grande diferencial operacional está na exportação ONNX combinada à API WebGPU. Essa configuração permite que a inferência aconteça integralmente dentro do navegador web com tempo de resposta de 75 milissegundos por decisão, mantendo paridade idêntica com a execução original em PyTorch. A execução foi validada em processadores convencionais de notebooks como Intel i5-1235U, arquiteturas Apple M4 e até mesmo em tablets Samsung com sistema Android.
Aplicações em jogos, entretenimento e produtos interativos
No segmento de jogos e entretenimento, a inteligência artificial generativa costuma enfrentar dois grandes gargalos: latência perceptível pelo jogador e custos cumulativos de servidores em nuvem. A descentralização viabilizada por modelos decisórios compactos oferece soluções pragmáticas para estúdios e plataformas digitais.
Em primeiro lugar, o controle de personagens não jogáveis pode ser aprimorado com inteligência contextual local. Em vez de depender de árvores de comportamento rígidas ou de chamadas de rede lentas para APIs externas, o motor do jogo pode acionar o modelo localmente para interpretar o estado da cena, avaliar as ações possíveis do personagem e definir uma postura comportamental em menos de 80 milissegundos, sem gerar qualquer custo de nuvem por sessão ativa.
Em segundo lugar, a moderação de conteúdo e a análise de sentimentos em chats de comunidades e jogos multijogador ganham viabilidade econômica. Como o modelo apresenta 86% de precisão em classificação emocional e suporte nativo a dezenas de idiomas, as aplicações podem filtrar toxicidade ou classificar intenções diretamente no cliente, preservando a privacidade dos jogadores e aliviando a infraestrutura central de segurança.
A tabela a seguir contrasta as abordagens tradicionais baseadas em nuvem com a metodologia de modelos de decisão locais proposta pela startup:
| Parâmetro de Comparação | Modelos Generativos em Nuvem | Modelo de Decisão Local (Julia-1) |
|---|---|---|
| Local de Execução | Servidores remotos de alta performance | Processador local ou navegador (WebGPU) |
| Latência por Decisão | 300 a 1500 milissegundos | Aproximadamente 75 milissegundos |
| Custo Marginal de Uso | Valor por milhão de tokens gerados | Nulo após a distribuição do software |
| Flexibilidade de Rótulos | Alta, dependente de engenharia de prompt | Alta, via parâmetros na requisição de inferência |
| Dependência de Conexão | Conexão de internet ativa e estável | Operação totalmente autônoma e offline |
| Privacidade do Usuário | Dados contextuais trafegam na rede | Dados retidos inteiramente no hardware local |
Estrutura corporativa e posicionamento de mercado
Compreender o arranjo institucional da Supersonic Labs exige distinguir a startup de outras marcas que compartilham nomes semelhantes no ecossistema global de tecnologia, como divisões de distribuição móvel ou plataformas de monetização de jogos. A Supersonic Labs posiciona-se estritamente como um laboratório de pesquisa prática focado na utilidade e proximidade da inteligência computacional, enfatizando sistemas abertos voltados para o mundo real.
No que tange aos aspectos corporativos formais, as identidades dos fundadores individuais e a estrutura detalhada de investidores institucionais permanecem restritas aos canais privados da empresa. A startup não divulga rodadas públicas de captação de risco em seus materiais oficiais, concentrando a presença pública na entrega de artefatos de código, modelos sob licença permissiva e métricas de desempenho técnico.
Essa postura de discrição societária combinada com abertura de modelos sinaliza uma estratégia comum em startups de infraestrutura profunda: atrair primeiro a comunidade de desenvolvedores e tomadores de decisão técnica pela utilidade prática do software, para posteriormente monetizar camadas corporativas, serviços de consultoria especializada ou ambientes de treinamento proprietários.
Riscos, limitações e trade-offs para gestores
Apesar do apelo econômico proporcionado pela ausência de custos de inferência em nuvem, a adoção de modelos como o Julia-1 exige ponderação técnica criteriosa por parte dos gestores de tecnologia. O modelo não é um substituto universal para qualquer tarefa cognitiva.
O primeiro ponto de atenção diz respeito à taxa de assertividade. Embora o índice de 73,15% em decisões tipadas e 94% em classificação de notícias represente um patamar competitivo para uma rede de apenas 144,3 milhões de parâmetros, esse nível de acerto pode ser insuficiente para automações críticas onde o erro implique danos financeiros imediatos ou falhas de conformidade regulatória.
O segundo limitador é funcional. Modelos dessa categoria tomam decisões estruturadas a partir de um leque pré-definido de candidatos, mas não possuem capacidade para sintetizar textos longos, escrever diálogos elaborados ou gerar imagens. O valor da tecnologia reside na triagem, no roteamento e no controle lógico, demandando que outras soluções sejam acopladas caso a geração de ativos criativos seja necessária.
Adicionalmente, há considerações de hardware nos clientes finais. Embora o modelo tenha sido testado com sucesso em processadores comuns e dispositivos móveis, a utilização intensiva de WebGPU em navegadores antigos ou em aparelhos de entrada pode encontrar incompatibilidades técnicas ou concorrer com a renderização visual da própria aplicação.
Implicações estratégicas para a liderança técnica
A movimentação da Supersonic Labs com a linhagem Julia ilustra uma mudança clara no pêndulo da inteligência artificial aplicada. Os líderes empresariais que buscam escalabilidade precisam reavaliar os seus custos operacionais contínuos e considerar a adoção de arquiteturas híbridas.
As principais repercussões estratégicas incluem:
- Redução do custo total de propriedade: delegar a classificação preliminar de comandos e a navegação contextual para o cliente final reduz o tráfego em servidores e mitiga a fatura de provedores de nuvem.
- Preservação da experiência do usuário: tempos de resposta na faixa de 75 milissegundos viabilizam interações fluidas em jogos e aplicativos, evitando telas de carregamento enquanto uma resposta de nuvem é aguardada.
- Resiliência operacional: softwares desenhados para tomar decisões localmente mantêm funcionalidade central preservada mesmo em cenários de instabilidade de rede ou ambientes desconectados.
- Facilidade de iteração de produto: a possibilidade de alterar as regras e as alternativas de decisão sem disparar novos ciclos de retreino encurta o ciclo de validação de recursos por equipes de produto.
Em um cenário onde as despesas operacionais ligadas à inteligência artificial ganham peso crescente nos balanços corporativos, abordagens de engenharia baseadas em modelos ultracompactos deixam de ser uma curiosidade acadêmica e tornam-se ferramentas viáveis de controle financeiro e vantagem técnica competitiva.