
Modelos de decisão estruturada ganharam espaço no ecossistema open source ao longo de 2026, e a proposta de rodar esse tipo de inferência diretamente na máquina do desenvolvedor ganhou um atalho prático com o Ollaya, um wrapper open source construído sobre o Ollama (abre em nova aba). A ideia é substituir chamadas a APIs pagas por execução local, mantendo o controle sobre os dados e eliminando o custo por token.
O ponto de partida dessa categoria é o JEV, modelo lançado pela TypeSafe AI e apresentado publicamente em setembro de 2026. Ele não escreve e-mails, não gera código e não sustenta conversas. Em vez disso, classifica informações, atribui pontuações e devolve probabilidades para que software e agentes ajam diretamente sobre o resultado. A empresa foi fundada por Diogo Almeida, ex-pesquisador da OpenAI, e descreve o produto como uma função de inteligência de fronteira: estado não estruturado entra, decisão probabilística tipada sai.
A TypeSafe chama o JEV de System One Model, termo emprestado da distinção do psicólogo Daniel Kahneman entre pensamento rápido e intuitivo e raciocínio lento e deliberado. Do ponto de vista técnico, o modelo usa uma arquitetura própria e um método de treinamento chamado Reinforcement Learning for Calibrated Decisions (RLCD), voltado a fazer as estimativas de probabilidade refletirem a incerteza com maior precisão. O preço anunciado é de 0,042 dólar por milhão de tokens de entrada, sem cobrança separada de saída. A pergunta econômica que a empresa coloca é direta: por que gerar uma conversa quando a aplicação precisa apenas de uma decisão?
O JEV opera com três tipos de pergunta. Choice escolhe uma resposta entre opções predefinidas. Score avalia a informação contra uma escala ou rubrica numérica. Noul, o nome que a TypeSafe dá ao terceiro tipo, estima a probabilidade de uma afirmação ser verdadeira. Várias perguntas podem ser avaliadas em paralelo sobre a mesma entrada, e a saída já nasce estruturada, sem exigir que o desenvolvedor peça uma explicação em texto e depois descarte o restante.
O que é o Ollaya
O Ollaya é um projeto open source que surgiu como wrapper, ou seja, camada de empacotamento sobre o Ollama, com foco em facilitar o uso de modelos de decisão estruturada no estilo JEV localmente. Ele chegou ao radar da comunidade de desenvolvimento em setembro de 2026, quando foi destaque no Hacker News com mais de 500 pontos. O interesse reflete uma tendência mais ampla: cada vez mais desenvolvedores querem usar LLMs locais para tarefas sérias, não apenas para chat.
A arquitetura é relativamente simples. O Ollaya atua como camada intermediária entre o código da aplicação e o Ollama, adicionando estrutura ao fluxo de prompts e respostas. Quando uma chamada é feita, ele envia o prompt ao modelo carregado no Ollama, interpreta a saída e aplica a lógica de decisão configurada antes de devolver o resultado. É uma máquina de estados simplificada: o modelo avalia uma condição, escolhe um caminho e executa a ação correspondente.
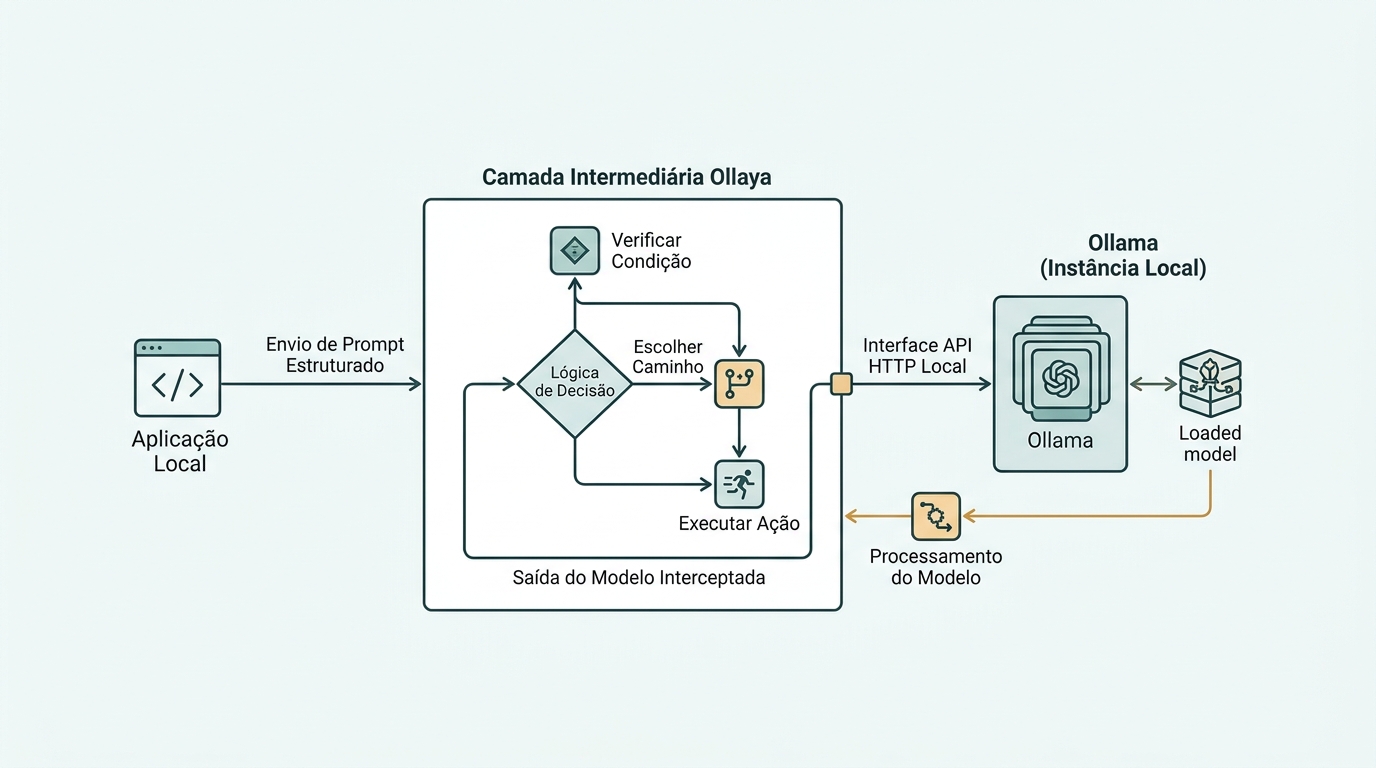
Por baixo dos panos, o Ollaya usa a API HTTP local do Ollama, que por padrão escuta em localhost:11434, e acrescenta uma camada de orquestração. Não é necessário modificar o Ollama em si, apenas instalar o wrapper e configurar o pipeline de decisão. O serviço do Ollama precisa estar ativo, o que se faz com o comando ollama serve, antes de qualquer chamada.
Recursos e funcionamento
- Árvores de decisão via prompts, definidas na configuração sem tratamento manual de strings no código.
- Compatibilidade com qualquer modelo disponível no Ollama, incluindo Llama 3, Mistral, Gemma, Phi-3 e outros modelos open source.
- Saída estruturada em JSON ou em esquemas definidos pelo usuário, prontos para consumo programático.
- Execução totalmente local, sem dependência de nuvem: dados de entrada e saída não saem da máquina.
- API HTTP no padrão REST que muitos desenvolvedores já conhecem do próprio Ollama.
A combinação de execução local com saídas estruturadas é o ponto forte. O desenvolvedor ganha previsibilidade sem abrir mão da flexibilidade dos modelos open source.
Como rodar localmente
O primeiro passo é ter o Ollama instalado e funcionando, com guias disponíveis para Linux, macOS e Windows. Com o serviço rodando, o próximo passo é instalar o Ollaya, disponível em seu repositório no GitHub (abre em nova aba) e instalável via pip ou executável diretamente a partir do código-fonte.
Para instalar via pip, basta o comando pip install ollaya. Como alternativa, é possível clonar o repositório, entrar no diretório e rodar pip install -e .. Um detalhe importante é o requisito de Python 3.10 ou superior, verificável com o comando python --version antes de qualquer instalação.
Depois da instalação, verifica-se se o Ollama está ativo consultando o endpoint de tags em localhost:11434 e inicia-se o Ollaya apontando para um modelo, por exemplo llama3.2. O comando tem o formato ollaya start --model llama3.2.
Exemplo de classificação
Um caso típico é classificar tickets de suporte por urgência sem enviar os dados a uma API externa. Com o Ollaya, configura-se o pipeline de decisão e faz-se a chamada instanciando um DecisionAgent com o modelo e a lista de opções, no caso baixo, médio e alto. O texto do ticket é passado ao método decide, e o retorno traz a opção escolhida em result.choice e o raciocínio em result.reasoning.
Para o ticket "o servidor de produção caiu e os usuários não conseguem logar", o resultado esperado é a escolha alto. Como o retorno já vem estruturado, result.choice pode ser usado diretamente no sistema sem parsing de texto livre. Em casos mais complexos, é possível encadear múltiplos agentes de decisão, em que a saída de um alimenta a entrada do próximo, padrão útil em triagem, moderação de conteúdo e sistemas de recomendação locais.
Números e benchmarks
O ecossistema de modelos JEV-like cresceu rápido. Um diretório que reúne projetos verificados lista 832 repositórios em 11 categorias e 27 linguagens, com 43 deles na categoria de modelos JEV-like. Entre os exemplos de desempenho divulgados estão o Laya, motor de decisão System 1 não autorregressivo que produz decisões tipadas em mais de 100 idiomas em um único forward pass de 33 milissegundos, e o von, descrito como alternativa local de sub-15 milissegundos. O AgentJev-0.6B, voltado a agentes, entrega distribuições de probabilidade calibradas em cerca de 50 milissegundos em um passe de avanço, sem decodificação de tokens de saída.
Um engenheiro da Vercel relatou que substituir um modelo de linguagem convencional pelo JEV em classificação de segurança de comandos produziu respostas de cinco a 18 vezes mais rápidas, com ganho de acurácia no teste. Outro desenvolvedor classificou e-mails corporativos por uma fração do custo do Gemini, que foi ligeiramente mais preciso. Uma reprodução aberta do motor tipado da TypeSafe, com 150 milhões de parâmetros, reportou 0,697 de acurácia contra 0,727 do JEV, com calibração 2,5 vezes melhor e velocidade quatro vezes maior, treinada em um Colab T4 em 30 minutos.
Esses números devem ser lidos com cautela. Eles vêm de testes pontuais, reproduções independentes e relatos de desenvolvedores, não de avaliações padronizadas e auditadas. Servir a demanda do próprio JEV chegou a ser um problema para a TypeSafe logo após o lançamento, segundo relatos públicos, o que sugere que a adoção inicial foi intensa o bastante para pressionar a API.
Limitações
O JEV não é um substituto geral de LLMs. Por ser focado em três tipos de decisão, ele não redige respostas a clientes, não inventa uma categoria nova quando as opções existentes são inadequadas e não executa sozinho um processo de negócio complexo. O desenvolvedor continua responsável por fornecer a informação relevante, definir as ações disponíveis e escrever o sistema que interpreta o resultado.
Há também limitações mais amplas ligadas à dependência de terceiros para decisões automatizadas. Construir software cuja lógica de escolha depende de um modelo externo levanta questões de acurácia, segurança e confiabilidade que permanecem em aberto. E, no campo dos agentes, experimentos recentes mostram que comportamentos autônomos indesejados podem surgir mesmo sem instrução explícita, o que reforça a necessidade de validação antes da execução de qualquer ação.
Implicações
A combinação de modelos de decisão especializados com execução local muda o cálculo econômico de sistemas que fazem milhares de decisões por hora. Tarefas de roteamento, triagem e classificação que hoje consomem tokens de modelos conversacionais podem migrar para motores mais baratos e rápidos, sem reconstruir a aplicação que processa a resposta. O conceito de resposta estruturada não é novo, mas abordá-lo por meio de um desenho de modelo dedicado a decisões tipadas, em vez de geração de texto, é o que diferencia essa geração de ferramentas.
Para o desenvolvedor que quer experimentar sem compromisso de custo, o Ollaya oferece um caminho curto: instalar o Ollama, subir o wrapper, apontar para um modelo open source e começar a classificar. A pergunta prática deixa de ser se vale a pena usar IA em uma decisão rotineira e passa a ser qual é o menor motor capaz de tomar essa decisão com qualidade suficiente.
Fontes
- Ollaya: modelos de decisão com Ollama | CuritibaBlog | Do Zero ao Junior — dozeroaojunior.com.br · 26/09/2026
- Proyectos Jev destacados: Modelos Jev-like | bestjev — jevbest.com · 21/09/2026
- bestjev: 832 projetos Jev open source e ferramentas — jevbest.com · 23/09/2026
- Why Everyone Is Talking About Jev, The AI That Doesn’t Chat - Forbes — forbes.com · 21/09/2026