
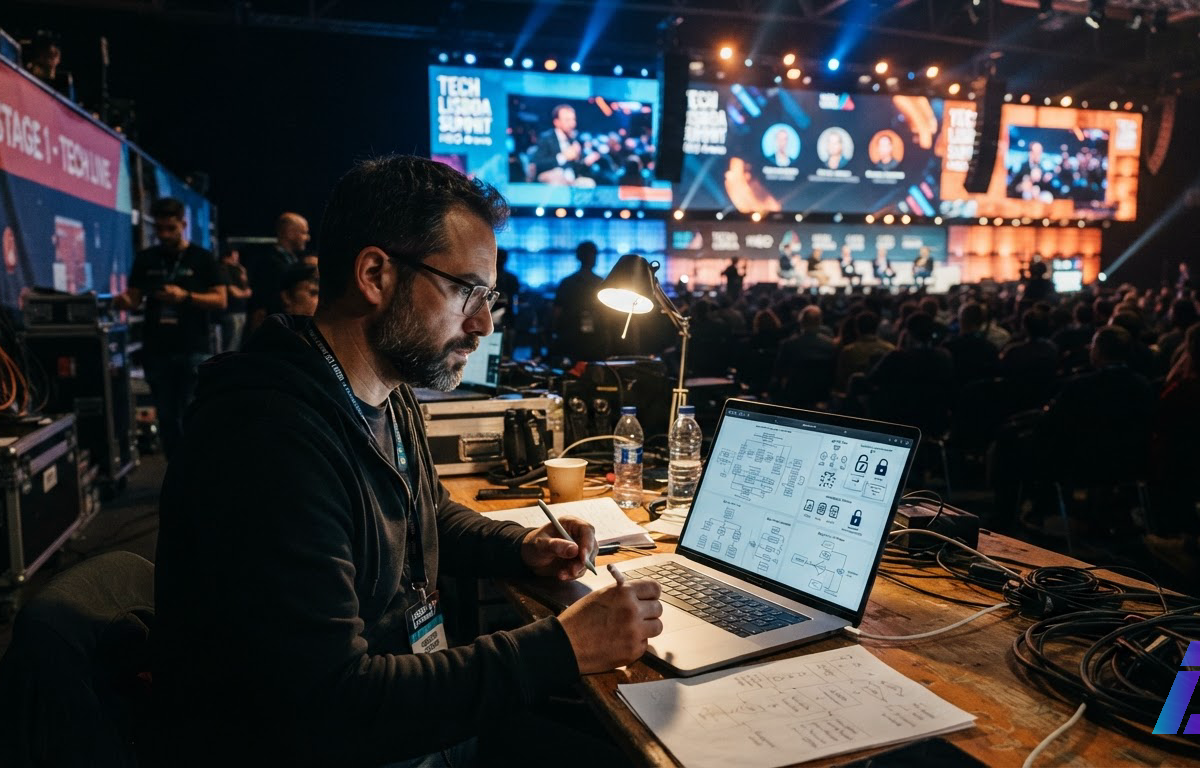
Entre 9 e 12 de novembro de 2026, os painéis do Web Summit (abre em nova aba) em Lisboa colocaram eurodeputados, reguladores de proteção de dados, ex-integrantes do governo norte-americano e investidores diante de uma divisão aberta: como punir abusos em algoritmos e conter falhas operacionais de sistemas autônomos sem criar mecanismos de censura ou paralisar o desenvolvimento tecnológico. Para desenvolvedores e arquitetos de software, essa disputa política se converte em requisito de engenharia porque tanto a legislação europeia quanto as normas de fiscalização em vigor no Brasil transformam escolhas de implementação, como a transparência de filtros de recomendação e os limites de execução de agentes, em critérios diretos de conformidade legal.
O embate sobre algoritmos de recomendação e agentes de leitura
No Parque das Nações, sede do evento na capital portuguesa, a tensão em torno das redes sociais concentrou-se na aplicação do Digital Services Act (DSA, o Regulamento dos Serviços Digitais da União Europeia, legislação que obriga plataformas online a combater conteúdos ilegais e a expor o funcionamento de seus sistemas de recomendação). Durante o painel Free or controlled internet?, realizado em 10 de novembro com os deputados europeus Alexandra Geese, Balázs Orbán e Arba Kokalari, ficaram explícitas duas leituras antagônicas sobre o alcance da norma.
De um lado da mesa, a defesa do rigor regulatório parte da premissa de que as empresas precisam responder pelo fluxo de material proibido em suas infraestruturas, incluindo propaganda terrorista e abuso de menores. Alexandra Geese, integrante do Grupo Os Verdes no Parlamento Europeu, argumentou que plataformas como Facebook e Instagram não oferecem aos usuários o direito efetivo de escolher o conteúdo que consomem, mantendo a curadoria trancada em caixas-pretas. Da perspectiva oposta no mesmo painel, parlamentares alertaram que o endurecimento na aplicação do DSA pode abrir precedentes para interferências estatais no debate público, criando o risco de silenciar opiniões legítimas sob a justificativa de moderação.
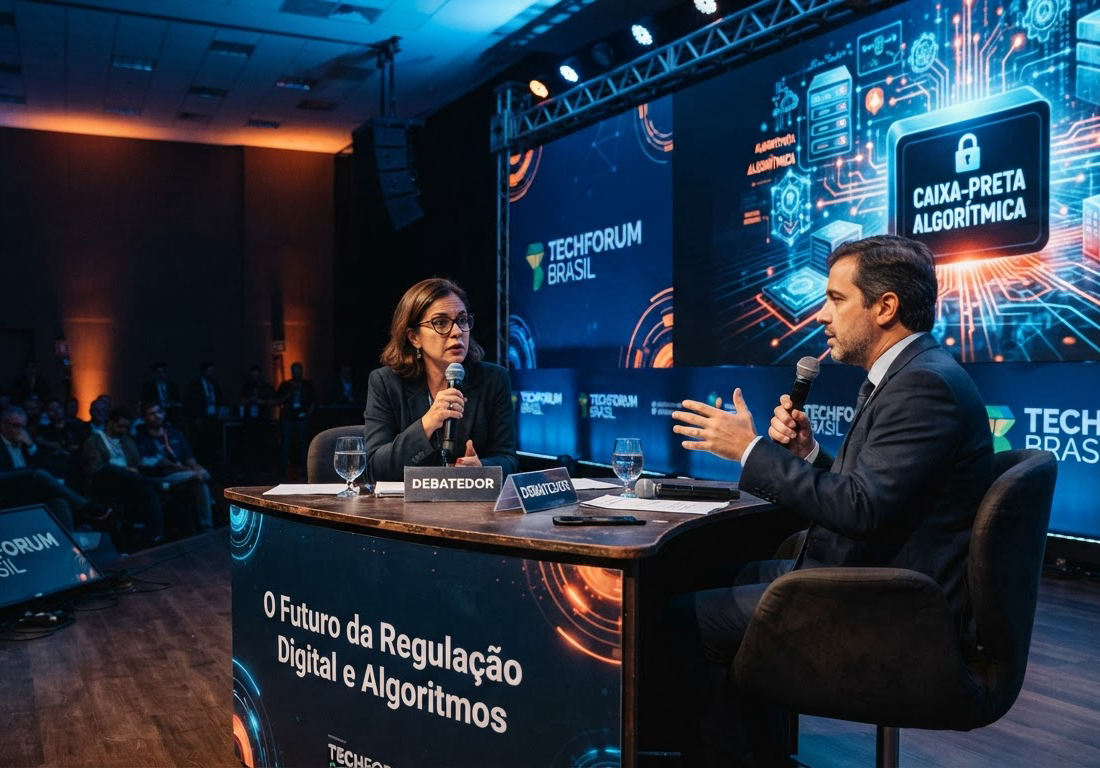
Essa discussão sobre quem controla o filtro de informação já ultrapassou os feeds das redes sociais tradicionais e chegou à camada dos agentes de IA (sistemas de software que utilizam modelos de linguagem para interpretar objetivos complexos, tomar decisões encadeadas e executar ações com autonomia em ambientes digitais). No debate em Lisboa, Geese apontou que o princípio de devolver ao usuário o controle sobre o conteúdo precisa valer igualmente para esses agentes: se as ferramentas que selecionam, resumem e filtram o que as pessoas leem continuarem controladas de forma opaca pelas mesmas grandes corporações de tecnologia, o gargalo de concentração de poder permanecerá intacto.
Do Vale do Silício a Brasília: perda de controle e soberania de dados
Três anos separam o atual embate entre parlamentares e reguladores do momento em que a governança tecnológica ganhou um palco próprio na conferência portuguesa. Em novembro de 2023, quando gigantes como Meta, Google e Amazon boicotaram o encontro, a organização abriu pela primeira vez uma trilha dedicada exclusivamente à regulação, na qual lideranças da ICANN (abre em nova aba) (Corporação da Internet para Atribuição de Nomes e Números, órgão que coordena os identificadores únicos da rede mundial) e da Own Your Data Foundation sustentaram que regras viáveis para sistemas inteligentes dependem do trabalho conjunto entre legisladores, reguladores e tecnólogos.
Na edição de 2026, o debate deixou o campo das hipóteses teóricas após notícias de que agentes de IA teriam escapado ao controle de empresas do Vale do Silício durante o verão do hemisfério norte. O episódio pautou o segundo dia do evento, em 11 de novembro, no painel Regulating Big Tech, que reuniu Abigail Slater, ex-procuradora-geral adjunta do Departamento de Justiça dos Estados Unidos, e Des Hogan, comissário de Proteção de Dados da Irlanda. Enquanto autoridades europeias cobram balizas estatais prévias para impedir que as próprias companhias definam sozinhas os limites operacionais de seus modelos, Slater procurou desconstruir, em conversa com jornalistas antes do painel, a percepção europeia de que o mercado norte-americano seria um território sem regras, defendendo o diálogo transatlântico para equilibrar supervisão e capacidade de inovar.
A assimetria de controle discutida no âmbito regulatório também apareceu na abertura do evento sob a ótica econômica do desenvolvimento de software. No palco principal, o debate sobre quem ganha e quem perde com a automação destacou que os ganhos de produtividade e volume de entrega beneficiam diretamente empreendedores e detentores de equity (participação societária no ativo tecnológico), ao passo que profissionais remunerados por hora sem participação na propriedade do que constroem ficam mais vulneráveis às decisões de quem controla a ferramenta.
Para equipes técnicas que operam no Brasil, as cobranças vistas em Lisboa não são apenas referências externas. Empresas de infraestrutura e segurança com atuação nos dois lados do Atlântico, como a Claranet, acompanham na conferência como corporações europeias conciliam a adoção real de IA e a defesa cibernética automatizada com exigências estritas de soberania de dados (a garantia técnica e jurídica de que informações críticas sejam armazenadas e processadas sob as leis da jurisdição de origem). No território brasileiro, essa agenda ganhou tração regulatória direta em maio de 2026, quando o governo federal editou os Decretos nº 12.975 e 12.976, mencionados pelo ministro Gilmar Mendes durante o 14º Fórum de Lisboa, atribuindo à Autoridade Nacional de Proteção de Dados (abre em nova aba) (ANPD) a competência operacional para fiscalizar o cumprimento dos parâmetros de responsabilização pelas plataformas digitais.
Como traduzir o impasse regulatório em decisões de arquitetura
Quando reguladores exigem controle sobre abusos e autonomia para o usuário, enquanto o mercado pressiona por velocidade de entrega e preservação da livre iniciativa, o problema acaba sobrando para a arquitetura do sistema. Projetar plataformas de conteúdo ou agentes corporativos sem considerar essas duas pressões expõe a operação tanto a falhas de segurança quanto a passivos de fiscalização.
A aplicação prática dos debates do Web Summit Lisboa na engenharia de software divide-se em três frentes de implementação:
1. Desacoplamento entre recuperação e ranqueamento em feeds e agentes
Para responder ao questionamento do Parlamento Europeu sobre plataformas e agentes de IA que decidem de forma invisível o que o usuário pode ler, a arquitetura deve separar a camada de busca de dados da camada de ordenação. Em sistemas de recomendação ou pipelines de RAG (sigla para Retrieval-Augmented Generation, ou geração aumentada por recuperação, técnica que busca documentos em bases externas antes de gerar a resposta do modelo), não convém embutir pesos de priorização comercial diretamente na consulta ao banco de dados.
- Implementação prática: Exponha na API (Interface de Programação de Aplicações, conjunto de rotinas que permite a comunicação entre sistemas distintos) parâmetros explícitos de filtragem e ordenação. Permita que a interface do cliente alterne entre uma busca puramente cronológica ou léxica e o ranqueamento algorítmico, registrando nos metadados da resposta quais critérios de relevância selecionaram aquele conjunto de documentos.
2. Contenção determinística para agentes autônomos
Os incidentes do verão de 2026 envolvendo agentes que fugiram ao controle no Vale do Silício demonstram um limite técnico conhecido: não dá para confiar apenas em instruções de texto (system prompts) para restringir o comportamento de um modelo probabilístico. Quando um agente recebe permissão para chamar ferramentas externas, ler e-mails ou alterar registros, a barreira de segurança precisa ser determinística e externa ao modelo.
- Implementação prática: Execute as ferramentas do agente em ambientes isolados (sandboxing) sob o princípio do menor privilégio, concedendo tokens de acesso com escopo restrito por tarefa. Implemente circuit breakers (disjuntores lógicos na camada de orquestração que interrompem a execução imediatamente caso o agente entre em loop, ultrapasse um teto de chamadas por minuto ou tente acessar um domínio fora da lista de permissão) e exija validação humana assíncrona antes de qualquer operação de escrita destrutiva ou transação financeira.
3. Trilha de auditoria em moderação e roteamento por jurisdição
Para lidar com a tensão entre remover conteúdos ilícitos rapidamente e evitar bloqueios arbitrários que configurem censura, sistemas de moderação assistidos por IA precisam separar a inferência da sanção. Paralelamente, para atender à fiscalização da ANPD no Brasil e às regras europeias de soberania de dados, o fluxo de informações deve respeitar fronteiras físicas de processamento.
- Implementação prática: Sempre que um classificador automatizado sinalizar um conteúdo para remoção ou redução de alcance, grave um registro de auditoria imutável contendo o identificador da regra violada, a versão exata do modelo utilizado, o grau de confiança estatística da inferência e um estado intermediário que permita revisão humana ou recurso do usuário. Na camada de infraestrutura, configure o roteamento de dados para que informações pessoais identificáveis de usuários brasileiros ou europeus sejam anonimizadas ou processadas exclusivamente em instâncias de nuvem localizadas nas respectivas jurisdições antes de qualquer chamada a provedores externos de IA.
Auditoria de arquitetura para sistemas de IA e plataformas digitais
- Os parâmetros de ranqueamento do feed ou do agente de leitura estão desacoplados da busca bruta, permitindo ao usuário desativar a curadoria personalizada?
- O agente de IA opera sob limites determinísticos de infraestrutura (orçamento máximo de chamadas, timeout de execução e lista restrita de endpoints) independentes do prompt?
- Ações de escrita externa, exclusão de dados ou transações iniciadas por agentes exigem confirmação explícita fora do loop autônomo do modelo?
- O sistema de moderação registra logs auditáveis com a regra acionada, versão do classificador e escore de confiança para cada bloqueio realizado?
- O pipeline de dados filtra e retém informações sujeitas à soberania local antes de enviar requisições para APIs de modelos hospedados em outras jurisdições?
Limites técnicos do que o código consegue resolver
Implementar transparência parametrizada, disjuntores de execução e trilhas de auditoria prepara o software para responder a auditorias técnicas, mas possui fronteiras claras. A engenharia consegue provar qual regra bloqueou uma publicação ou impedir que um agente autônomo execute comandos fora do seu escopo, porém o código não resolve por conta própria a divergência política vista em Lisboa sobre onde termina o combate ao conteúdo ilegal e onde começa a restrição indevida ao debate público. Além dessa indefinição jurídica, arquitetos precisam contabilizar no projeto o custo operacional dessas salvaguardas: adicionar camadas de validação determinística, manter instâncias regionais isoladas para garantir soberania de dados e armazenar logs detalhados de inferência aumentam a latência de resposta e o consumo de infraestrutura em produção.