
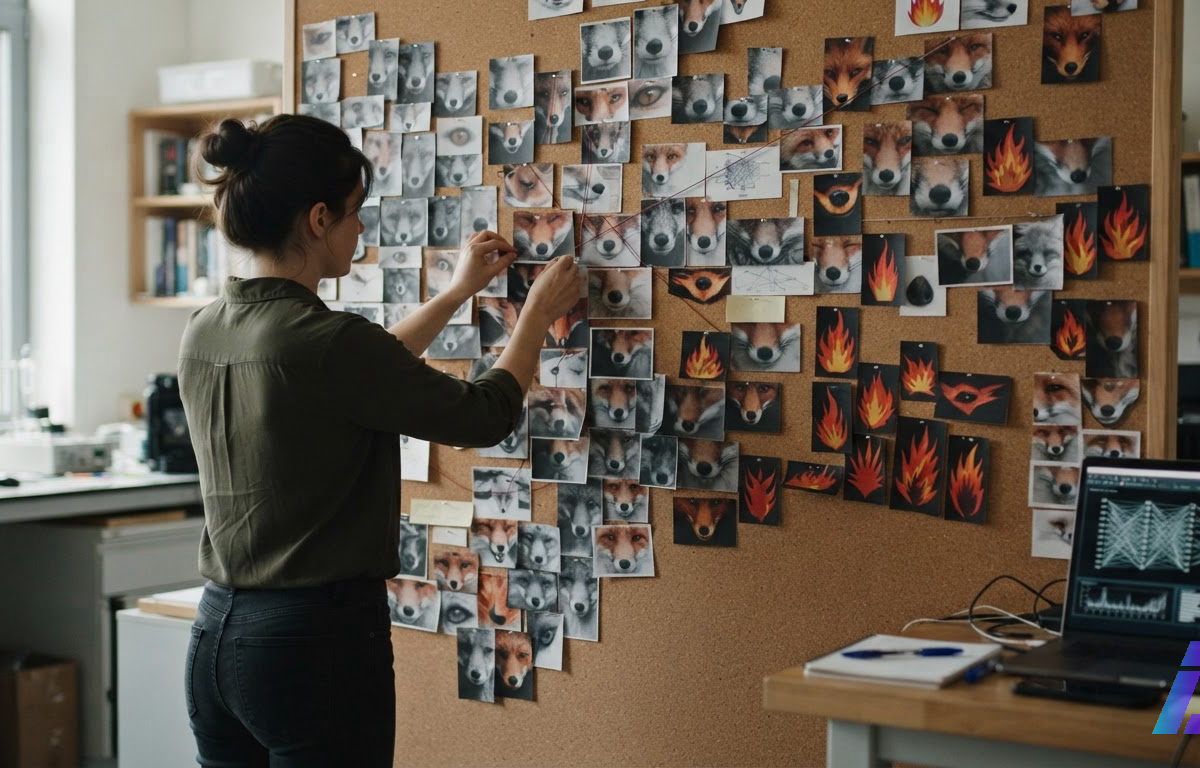
Durante anos, o neurônio que dispara tanto para gatos quanto para carros foi o exemplo obrigatório da interpretabilidade mecanística. Aparecia em palestras, em threads e em toda introdução ao tema, sempre com a mesma explicação: redes neurais têm mais conceitos do que neurônios e, por isso, empacotam ideias sem relação numa mesma unidade. Em 15 de outubro, um dos autores que puseram esse exemplo em circulação voltou para corrigir a explicação. Segundo Nick Cammarata, aquele não é um neurônio de gato e carro, e sim um detector de V. Formas pontudas, como chamas e focinhos de raposa, ativam o neurônio. Formas redondas o empurram para o lado negativo.
A correção pesa por causa de quem a assina. Cammarata hoje pesquisa na Goodfire (abre em nova aba), startup de interpretabilidade, e antes estava na OpenAI. Em 2020, coassinou com Chris Olah o "Zoom In", artigo da Distill que apresentou o primeiro circuito exibido como evidência de superposição. Em 2023, iniciou o projeto de interpretabilidade automatizada da OpenAI, que considerou legíveis cerca de 1,7% dos neurônios, e isso pela medida mais generosa. O ensaio novo, Neural Networks Are Already Clean (abre em nova aba), tem 26 mil palavras e afirma que as duas leituras estavam erradas. A MIT Technology Review resumiu o caso com uma frase entre aspas no título: "Estávamos olhando errado".
O que o ensaio afirma
A tese central é que a polissemia observada nos primeiros "organismos-modelo" da área não vinha de superposição. Vinha de vários problemas comuns, em sua maioria corrigíveis. O que parecia empacotamento arbitrário seria, na maior parte dos casos, um padrão que Cammarata chama de generalização recursiva, que ele descreve como "muito menos preocupante". O caso do V mostra a mudança de pergunta. Em vez de perguntar por que coisas sem relação dividem um neurônio, ele passou a perguntar o que essas coisas têm em comum. A consequência prática, nas palavras do ensaio, é que dá para estudar as redes diretamente, sem antes desembaraçá-las.
Minha leitura é que o ensaio vale mais pela crítica de método do que pelos números que apresenta, e que esses números, por enquanto, não sustentam o título. "Já são limpas" é uma afirmação sobre as redes. O que o texto demonstra até aqui é uma afirmação sobre as ferramentas: boa parte da sujeira estava no instrumento de observação. Isso já é bastante. Se estiver certo mesmo pela metade, anos de intuição sobre por que redes são opacas precisam ser revistos. Mas passar de "nossas ferramentas eram ruins" para "as redes são legíveis" depende de um paper técnico que ainda não foi publicado.
Os números, com as devidas etiquetas
O caso mais forte é o da InceptionV1. Quando a equipe começou a estudar esse modelo, quase nenhum neurônio da última camada parecia interpretável. Segundo Cammarata, depois de melhorias que ele chama de comuns, sem mudar o tamanho do modelo nem os dados de treino, de 99% a 100% dos neurônios dessa camada se tornaram facilmente interpretáveis. O trecho divulgado não detalha quais foram essas melhorias, e é exatamente isso que um engenheiro vai querer ler primeiro.
Nos modelos de linguagem, os números vêm de auditorias preliminares do Qwen3-32B, conduzidas, segundo a Crypto Briefing, com métodos agênticos:
| Categoria (auditoria preliminar, Qwen3-32B) | Parcela estimada |
|---|---|
| Um trabalho principal, muitas vezes com pequenas ramificações relacionadas | ~90% |
| Dois trabalhos relacionados | ~7% |
| Ainda não compreendidos | 2–4% |
Um detalhe que a cobertura costuma omitir: a unidade contada é o "polo" do neurônio, não o neurônio inteiro. O exemplo do V sugere a razão, já que o lado positivo e o lado negativo da ativação podem responder a coisas diferentes. A página da Goodfire vai além e diz que já é possível entender a maioria dos neurônios em modelos de até trilhões de parâmetros.
A comparação que mais circula, 1,7% em 2023 contra 90% agora, não se sustenta. A própria cobertura especializada alertou: os dois números vêm de ferramentas, modelos e critérios diferentes. A tentação de colocá-los lado a lado é grande porque o mesmo autor assina ambos. Mas os dois números não medem a mesma coisa.
Por que isso interessa a quem constrói sistemas
A hipótese da superposição definiu o ferramental da área. Se cada neurônio mistura muitos conceitos, primeiro é preciso decompor as ativações numa base maior de features, e foi assim que dicionários esparsos e sparse autoencoders viraram o caminho padrão. Se Cammarata tiver razão, o neurônio já é a unidade de análise, e essa etapa intermediária, cara, passa a ser ao menos em parte opcional. Para quem monitora ou faz steering de modelos, isso muda custo e confiança. Ler um neurônio custa menos do que treinar um dicionário sobre as ativações, e não introduz um segundo modelo cujos erros também precisam ser interpretados.
A melhor característica da tese é que ela pode ser verificada. O Qwen3-32B tem pesos abertos. Qualquer grupo com GPU e paciência pode tentar reproduzir a distribuição de 90/7/3 quando o método for publicado, e isso vale mais do que qualquer nota de entusiasmo.
A frase mais otimista de Cammarata na entrevista à MIT Technology Review também traz o número mais sóbrio. Ele disse que, se tivesse 100 mil anos para examinar um modelo de linguagem de fronteira, um circuito de cada vez, haveria uma boa chance de chegar a uma boa compreensão. Ser legível em princípio não significa ser auditável na prática. Em escala, a leitura precisa ser automatizada, o que transfere o julgamento sobre o que cada polo faz para outros modelos.
O melhor contraponto
Chris Potts, de Stanford, foi direto: o que Cammarata compartilhou é pouco mais que um palpite. A crítica parece dura, mas o próprio ensaio traz no cabeçalho a etiqueta "A working hypothesis", ou hipótese de trabalho. No dia seguinte à repercussão, o autor reconheceu publicamente as lacunas. A admissão importa porque vem de quem tem mais interesse em defender o texto:
algumas coisas sobre o ensaio em si. ele não tinha citações suficientes, só as da história básica, porque era um "ensaio de pesquisa informal e hipótese de trabalho" e não um paper, e outros trabalhos anteriores sobre neurônios estavam no paper técnico que ainda estamos terminando. mas ele explodiu, então também acrescentei citações ao ensaio. também quero agradecer a @curttigges, que fez boa parte da pesquisa sobre neurônios de linguagem comigo
A versão mais forte do contraponto, porém, não é "falta o paper". Ela tem três partes.
O critério é elástico. "Um trabalho principal, muitas vezes com pequenas ramificações relacionadas" é uma categoria generosa. Ninguém sabe ainda onde termina uma ramificação relacionada e onde começa a polissemia. Também não está claro quem julga, se humanos ou agentes, nem com que taxa de concordância entre eles.
Corrigir os exemplos clássicos não elimina o fenômeno. Mostrar que os exemplos canônicos foram mal interpretados não prova que a superposição não acontece. Os 7% com dois trabalhos e os 2% a 4% sem explicação são justamente onde ela poderia estar. Para segurança, é essa parcela que importa. Um monitor que entende 90% dos polos e deixa escapar o comportamento raro escondido nos 3% restantes não resolve o problema que motivou a área.
Ativações fracas e escala continuam em aberto. O próprio Cammarata listou entre as perguntas que o ensaio levantou o peso das ativações fracas e o efeito da escala. Classificar um polo por suas ativações mais fortes é o procedimento natural. Se o comportamento relevante estiver nas ativações fracas, a classificação pode estar certa e a conclusão, errada.
Há ainda um dado de contexto que não invalida nada, mas deve ficar à vista: a Goodfire vende interpretabilidade. Uma tese que torna o produto mais viável merece o mesmo escrutínio que receberia se viesse de qualquer outro fornecedor.
O que verificar quando o paper sair
- Critério e juiz: a definição exata de "um trabalho principal" e se a classificação foi feita por humanos, por agentes ou por ambos.
- As "melhorias comuns": quais são e se reproduzem o salto da InceptionV1 fora da Goodfire.
- Ativações fracas: se a análise cobre só os picos ou toda a distribuição.
- Camada e escala: como a parcela de polos legíveis varia ao longo das camadas e entre tamanhos de modelo.
- Replicação independente no Qwen3-32B: é o teste mais barato e o mais decisivo.
Por enquanto, a descrição honesta é a que está no cabeçalho do próprio ensaio: uma hipótese de trabalho, proposta por quem ajudou a construir a leitura que agora contesta. Ela será confirmada ou derrubada pelo paper técnico e por uma replicação aberta no Qwen3-32B.