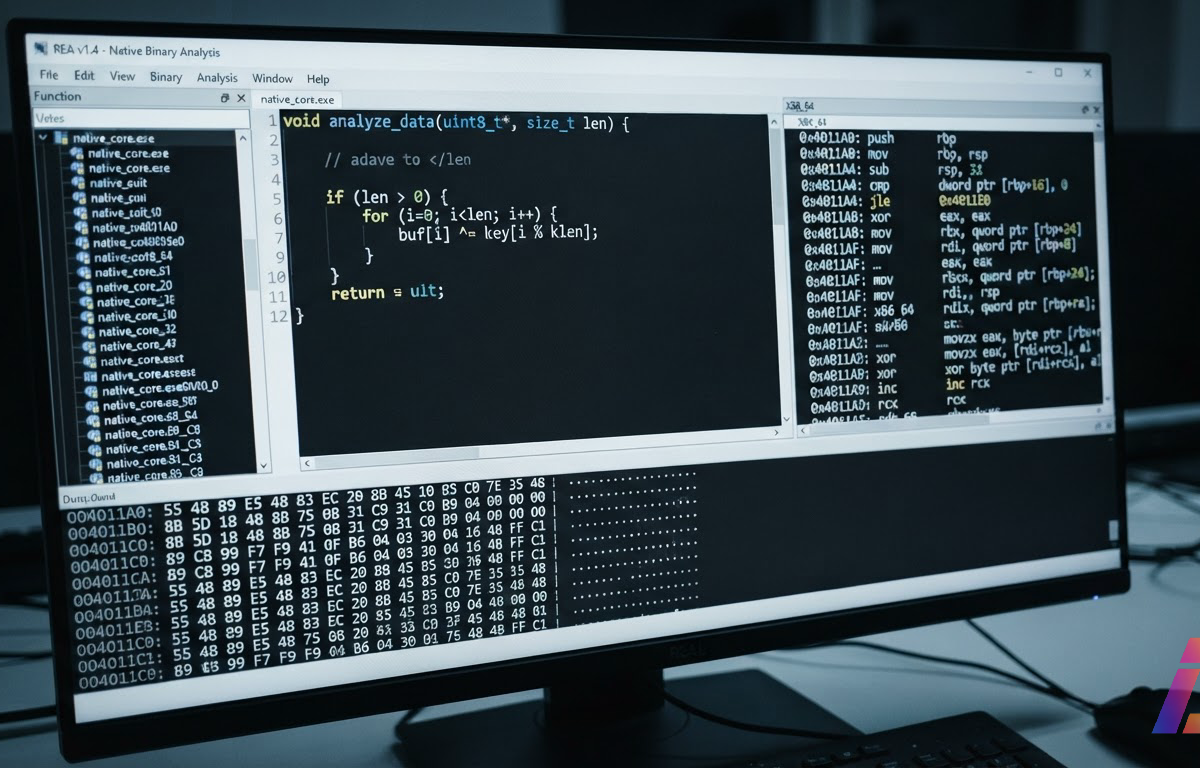
Qualquer ferramenta que prometa "reverter engenharia de qualquer coisa com agentes" merece duas reações simultâneas: interesse legítimo e desconfiança profissional. O REA (abre em nova aba) é exatamente isso — um servidor MCP que dá ao seu agente de código a capacidade de inspecionar binários nativos, apps JavaScript e Electron e páginas de navegador, devolvendo assembly, pseudocódigo, módulos e localizações de fonte. A pergunta que importa não é se ele funciona, mas se o ciclo de instalação, atualização e diagnóstico é confiável o suficiente para entrar numa rotina de trabalho. Minha leitura da documentação oficial sugere que sim, com ressalvas que o próprio projeto admite — e essa honestidade é o argumento mais forte a favor dele.
O que é e quem mantém
REA é distribuído como o pacote npm rea-agents, sob licença MIT, mantido no repositório morluto/rea (abre em nova aba) no GitHub. A descrição do repositório resume a proposta: engenharia reversa com agentes, do comportamento do aplicativo até binários nativos. O projeto é recente — o registro de licença aponta commit inicial em abril de 2026 — e ativo: 2.520 commits na branch principal e 35 tags até 12 de outubro de 2026. A versão vigente no npm é a 6.4.0, publicada a partir do commit a56f7bb6, conforme checagem de 11 de outubro de 2026 registrada na própria documentação de instalação.
O mecanismo central é MCP (Model Context Protocol): o setup registra uma conexão de servidor local e instala uma "skill" de investigação no seu agente. O agente passa a receber ferramentas que executam as análises na sua máquina e devolvem os resultados ao modelo.
Instalação: o que é exigido e o que é alterado
Os pré-requisitos documentados são específicos. O Node.js precisa estar em uma das faixas suportadas: 22.x (≥22.19), 24.x (≥24.11) ou 26+. As versões 23 e 25, e pré-lançamentos, são explicitamente não suportadas — o que elimina quem costuma rodar a última linha ímpar de desenvolvimento. A documentação recomenda o Node.js 24 LTS quando a versão instalada for mais antiga ou inexistente, com caminhos distintos por sistema: winget install OpenJS.NodeJS.LTS no Windows, Homebrew ou fnm no macOS, fnm no Linux (que exige curl e unzip). Um detalhe útil para quem usa Linux corporativo: a distribuição costuma empacotar um Node mais velho que 22.19.
O comando oficial é:
npx rea-agents@latest setupHá dois níveis de aprovação aqui, e a distinção importa. O npm pede confirmação para baixar o pacote; o setup do REA, separadamente, mostra um plano de alterações e pede aprovação antes de aplicá-lo. Ele mantém backup da configuração existente, mantém clientes recém-detectados desselecionados por padrão e fixa (pin) a versão exata do pacote no registro MCP do agente, além de definir startup_timeout_sec = 30 para Codex e Grok Build. Depois, reinicie o agente — o FAQ deixa claro que não adianta continuar sem isso.
Para uso sem agente, existe o caminho CLI puro: npx -y rea-agents@latest analyze-javascript-application /caminho/absoluto/do/app --json, para um diretório extraído ou um arquivo .asar. Instalação permanente: npm install --global rea-agents, que também expõe o comando rea.
Análise nativa: a parte que depende de terceiros
Análise de JavaScript e .NET funciona com os arquivos fornecidos, sem motor externo. Análise nativa profunda não: exige um de três provedores. O Ghidra (abre em nova aba) precisa ser versão 12.1.x (ponte verificada com 12.1.4) mais JDK 64 bits 21+ em Linux ou macOS, com GHIDRA_INSTALL_DIR e JAVA_HOME configurados — e o setup do REA nunca instala Ghidra, Java ou Python por você. O Hopper roda em macOS ou Linux; o setup detecta instalação existente ou propõe uma. O IDA tem configurações verificadas no Windows, com registro MCP pré-existente; análise headless em Linux e macOS permanece sem verificação.
O Windows é o ponto fraco documentado: o suporte nativo é experimental, somente leitura, restrito a aplicações x86 e x64 PE e DLLs em volumes NTFS locais fixos. Hopper não pode ser instalado lá. O baseline de hosts nativos suportados também é específico: macOS 12+, Ubuntu 24.04+, Fedora 41+, Nobara 44+, ou Arch de 64 bits e derivados (CachyOS, Omarchy). Ubuntu 20.04 ou CentOS velho, fora.
Atualização: o pin é o conceito-chave
O FAQ registra que o REA lança com frequência, incluindo correções de bugs. O fluxo depende de como você instalou. Com CLI global via npm: rea update, seguido do comando de refresh do setup que o próprio update imprime. Com setup via npx: rodar npx rea-agents@latest setup de novo, revisar as mudanças e reiniciar o agente. A razão técnica é o pin: o registro MCP aponta para uma versão exata, então só o refresh do setup faz o agente usar o novo release. Para comandos pontuais, npx -y rea-agents@latest resolve.
Há limitações de escopo que a documentação explicita sem rodeios: rea update atualiza apenas a instalação global npm ou Bun que está executando o CLI — checkouts de código-fonte e cópias via package-runner precisam do mecanismo que os gerencia. Atualizações globais via Bun exigem Bun 1.2.17 ou mais recente. E existe uma janela de defasagem entre main e npm: o cliente DeepSeek Harness (dsh) está na branch principal mas não no npm 6.4.0; rea setup --client dsh contra @latest retorna cliente não suportado até um release publicá-lo. Isso não é inconsistência de documentação, é um fato operacional que evita uma hora de debug errado.
Os 17 IDs de cliente aceitos no release atual incluem os habituais, Claude Code, Claude Desktop, Codex, Cursor, Gemini CLI, Windsurf, VS Code, GitHub Copilot CLI, Devin, e outros menos óbvios, como Qwen Code, Pi e Hermes.
Troubleshooting: o diagnóstico existe e é barato
O problema recorrente mais bem documentado é o agente não ver as ferramentas do REA. A sequência oficial: reiniciar ou reconectar o agente após o setup; checar o registro com doctor; se o registro estiver faltando ou obsoleto, reexecutar o setup para aquele cliente específico.
npx -y rea-agents@latest doctor --client codex --json
npx rea-agents@latest setup --client codex
doctor lê pré-requisitos do host e a configuração do agente sem alterar nada, é um verificador, não um reparador. Substitua codex pelo ID do seu cliente (claude_code, cursor, etc.). Se o registro estiver saudável e as ferramentas continuarem ausentes, o problema está na conexão MCP do cliente, e aí o log é do cliente, não do REA.
Outro caso conhecido: o Hopper precisa ser iniciado manualmente? Não, o REA o inicia quando a operação exige, mas no macOS a escolha de primeira execução entre modo demo ou ativação de licença precisa ser completada antes de análises não assistidas. E o protocolo de bug é o ciclo esperado: atualizar, reiniciar, repetir a mesma tarefa; persistindo, abrir issue com versão do REA, sistema operacional, tipo de alvo, passos de reprodução e saída de erro, incluindo o provedor quando envolver análise nativa.
Minha opinião: o que vale e o que guardar
Opinião agora, marcada como tal: o que me convenceu não é a lista de alvos suportados, é a precisão com que o projeto delimita o que não suporta. Documentação que diz "experimental, read-only, apenas PE em NTFS local fixo" e "dsh não está no npm ainda" está confiando na capacidade do leitor técnico de decidir. Isso é raro. Ferramentas novas costumam esconder limitações atrás de marketing; aqui, a maior fraqueza (Windows nativo) está no primeiro parágrafo do guia de instalação.
A ressalva que faço é sobre maturidade e conformidade. Engenharia reversa tem uses legítimos, auditoria de software que você licenciou, análise de malware, recuperação de código próprio sem fonte, como os case studies de DX-Ball e um flag checker de CTF sugerem, mas o contrato de licença do software alvo e a legislação aplicável ao seu caso continuam sendo sua responsabilidade, não da ferramenta. Uma ferramenta que torna a reversão fácil não torna a reversão autorizada. Quem usa em ambiente corporativo deveria tratar isso como qualquer outra ferramenta de análise: política escrita, alvos definidos, e o fato de que a análise é local, o REA não envia seu aplicativo, embora a política de dados do provedor do modelo do seu agente se aplique aos resultados. Essa segunda parte merece leitura no contrato do provedor antes de analisar algo sensível.
A questão de disponibilidade e documentação em português: não há evidência de versão localizada ou precificação no material público que examinei, o site não declara preço. Para o público que este texto endereça, isso importa menos do que parece: a documentação técnica em inglês é o padrão de facto, e a licença MIT do pacote elimina custo de licença da ferramenta em si. Custo real está nos provedores nativos com licença comercial, como o Hopper e o IDA, o Ghidra é a rota gratuita.
Minha recomendação prática: trate o REA como uma infraestrutura de análise com ciclo próprio de vida. Instale em faixa LTS suportada, aceite o setup com olho no plano, rode doctor antes de culpar o agente, e mantenha o hábito de atualizar e reiniciar antes de abrir bug. O fluxo é bem documentado porque o projeto sabe que a configuração multiagente é onde tudo costuma quebrar, e preferiu investir em diagnóstico do que em promessa.
Perguntas frequentes
Qual é a versão vigente do REA e de onde vem?
A 6.4.0 no npm, publicada do commit a56f7bb6, conforme checagem de 11 de outubro de 2026 documentada pelo próprio projeto. O projeto lança com frequência, então verifique o registro antes de fixar versão.
Preciso do Ghidra, Hopper ou IDA para usar o REA?
Só para análise nativa profunda. Análise estática de JavaScript, Electron e .NET funciona com os arquivos fornecidos, sem motor externo.
O agente não vê as ferramentas do REA. O que faço?
Reinicie o agente após o setup, rode doctor com o ID do seu cliente para checar o registro e, se estiver faltando ou obsoleto, reexecute o setup para aquele cliente. Se o registro estiver saudável, o problema é o erro de conexão MCP do próprio cliente.
O REA envia meu aplicativo para servidores externos?
Não. A análise roda na sua máquina; seu agente recebe os resultados, e a política de dados do provedor do modelo do seu agente se aplica a esses resultados.