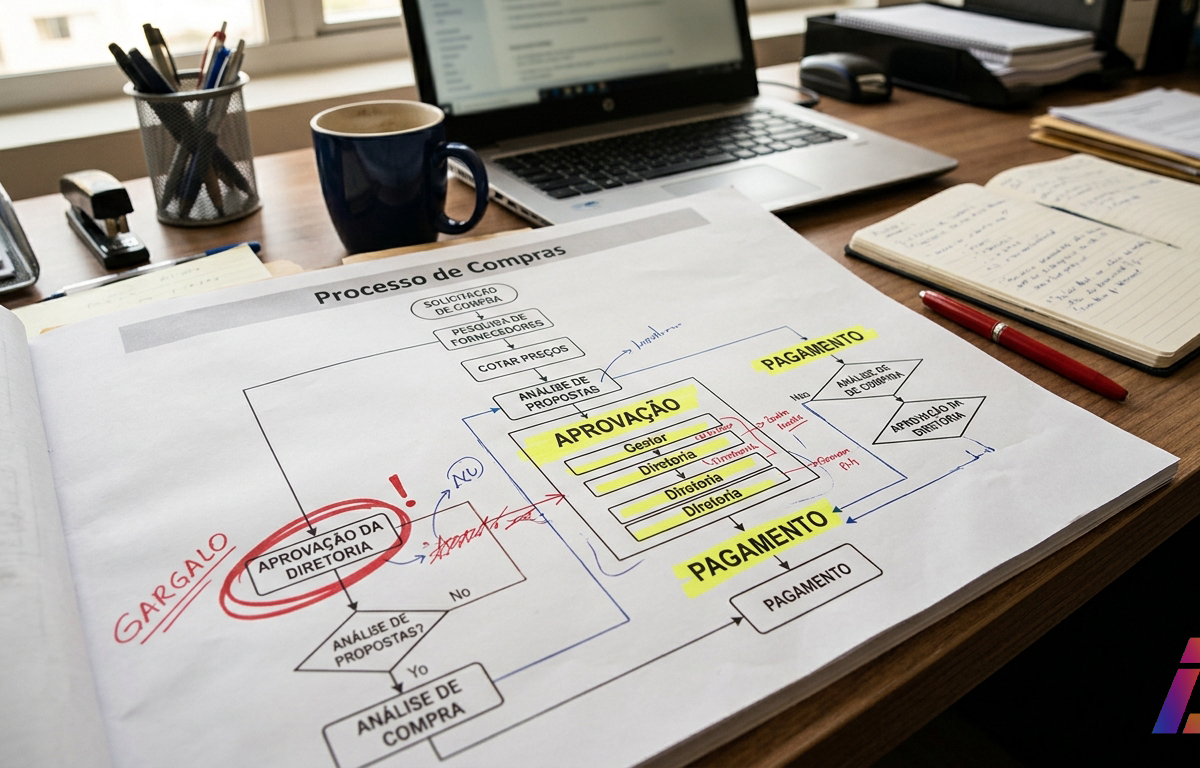
Por que um agente de IA que responde perguntas difíceis com eloquência ainda atrapalha um processo de compras? A pergunta atravessa quase toda empresa que já tentou levar LLMs do piloto para a operação, e a resposta que vem ganhando tração entre fornecedores e arquitetos tem nome: Process Intelligence. Não se trata de mais uma camada de automação, mas de dar ao agente aquilo que o ser humano novo na empresa leva meses para construir: um modelo mental de como o negócio realmente funciona, com seus desvios, gargalos e exceções.
O problema de contexto antes da solução
Agentes de IA corporativos dependem de três recursos: um modelo com capacidade de raciocínio, ferramentas para agir (APIs, sistemas legados, e-mail, tickets) e contexto suficiente para decidir o que fazer e quando. Os dois primeiros problemas têm receituário relativamente maduro; o terceiro é onde projetos empacam. A janela de contexto de um LLM não é uma representação da operação: é espaço de tokens. Encher esse espaço com dumps de tabelas, políticas internas e logs de ERP produz um agente que sabe muito sobre dados isolados e nada sobre o fluxo real que conecta o pedido, a aprovação, o pagamento e a exceção que ninguém documentou.
Process Intelligence ataca exatamente esse vão. O conceito evoluiu do process mining, disciplina que reconstrói processos reais a partir de logs de eventos de sistemas como SAP, Salesforce e ServiceNow. A diferença é de escopo e de produto: o process mining clássico era analítico, orientado a diagnóstico humano; a Process Intelligence contemporânea se apresenta como infraestrutura de contexto para sistemas autônomos, com dados enriquecidos de conhecimento de negócio e estruturados para consumo por máquinas. É a diferença entre um relatório sobre o processo e um grafo consultável que o agente usa para agir.
Alex Rinke, cofundador e co-CEO da Celonis (abre em nova aba), resumiu o diagnóstico na apresentação de uma suíte voltada a agentes: LLMs impressionam, mas as empresas lutam para extrair deles impacto concreto; agentes automatizam tarefas, mas falta-lhes entendimento de negócio para fazê-lo bem. A frase é comercial, evidentemente, mas o problema que ela descreve é reconhecível em qualquer implementação séria.
Como o contexto operacional é construído na prática
Do lado técnico, o pipeline tem etapas bem definidas. Primeiro, conectores extraem dados operacionais brutos de sistemas, aplicações e dispositivos dentro e entre empresas. A plataforma da Celonis, segundo a própria empresa, suporta mais de mil conectores. Em seguida, os dados de evento são alinhados a um modelo de processo, com timestamps, atores e objetos de negócio. Sobre essa base, aplicam-se camadas de semântica: mapeamentos de variantes, KPIs de processo, regras de conformidade, e o conhecimento tácito de quem opera o processo dia a dia.
O resultado que a Celonis chama de Process Intelligence Graph: um gêmeo digital vivo da operação, que combina os dados de processo com contexto de negócio. A metáfora de "gêmeo digital" é discutível quando aplicada a algo tão dinâmico quanto um processo, mas a arquitetura é concreta: um grafo consultável, mantido sobre os dados de origem, que expõe o estado e a história dos fluxos de trabalho. É essa estrutura, e não um prompt, que serve de fonte de verdade para o agente decidir.
A última etapa é a interface com os agentes. Historicamente seria uma API; a fronteira atual é o Model Context Protocol (MCP), padrão aberto que padroniza como ferramentas expõem contexto e ações a modelos. Em novembro de 2025, no evento Celosphere, a Celonis anunciou um servidor MCP construído especificamente para Process Intelligence, que alimenta agentes com o contexto operacional dinâmico necessário para decisões e ações. Para quem constrói agentes, a implicação é direta: em vez de escrever integrações ad hoc entre o LLM e cada sistema de origem, consome-se um servidor MCP que já encapsula a semântica do processo.
AgentC e o ecossistema de agentes
A ponte entre o grafo e os agentes tem nome próprio na Celonis: AgentC, suíte de ferramentas, integrações e parcerias lançada em outubro de 2024. A proposta é que agentes desenvolvidos nas plataformas de IA dominantes recebam o contexto da Process Intelligence, e que agentes pré-construídos por parceiros também sejam alimentados por ela. As integrações iniciais incluem Microsoft Copilot Studio, IBM watsonx Orchestrate, Amazon Bedrock Agents e ambientes de desenvolvimento open source como CrewAI.
Seis meses depois, a Celonis estendeu a API de Process Intelligence para compartilhar de forma mais segura contexto, métricas e ações recomendadas com plataformas como Microsoft Copilot Studio, Amazon Bedrock e Salesforce Agentforce. Em novembro de 2025, o anúncio seguinte adicionou peças de infraestrutura: o Celonis Data Core, com integrações zero-copy bidirecionais para data lakes, disponível para Databricks além de Microsoft, e o Orchestration Engine, tornado disponível como capacidade central da plataforma, agora estendido para coordenar agentes de IA junto a pessoas e sistemas. Segundo a empresa, clientes poderão alimentar a inteligência da plataforma de volta ao Databricks e criar agentes em produção otimizados com seus próprios dados operacionais.
Daniel Brown, chief product officer da Celonis, descreveu a sequência necessária para operacionalizar IA: identificar os casos de uso corretos, redesenhar os processos e orquestrar os agentes junto a pessoas e sistemas existentes. A ordem importa, porque inverte a lógica que a gente costuma ver em projetos de IA: primeiro o processo, depois o agente, nunca o contrário.
Onde isso já aparece
Casos citados pela Celonis incluem a Mercedes-Benz Group, que implementou agentes para acelerar decisões e melhorar prazos de entrega, e a Vinmar International, que afirma ter transformado seu processo de cash-to-order em operação totalmente automatizada. É preciso cuidado interpretativo aqui: são relatos de clientes divulgados pelo próprio fornecedor, sem metodologia de verificação publicada. Servem como sinal de maturidade da abordagem, não como evidência de resultado médio.
Há, porém, uma lógica técnica independente do marketing. Um agente de contas a pagar com acesso a um grafo que mostra quais faturas seguiram qual variante, onde os atrasos se concentram e qual é o próximo passo esperado decide melhor do que um agente com acesso apenas ao banco de dados do ERP. O grafo responde perguntas que nenhum schema relacional responde de forma natural: qual é o caminho típico, qual é o desvio, onde este caso específico está parado e o que normalmente acontece depois.
Limitações e trabalho sujo
Nenhum grafo se sustenta sem governança de dados, e é aí que a adoção real trava. Logs de eventos precisam de identificação de casos, correlação entre sistemas e tratamento de lacunas; processos cruzando departamentos raramente compartilham chaves. A promessa zero-copy reduz duplicação e custo, mas não elimina o trabalho de modelagem semântica, que é contínuo: processos mudam, sistemas mudam, e o grafo precisa acompanhar, ou o agente passa a agir sobre um mapa desatualizado com a confiança de quem tem um mapa perfeitamente válido em 2023.
Há também o risco estrutural de enrijecimento. Se o contexto do agente vem de uma representação do processo como ele é, o agente tende a otimizar o status quo; a melhoria depende de uma camada de análise que identifique onde o processo deveria ser diferente. E a questão arquitetural mais incômoda para equipes técnicas: acoplamento. Quanto mais o agente depende de uma plataforma proprietária para contexto, mais difícil é portá-lo. O MCP mitiga parte disso ao padronizar o protocolo de consumo, mas a semântica por trás do servidor continua sendo do fornecedor.
Para o desenvolvedor, o trabalho prático se concentra em três frentes: garantir a qualidade dos dados de evento que alimentam o pipeline, desenhar as ferramentas expostas via MCP com permissões e limites claros, e definir métricas de avaliação do agente que reflitam resultado de processo (tempo de ciclo, taxa de exceção) e não apenas corretude de resposta. A última é a que costuma ser esquecida, e é a que o CFO pergunta.
Uma infraestrutura em disputa
A corrida não é só da Celonis. A UiPath (abre em nova aba) reposicionou sua plataforma de automação em torno de agentic orchestration, e o próprio Microsoft Copilot Studio ocupa terreno vizinho ao integrar contexto corporativo a agentes. O que está em disputa é uma posição de infraestrutura: quem fornece a camada de entendimento de processos sobre a qual os agentes operam. O argumento da Celonis é que essa camada precisa nascer de dados de processo reais, e não de documentação aspiracional.
Se o argumento se sustenta, a consequência para arquiteturas corporativas é significativa: a integração de agentes deixa de ser um problema de prompt engineering e passa a ser um problema de modelagem de dados operacionais. Menos glamouroso, certamente, mas é nele que a produção acontece.
Voltemos ao agente eloquente do início. Ele não atrapalhava o processo de compras por falta de capacidade, e sim por falta de mapa: respondia com confiança sobre um território que não conhecia. Process Intelligence é, antes de qualquer hype, uma tentativa de resolver exatamente isso, e a parte difícil continua sendo a de sempre: não o modelo, mas os dados e a semântica que o sustentam.