Como muda a rotina de quem desenvolve software para laboratórios quando a triagem de milhões de registros biológicos deixa de exigir semanas de processamento manual e passa a rodar em meia hora? O impacto prático já tem registro documentado. Milhares de agentes autônomos (instâncias de modelos de linguagem programadas para executar subtarefas em paralelo) analisaram dados experimentais de milhões de células cerebrais de camundongos em exatos 32 minutos. O sistema cruzou os efeitos de disrupções genéticas com a literatura acadêmica existente para apontar mecanismos biológicos testáveis em bancada. Esse experimento, conduzido em parceria com a PerturbAI e o instituto Scripps Research a partir do modelo especializado GPT-Rosalind, é uma das vitrines técnicas do blog voltado à ciência lançado pela OpenAI (abre em nova aba) em 15 de novembro de 2026.
Trinta e dois minutos para varrer milhões de células com milhares de agentes simultâneos é um número que faz qualquer engenheiro de dados parar para calcular o custo de inferência e a arquitetura de orquestração. A publicação oficial não detalha a topologia de rede nem o consumo de tokens dessa operação, restringindo-se ao relato do resultado alcançado com os parceiros. Para desenvolvedores e profissionais técnicos que constroem ferramentas de pesquisa, o anúncio desse canal importa menos pela divulgação institucional e mais pelo tipo de documentação que começa a se consolidar nos grandes laboratórios de inteligência artificial: guias de implementação, arquitetura de verificação e o mapeamento explícito de onde os modelos falham.
O que o novo canal documenta na prática
A proposta declarada pela empresa busca acelerar descobertas científicas como parte de sua meta de desenvolver a AGI (Inteligência Geral Artificial, conceito que define sistemas capazes de igualar ou superar a capacidade cognitiva humana em múltiplas disciplinas). Na prática diária de engenharia, o blog foi dividido em três frentes de publicação: resultados de pesquisa inéditos, relatos da comunidade acadêmica e uma seção dedicada a métodos e orientações práticas.
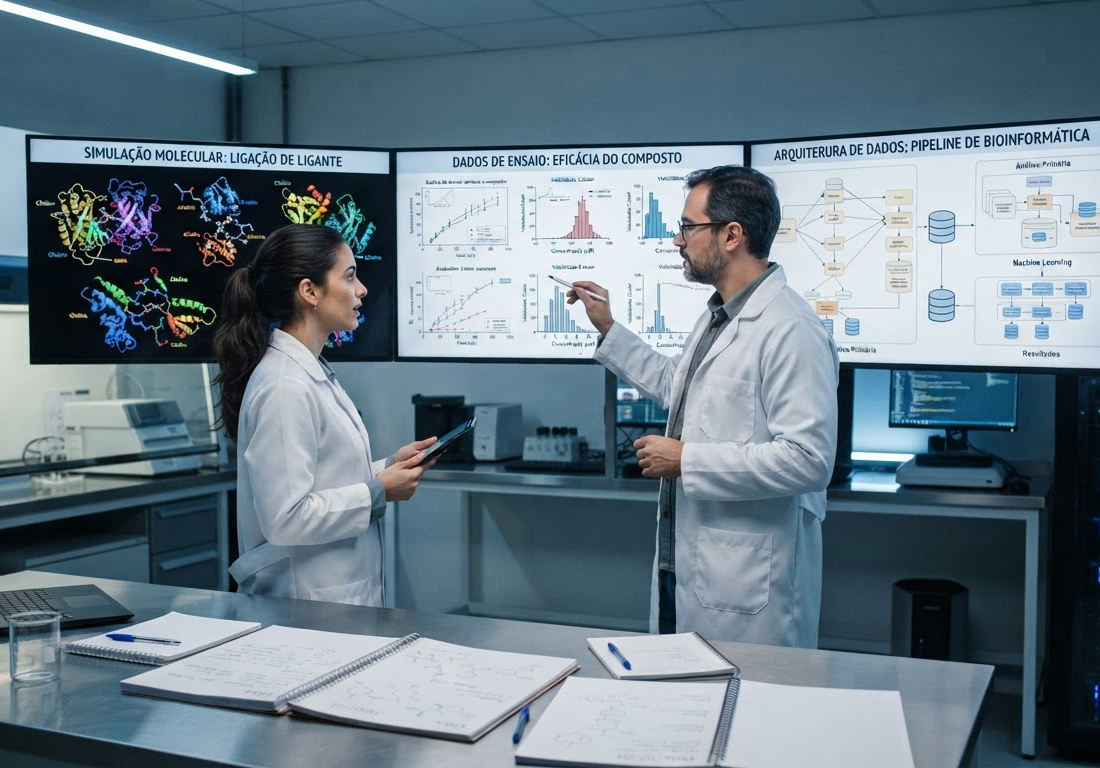
É nessa frente metodológica que mora o interesse imediato para quem escreve código ou desenha pipelines de dados. A documentação promete abrir exemplos adaptáveis de uso dos modelos em quatro tarefas centrais: computação científica, análise de dados, exploração de literatura e planejamento de experimentos. Dois compromissos editoriais chamam a atenção pela utilidade técnica: mostrar como auditar o trabalho gerado pela máquina e expor os pontos em que cada método não funciona.
Por que criar um blog próprio agora em vez de concentrar tudo em artigos submetidos a periódicos tradicionais? Duas explicações continuam plausíveis diante do material publicado. Uma delas é a inadequação do formato de paper acadêmico para ensinar engenharia de fluxo de trabalho: detalhes sobre encadeamento de agentes, refatoração assistida e contornos de falhas cabem melhor em tutoriais técnicos de publicação rápida. Outra leitura possível é a necessidade de estabelecer um canal direto de validação com cientistas num momento em que os laboratórios divulgam resultados teóricos pesados produzidos por sistemas proprietários que a comunidade externa ainda precisa escrutinar.
Os marcos listados pela empresa entre setembro e outubro de 2026 ilustram o peso dessas alegações:
- Equações de dinâmica de fluidos (setembro de 2026): Segundo a empresa, um sistema interno produziu uma prova matemática voltada ao problema de existência e suavidade de Navier-Stokes (um conjunto de equações diferenciais parciais que descrevem o movimento de fluidos, cuja resolução formal completa é um dos desafios abertos mais antigos da matemática).
- Teoria dos números no GitHub (início de outubro de 2026): Liberação de um pacote de resultados matemáticos, incluindo um artigo datado de 30 de setembro de 2026 no repositório de matemática da OpenAI no GitHub (abre em nova aba) sobre a hipótese quase-Riemann (uma variação da clássica hipótese de Riemann na teoria analítica dos números). O documento apresenta um limite mais estrito para a margem de erro na fórmula clássica que estima a quantidade de números primos abaixo de um valor dado.
- Física e limites computacionais (final de outubro de 2026): Publicação de resultados conjuntos com comunidades acadêmicas abrangendo matemática, ciência da computação e física. Os trabalhos tratam da concentração de ondas, dos limites da computação eficiente e dos fundamentos matemáticos da teoria quântica de campos em interação (arcabouço teórico que estuda o comportamento de partículas subatômicas e forças fundamentais).
- Automação em biologia: Ao lado do processamento em massa com o GPT-Rosalind, o anúncio registra que equipes independentes estão montando suas próprias arquiteturas, como o grupo do pesquisador César de la Fuente, que combina o ChatGPT e o Codex (modelo voltado à geração e interpretação de código de programação) em seus fluxos de pesquisa biológica.
Da execução ao gerenciamento: o gargalo técnico mudou de lugar
A iniciativa de novembro de 2026 não é um movimento isolado no ecossistema de desenvolvimento. O formato reflete uma mudança estrutural na rotina técnica dos laboratórios que já vinha sendo documentada por outras instituições ao longo do ano. Em agosto de 2026, o Centro Europeu de Previsões Meteorológicas de Médio Prazo (ECMWF (abre em nova aba)) detalhou em seu próprio blog científico a criação de um assistente de IA para o IFS (Integrated Forecasting System, seu sistema operacional de previsão meteorológica), conectando bases de código complexas, documentação técnica e fluxos de execução por meio de consultas em linguagem natural.
Meses antes, em 23 de março de 2026, a Anthropic (abre em nova aba) havia inaugurado um canal com escopo quase idêntico, focado em guias de fluxo de trabalho (workflows), notas de campo e orquestração de tarefas de longa duração para computação científica. A convergência entre os dois laboratórios expõe o que está acontecendo na bancada do desenvolvedor e do cientista. Os computadores tradicionais assumiram o trabalho bruto do cálculo numérico décadas atrás; os modelos atuais estão assumindo etapas da estruturação cognitiva.
O pesquisador dispara a bateria de agentes. Os agentes cruzam mutações celulares com artigos publicados. Trinta e dois minutos depois, saem as hipóteses para o laboratório. Quem garante que o cruzamento faz sentido biológico?
O gargalo do trabalho técnico deslocou-se da execução para o gerenciamento e a auditoria. Análises computacionais que antes exigiam equipes inteiras dedicadas à escrita de scripts agora rodam sob o comando de um único profissional supervisionando modelos, como no relato documentado pelo físico Matthew Schwartz ao guiar o modelo Claude por um cálculo real de física teórica. Só que essa supervisão está longe de ser passiva.
Que modelos generativos inventam referências se não forem vigiados, qualquer desenvolvedor acostumado a integrar APIs já sabe de cor; a questão mal resolvida é como auditar a saída quando o sistema gera uma prova matemática extensa ou cruza milhões de linhas de expressão gênica em poucos minutos. Um errinho silencioso na premissa de um prompt contamina toda a cadeia de inferência subsequente se o modelo for programado para validar a expectativa do pesquisador. Como resumiu o matemático e medalhista Fields Timothy Gowers, em citação destacada pela Anthropic, a pesquisa entrou em um período em que o trabalho é fortemente acelerado pela IA, mas a ferramenta ainda depende da supervisão humana direta.
Como estruturar e auditar um fluxo de pesquisa assistido por IA
Se você precisa desenhar uma aplicação ou pipeline para apoiar pesquisadores na sua instituição ou empresa, não basta conectar uma interface de chat aos dados do laboratório. É necessário traduzir as categorias de uso e os alertas de falha documentados pelos laboratórios de IA em camadas de engenharia de software.
A comparação abaixo organiza as quatro frentes práticas descritas pela OpenAI com os mecanismos de contenção exigidos pelas falhas reportadas na literatura técnica dos próprios fornecedores:
| Tarefa científica documentada | Papel do modelo ou dos agentes | Risco principal identificado | Contorno de engenharia na aplicação |
|---|---|---|---|
| Computação científica | Geração de scripts (via modelos como Codex) e orquestração de tarefas longas. | Travamento em passos triviais ou código sintaticamente válido, mas matematicamente incorreto. | Isolamento em ambientes de execução (sandboxes) com testes unitários determinísticos baseados em soluções conhecidas. |
| Análise de dados complexos | Paralelização com múltiplos agentes (ex.: padrão usado com GPT-Rosalind em dados celulares). | Alucinação na agregação estatística ou extrapolação sem base nos dados brutos. | Separação entre agentes que escrevem consultas de extração e o motor de cálculo real; o modelo nunca deve calcular no texto. |
| Exploração de literatura | Conexão entre achados experimentais e artigos publicados em diferentes áreas. | Citações fabricadas ou associações forçadas entre fenômenos sem relação causal. | Verificação automatizada de identificadores reais e exigência de extração literal do trecho que sustenta a hipótese. |
| Planejamento de experimentos | Formulação de hipóteses testáveis e desenho de etapas de validação para o laboratório. | Bajulação (sycophancy): o modelo valida uma hipótese falha apenas porque o pesquisador a sugeriu no prompt. | Uso de prompts adversariais cegos, instruindo uma instância separada a encontrar falhas metodológicas na proposta sem saber quem é o autor. |
Para colocar essa estrutura em produção ao adaptar os métodos que passam a ser publicados nesses novos blogs científicos, utilize o roteiro de verificação técnica a seguir antes de liberar o fluxo para uso em pesquisa real:
Arquitetura de verificação para fluxos científicos com IA
- Desacople a orquestração do processamento numérico
Em análises volumosas (como datasets biológicos ou climáticos), use os agentes apenas para estruturar hipóteses, navegar na documentação (padrão adotado pelo ECMWF no sistema IFS) e gerar scripts de consulta. Todo cálculo estatístico deve ser executado por bibliotecas determinísticas externas, nunca pela geração de tokens do modelo.
- Implemente revisão adversarial contra bajulação (sycophancy)
Nunca valide uma prova matemática ou hipótese experimental na mesma sessão de contexto em que ela foi gerada. Crie uma etapa automatizada na qual um agente independente receba apenas o resultado final com a instrução estrita de tentar refutá-lo ou encontrar contraexemplos triviais.
- Rastreie a proveniência entre dado experimental e literatura
Ao conectar resultados de bancada com artigos científicos, exija que o pipeline salve o identificador exato do registro experimental ao lado do trecho literal do artigo consultado. Se a conexão depender de inferência do modelo sem citação direta, marque o resultado na interface como hipótese não verificada.
- Documente os limites de falha do método no próprio repositório
Seguindo a diretriz editorial estabelecida pela OpenAI para seus guias práticos, mantenha junto ao código do pipeline um registro dos casos em que o modelo falha ou entra em loop, evitando que outros pesquisadores da equipe apliquem a ferramenta fora do domínio validado.
A abertura de canais dedicados à ciência pela OpenAI e pela Anthropic consolida a transição dos modelos de linguagem de simples assistentes de texto para componentes de infraestrutura nos laboratórios. Acompanhar essas publicações com olhar de engenharia significa extrair os padrões de orquestração multiagente e os repositórios de código aberto disponibilizados, mantendo uma camada rigorosa de validação determinística entre a sugestão gerada pela máquina e o experimento físico na bancada.