"Proponho considerar a questão: 'As máquinas podem pensar?'" Com essa linha, publicada em outubro de 1950 na revista filosófica britânica Mind, o matemático Alan Turing abriu o artigo Computing Machinery and Intelligence e logo descartou a própria pergunta. Definir os termos "máquina" e "pensar" pelo uso comum exigiria algo equivalente a uma pesquisa estatística de opinião, como uma enquete Gallup, procedimento que Turing classificou como absurdo. Para desenvolvedores e pesquisadores que hoje avaliam grandes modelos de linguagem (LLMs, na sigla em inglês para Large Language Models, sistemas de inteligência artificial treinados em vastos volumes de dados para processar e gerar texto), o impasse de 1950 permanece familiar: existe uma dificuldade extrema em criar um critério objetivo capaz de separar pensamento original de uma repetição de papagaio (parroting) suficientemente sofisticada, já que qualquer comportamento do software pode ser descartado sob o argumento de que foi programado.
Turing contornou o debate semântico trocando a definição filosófica por um protocolo de avaliação empírica e comportamental, chamado por ele de jogo da imitação (imitation game). Se não há consenso sobre o que acontece dentro da caixa, mede-se a saída da caixa em uma interação cega. Como descreveu o cientista da computação Scott Aaronson em artigo citado pela revista Science (abre em nova aba), a proposta funciona como "um apelo contra o chauvinismo da carne": se um sistema digital age, reage e conversa de forma indistinguível de uma pessoa quando isolado de suas características físicas, a recusa em reconhecer ali uma atividade equivalente ao pensar perde sua base prática.
Como funciona a arquitetura original do jogo da imitação
A versão popular do Teste de Turing costuma ser resumida como um bate-papo simples entre um juiz humano e um computador. O desenho publicado nas páginas 433 a 460 do volume 59 da revista Mind é, na verdade, um experimento de três pontas com isolamento estrito de interface e grupo de controle embutido.
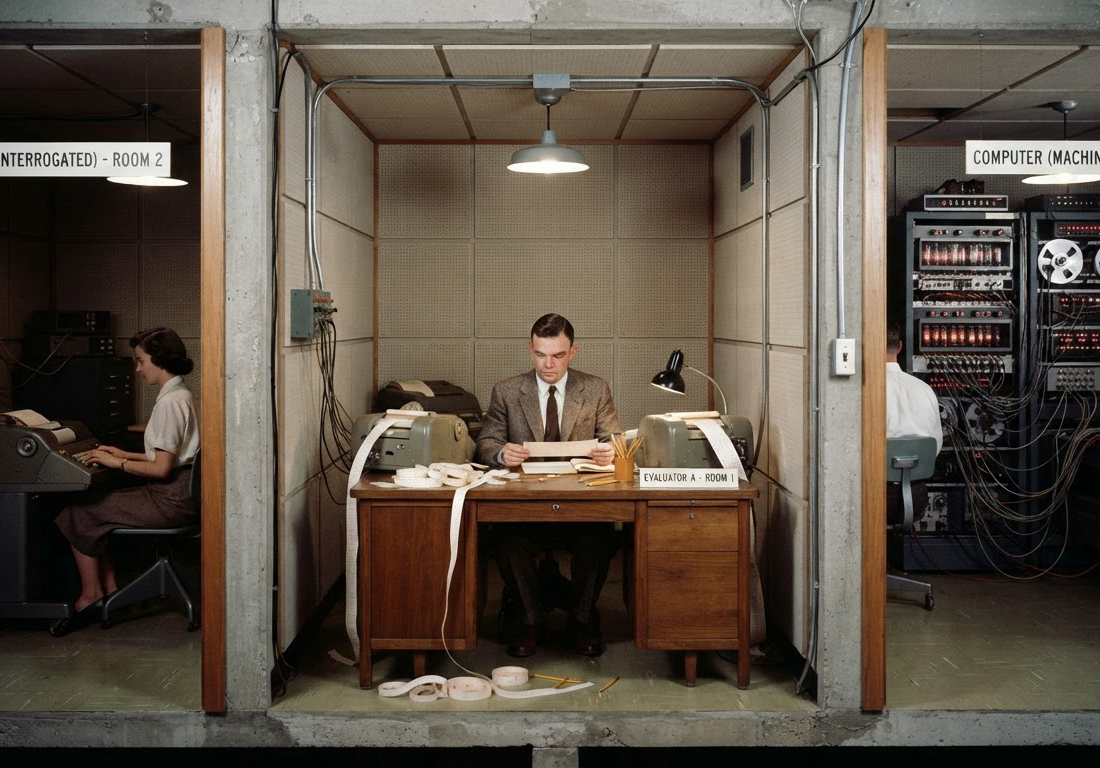
Na configuração de base proposta por Turing, três participantes ficam em salas separadas: um homem (Jogador A), uma mulher (Jogador B) e um interrogador (Jogador C), que pode ser de qualquer sexo. O interrogador C envia perguntas escritas a A e B, idealmente por meio de um teleimpressor (teleprinter, dispositivo eletromecânico usado para transmitir e receber mensagens digitadas à distância), garantindo que o tom de voz, a aparência física e a caligrafia não vazem pistas sobre a identidade dos interlocutores. O canal importa. Nessa etapa, o objetivo do Jogador A é enganar o interrogador, enquanto o objetivo da Jogadora B é ajudar o interrogador a acertar quem é quem. Turing então propõe a substituição experimental: o que acontece quando um computador digital assume o papel do Jogador A? A métrica de sucesso não exige enganar todos os juízes o tempo todo, mas verificar se o interrogador C erra a identificação com a mesma frequência observada quando o jogo era disputado entre o homem e a mulher.
Um estudo metodológico publicado na revista Minds and Machines (abre em nova aba) demonstra que Turing formulou diversas questões empíricas ($Q'$ a $Q''''$) variando os pares nos papéis A e B (homem e mulher, máquina e mulher, máquina e máquina, máquina e homem, ou a máquina como A sem B) enquanto mantinha o interrogador C fixo. Na prática, essa divisão estabelece uma estrutura de caso-controle (case-control, método experimental que avalia um sujeito sob teste comparando-o diretamente a uma referência conhecida sob as mesmas condições): dentro de cada partida, o Jogador A atua como o caso experimental e o Jogador B atua como o controle humano (também chamado na literatura técnica de foil, ou contraste).
Segundo a análise da professora Diane Proudfoot na Open Encyclopedia of Cognitive Science (abre em nova aba) do MIT, o teste irrestrito especificado por Turing em 1950 apoia-se em regras lógicas e operacionais bem delimitadas que o diferenciam de benchmarks de tarefa única:
- **Conversação de domínio aberto (open domain conversation):** o interrogador pode perguntar sobre qualquer assunto na conversa, o que contrasta com testes aplicados a sistemas especialistas (expert systems, programas desenhados para resolver problemas em um domínio estreito, como emitir diagnósticos médicos a partir de exames laboratoriais).
- Critério comportamental cotidiano: se a máquina apresenta bom desempenho nas conversas simultâneas do jogo da imitação, considera-se que ela pensa no sentido cotidiano do termo.
- Condição suficiente, mas não necessária: Turing registrou que, se uma máquina falhar no jogo, não se pode deduzir logicamente que ela não pense, pois uma máquina inteligente pode simplesmente ser ruim em imitar humanos. Ter sucesso no teste é uma condição suficiente para atribuir pensamento, nunca uma condição necessária nem uma definição formal de inteligência.
Previsões divergentes e o impacto das variáveis de teste
Ao projetar quando o hardware atingiria esse patamar, o próprio autor deixou estimativas bem distintas em um intervalo de dois anos. No artigo de 1950, Turing previu que em cerca de cinquenta anos (por volta do ano 2000) seria possível programar computadores com capacidade de armazenamento de cerca de $10^9$ (um bilhão de unidades de memória) para jogar o jogo da imitação de modo que um interrogador médio não tivesse mais de 70% de chance de fazer a identificação correta após cinco minutos de perguntas. Em outras palavras, a máquina enganaria o juiz em cerca de 30% das rodadas. Também em 1950, ao responder à objeção histórica formulada por Ada Lovelace em 1843 (segundo a qual uma máquina só pode executar o que sabemos ordenar), Turing propôs que o caminho seria construir uma "máquina-criança" e submetê-la a um processo de aprendizado.
Já em 1952, conforme documentado na enciclopédia do MIT, Turing estimou que levaria pelo menos 100 anos para que uma máquina passasse em seu teste irrestrito.
A diferença entre bater uma meta estatística de cinco minutos e sustentar uma avaliação aberta explica por que os resultados experimentais das últimas décadas variam tanto conforme o desenho do protocolo. Quando o tempo de conversa, o perfil do juiz, o pareamento com um humano e as instruções dadas ao modelo (prompts) mudam, a taxa de aprovação oscila drasticamente.
| Evento ou Estudo | Configuração do Protocolo | Duração da Rodada | Critério ou Resultado Documentado |
|---|---|---|---|
| Previsão de Turing (1950) | 3 jogadores (computador A, humano B e interrogador C) para computador com $10^9$ unidades de memória | 5 minutos | Interrogador médio com no máximo 70% de acerto (máquina engana cerca de 30% das vezes) |
| Prêmio Loebner | Competição anual com juízes especialistas e mais tempo de conversa | Acima de 5 minutos | Exigia enganar pelo menos 50% dos juízes; nenhuma máquina passou em quase 30 anos de torneio |
| Universidade de Reading (2014) | Avaliação com o programa Eugene Goostman | Curta duração | Anunciado como aprovado ao enganar 33% dos juízes; criticado pelo uso de truques conversacionais |
| Estudo de 2024 (com 500 participantes) | Formulação de 2 jogadores (juiz conversa só com 1 interlocutor: humano, GPT-4 instruído via prompt ou ELIZA) | 5 minutos (rodada única) | Testou a identificação isolada sem o pareamento simultâneo com o controle humano na mesma conversa |
| Estudo de 2025 (com GPT-4.5) | Avaliação de conversação por texto com modelo de linguagem | Curta duração | Relatou que o modelo GPT-4.5 foi julgado como humano em 73% das vezes |
Os dados da tabela expõem como alterações na mecânica experimental produzem leituras opostas sobre o estado da tecnologia. Enquanto o Prêmio Loebner (Loebner Prize) operou por quase três décadas com juízes especializados sem que nenhum sistema atingisse a marca de 50% de engano, experimentos baseados na janela curta de cinco minutos geraram anúncios frequentes de superação desde 2014, intensificados após o lançamento do ChatGPT no final de 2022.
Como aplicar os princípios do teste na avaliação técnica de LLMs
Originalmente concebido como um experimento mental filosófico (thought experiment) e não como um padrão de laboratório com regras operacionais fixas, o jogo da imitação acabou servindo de base conceitual para avaliações humanas de sistemas conversacionais. Quando uma equipe de engenharia precisa validar a naturalidade de um assistente ou auditar um paper que alega desempenho humano, aplicar a estrutura de caso-controle de Turing evita distorções graves de medição.
O erro metodológico mais comum em testes internos de chatbots é adotar uma formulação de dois jogadores (na qual o avaliador conversa apenas com um sistema por vez e tenta adivinhar se é uma IA) ou seguir formulações puramente amostrais, como a de uma equipe de Stanford citada pela Science, que considera o teste superado se as respostas da IA não puderem ser distinguidas estatisticamente de respostas humanas selecionadas aleatoriamente. Sem a presença simultânea do controle humano (Jogador B) respondendo às mesmas provocações do interrogador na mesma janela temporal, o teste fica vulnerável ao chamado efeito ELIZA (ELIZA effect). Batizado em referência ao chatbot ELIZA criado na década de 1960, o fenômeno descreve a tendência psicológica humana de atribuir compreensão e empatia a qualquer interface de texto que devolva respostas minimamente articuladas, mesmo quando o código subjacente é rudimentar.
Para estruturar uma bateria de avaliação cega de conversação ou auditar resultados de modelos em ambientes técnicos, é possível traduzir as regras de 1950 em um protocolo de verificação direta:
Checklist para avaliação cega de conversação (Protocolo Caso-Controle)
- Pareamento simultâneo (3 participantes): garanta que cada avaliador (C) interaja em paralelo com o modelo sob teste (A) e com uma pessoa real atuando como controle (B), evitando julgamentos isolados de 2 jogadores.
- Isolamento de canal: padronize a interface de texto puro para ambos os interlocutores, igualando formatação e ocultando metadados para que apenas o conteúdo das respostas seja julgado.
- Escopo de domínio aberto: permita que o avaliador alterne livremente entre tópicos fora do escopo estreito de sistemas especialistas, testando a sustentação de contexto.
- Registro das instruções de sistema: documente integralmente o prompt utilizado no modelo (como instruções escritas por humanos para imitar hesitações ou estilo), pois o resultado mede o conjunto modelo + instrução.
- Definição prévia da janela de tempo: separe explicitamente testes de triagem rápida (como rodadas de 5 minutos, onde modelos já superam 70% de identificação como humanos) de sessões longas com avaliadores especialistas.
- Interpretação restrita ao comportamento: trate a taxa de erro do avaliador exclusivamente como métrica de imitação conversacional na superfície de texto, nunca como prova de compreensão semântica ou ausência de repetição estatística.
Perguntas frequentes
Passar no Teste de Turing significa que a inteligência artificial é consciente?
Não. O próprio Alan Turing não afirmou que a aprovação no jogo da imitação provaria consciência ou experiência interna. O teste observa estritamente o comportamento em uma conversa escrita, tratando um bom desempenho como condição suficiente para usar a palavra "pensar" no sentido cotidiano, sem medir o que ocorre dentro da máquina.
Qual a diferença entre o teste original de 1950 e os testes modernos com chatbots?
No artigo de 1950, Turing definiu um jogo de três participantes em que o juiz conversa simultaneamente com um computador e com um humano (que atua como grupo de controle) para decidir quem é quem. Muitos testes modernos, incluindo um estudo de 2024 com 500 participantes, reduzem o experimento para uma formulação de dois jogadores, na qual o juiz conversa com apenas um interlocutor por rodada de cinco minutos, alterando a linha de base comparativa.
Por que os resultados dos modelos variam tanto entre diferentes experimentos?
Porque o artigo original de Turing propôs um experimento mental sem fixar todos os parâmetros operacionais de laboratório. Na prática, a dificuldade de identificar o interlocutor artificial depende diretamente da duração da conversa, do nível de especialização dos juízes e das instruções (prompts) fornecidas ao modelo antes do início do diálogo.
Ao avaliar qualquer sistema conversacional ou ler novos estudos sobre modelos de linguagem, o profissional técnico deve inspecionar primeiro o tempo de interação, a instrução de sistema e a presença de um controle humano pareado antes de validar a métrica reportada.