
Plugins para agentes de código costumam competir em amplitude: mais contextos, mais ferramentas, mais coisas que o modelo consegue gerar sozinho. O Neckbeard (abre em nova aba), projeto open-source sob licença Apache-2.0, vai na direção oposta. Ele se apresenta como um plugin de DevOps, platform e SRE para agentes de IA, e o mecanismo escolhido é conter o agente: um catálogo fechado de módulos de infraestrutura, um plano determinístico e, no release mais recente, um teto de orçamento que faz o agente desistir em vez de provisionar. A documentação declara o projeto como pre-alpha, e esse dado é o melhor ponto de partida para qualquer avaliação.
A divisão do trabalho: humano mantém o catálogo, agente preenche lacunas
A arquitetura separa a tarefa em duas metades. A primeira é humana: manter um catálogo de módulos OpenTofu, versão open-source mantida pela comunidade do Terraform, ferramenta de infraestrutura como código (IaC, a prática de descrever infraestrutura em arquivos declarativos versionados). Cada módulo do catálogo é versionado, testado em CI a cada mudança e limitado a um único formato de workload: uma imagem de container, até dez processos do tipo HTTP, worker ou cron, Postgres, object storage e secrets. Nada além disso.
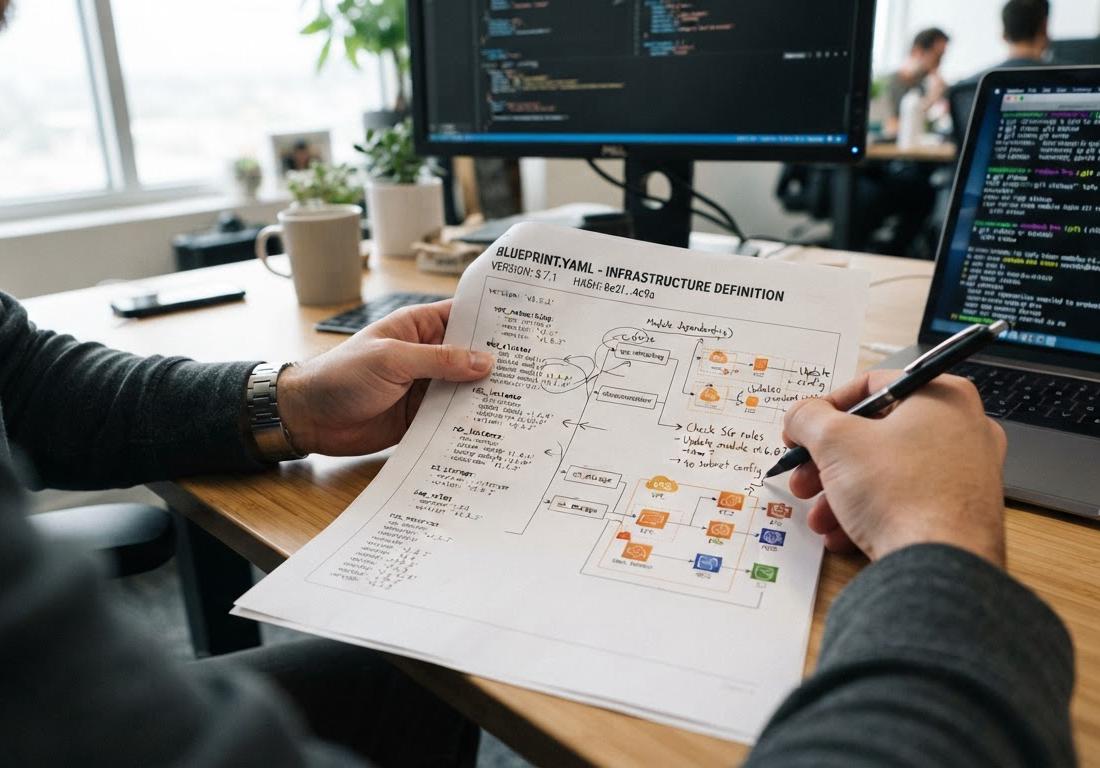
A segunda metade é do agente. Ele lê o repositório da aplicação, deduz o que o app precisa, faz as perguntas que o código não responde (nome do projeto, ambiente, escolhas de região) e mapeia as respostas nas entradas do catálogo. Tudo entre uma etapa e outra é código determinístico em Go: o planejador escreve um blueprint.yaml verificado por hash, o renderizador é uma função pura desse arquivo, e a regeneração se recusa a sobrescrever qualquer arquivo que você tenha editado manualmente.
O detalhe mais revelador do design é o comportamento quando o app pede algo fora do catálogo. Se a aplicação precisa de Redis, o resultado não é um módulo improvisado pelo modelo; é um "finding" nomeado, um apontamento formal dizendo que o catálogo ainda não cobre Redis. O agente nunca inventa infraestrutura. Essa é a alegação central do repositório, e o mecanismo que a sustenta é verificável: sem entrada no catálogo, não há saída em Terraform.
No lançamento no Hacker News (abre em nova aba), o autor, bealesh, explicou a motivação ao responder por que não simplesmente pedir ao agente que escreva Terraform:
"LLM's are fantastic syntax generators, but they have no real opinions on architecture or finops."
A comparação que ele usa é com frameworks de aplicação: usar o Neckbeard seria como usar Rails ou Phoenix em vez de escrever Ruby ou Elixir puro. A tese é que o valor de um plugin de infraestrutura não está em gerar mais arquivos, e sim em injetar opiniões arquiteturais que o modelo não tem. É uma tese defensável, mas vale registrar que é a do próprio autor, apresentada em um fórum onde o projeto foi submetido pela mesma pessoa, com 75 pontos e 57 comentários no momento da coleta. Não há ainda avaliação independente publicada.
O que está exercitado de verdade e o que só está declarado
Aqui o README faz algo raro: separa o que passou por teste real do que apenas existe no código. A tabela de status do projeto declara pre-alpha, e os níveis de validação são explícitos.
O nível V0, que exige apenas ferramentas locais, está marcado como PASSED: tofu validate, políticas do Checkov (ferramenta de análise estática de infraestrutura, na qual todo skip carrega um motivo escrito) e kubeconform para validar manifests de Kubernetes. O nível V1, plano autenticado contra a nuvem, e o V2, verificação de deployment real, estão marcados como NOT EXERCISED, porque exigem credenciais de nuvem que o projeto não tem.
A alegação de que os comandos de analyze, plan, estimate, scaffold e validate funcionam nas 12 combinações de nuvem, sistema de CI e runtime (AWS, GCP e Azure, com GitHub Actions ou GitLab CI, sobre containers serverless ou Kubernetes gerenciado) é atribuída no próprio README a uma matriz estática em CI e a três aplicações de referência. Não é a mesma coisa que deploy vivo.
O que teve deploy vivo? Segundo a documentação, o ciclo de deploy, update e rollback em containers serverless passou na combinação AWS/GitHub e Azure/GitHub, com verificações reais de banco de dados e evidências linkadas em docs/tranche-2.md. As demais rotas, GCP, lanes com GitLab, Kubernetes, promoção entre ambientes e drills de recuperação, estão listadas como "Not yet". Landing zones (a fundação de contas, rede e permissões de uma organização na nuvem) foram desenhadas e não construídas. Essa partição entre "passado com evidência" e "implementado, não exercitado" é o dado mais útil da documentação inteira, porque transforma a decisão de adoção em uma decisão sobre rotas específicas, não sobre o projeto como bloco único.
A conta no final: finops como recurso, não como rodapé
O nome "cost-honest" na descrição do repositório não é marketing solto; aponta para um conjunto de escolhas concretas. O comando de estimativa usa o Infracost (abre em nova aba), ferramenta que calcula custos de nuvem a partir de código IaC, com preços ao vivo. O README publica uma tabela comparando as seis rotas serverless e Kubernetes para uma mesma aplicação de referência (um serviço HTTP, um worker, um cron e Postgres), no menor tier, em três ambientes. Os valores divulgados:
| Alvo | Custo mensal estimado (USD) | Observação do README |
|---|---|---|
| Cloud Run (GCP) | $77 | |
| Container Apps (Azure) | ~$98* | Infracost ainda não precifica o compute de Container Apps |
| ECS Fargate (AWS) | $250 | |
| EKS (AWS) | $396 | |
| GKE regional (GCP) | $754 | |
| AKS (Azure) | ~$801* | Mesma ressalva de precificação incompleta |
O asterisco importa e a documentação o explica: onde o Infracost não consegue precificar um recurso, o relatório lista o que ficou de fora ao lado do total. A tabela separa baseline ocioso de uso, escreve as premissas de uso onde podem ser editadas e inclui cenários baixo, esperado e alto.
Três qualificações antes de tratar esses números como orçamento. Primeiro, são estimativas de preços coletadas pelo Infracost sobre uma aplicação de referência, não contas medidas; o resultado real depende de tráfego, região e descontos. Segundo, o comparativo assume a mesma app em todos os alvos, o que é metodologicamente correto para comparação e inadequado como previsão para qualquer app específica. Terceiro, o release v0.3.0, publicado em 15 de outubro, acrescentou alertas de orçamento reais por ambiente e um teto que "recusa": quando a estimativa passa o teto definido, o fluxo para. É o mecanismo que materializa a palavra finops no título do projeto, mas a documentação não relata uso desse teto em produção; é funcionalidade de dias atrás, não prática consolidada.
Instalação, requisitos e o estado real do projeto
O plugin é uma skill mais um CLI pequeno. A skill é o manual operacional do agente (skills/neckbeard/SKILL.md); o CLI executa o trabalho determinístico: plan, render, validate e estimate. No Claude Code (abre em nova aba), a instalação são dois prompts, na ordem documentada:
/plugin marketplace add bealesh/neckbeard
/plugin install neckbeard@neckbeard
Depois, o comando /neckbeard:analyze inicia a análise do repositório. Para o Codex CLI e o Cursor, o caminho é go install github.com/bealesh/neckbeard/cmd/neckbeard@latest seguido de neckbeard skill install -target codex ou -target cursor, o que expõe comandos como /neckbeard-analyze e /neckbeard-doctor. Outros agentes recebem a skill em .agents/skills/neckbeard/. O script de instalação do binário recusa qualquer arquivo cujo sha256 não bata com o checksums.txt do release, uma verificação que deveria ser padrão em ferramentas desse tipo e raramente é.
Sobre coexistência com o ponytail, plugin irmão voltado ao código de aplicação e inspiração declarada do projeto, a documentação de instalação registra o que há: o carregamento dos dois plugins funcionou em Claude Code 2.1.296, mas um onboarding completo com ambos ativos ainda não foi verificado, e isso está trackado na issue #27 do repositório.
O ritmo de desenvolvimento é recente e intenso. A v0.3.0, marcada como Latest, saiu em 15 de outubro; as versões 0.2.0 e 0.2.1, no dia 14. A lista de mudanças inclui alertas de orçamento, mapeamento de imagens de compose para capacidades de datastore e heurísticas de manifest de dependências para detectar datastores ocultos. Os contribuidores identificados são dois: bealesh e team-humaki, que aparece pela primeira vez na v0.2.0. Nenhum roadmap público detalhado aparece nas informações publicadas coletadas. Traduzindo: projeto com uma pessoa carregando o peso principal, outra entrando agora, e semanas de vida pública. Isso não invalida a engenharia, que é visivelmente cuidadosa, mas é o perfil clássico de dependência de mantenedor único, o que pesa em qualquer decisão de colocar a ferramenta em um pipeline sério.
Para quem faz sentido e o contraponto honesto
O próprio autor delimitou o público, quando perguntado no Hacker News se a ferramenta mira deploys pequenos e médios: "Exatamente", respondeu, descrevendo o caso de uso como quem construiu "this cool TS app on vercel and supabase and want to scale it". Ele mencionou a carreira migrando aplicações Rails para fora do Heroku como fonte do design. O nicho, portanto, é a equipe de uma a poucas pessoas que tem um app em containers, quer sair da plataforma gerenciada, não quer contratar um time de plataforma e precisa de infraestrutura que consiga revisar em pull request, com a fatura mensal anexada à decisão.
Nesse nicho, a proposta é coerente com o que está verificado: se o alvo é Cloud Run ou Container Apps via GitHub, as rotas de deploy vivo passaram em teste real com verificações de banco. As condições de adoção responsável seriam: workload que caiba no formato do catálogo (sem Redis, sem filas exóticas, sem nada fora das dez processos e do Postgres), tolerância a pre-alpha, e um humano na equipe capaz de ler OpenTofu, porque revisar é o pressuposto do projeto, não um opcional.
O contraponto é estrutural, não técnico. Um catálogo opinionado compra determinismo com flexibilidade: o mesmo mecanismo que impede o agente de inventar Redis impede a equipe de usar Redis sem estender o catálogo, e estender o catálogo devolve a tarefa de manter módulos testados em CI para quem a ferramenta prometia poupar. A escape hatch existe, é open-source e legítima, mas muda o custo: em vez de pagar um time de plataforma, você paga manutenção de módulos IaC. A alternativa do mercado, camadas genéricas de operação para agentes, servidores MCP e afins, oferece amplitude e deixa as decisões de arquitetura para o modelo, exatamente o que o Neckbeard se recusa a fazer. Não há dados públicos comparando as duas abordagens em resultado real; qualquer afirmação de superioridade de uma sobre a outra seria previsão, não fato.
O que resta decidir: uma aposta estreita, honesta sobre os próprios limites
Depois de percorrer a arquitetura, a tabela de verificação e os números de custo, a avaliação se reduz a uma aposta com contornos claros. O Neckbeard resolve um problema real e mal servido: o gap entre "o agente escreve Terraform plausível" e "a infraestrutura roda, é revisável e tem custo previsível". A engenharia da resposta é acima da média para um projeto nessa fase, com separação determinística/agêncil, hashes no blueprint, checksums na instalação e uma documentação que distingue testado de não testado com um rigor que projetos maduros raramente exibem.
O que a maturidade não sustenta, e a documentação não finge sustentar, é adoção generalizada. Duas rotas de deploy com evidência, dez sem; dois mantenedores; funcionalidades de finops com dias de vida; nenhuma avaliação independente. Para uma equipe no nicho descrito, com alvo em AWS ou Azure sobre serverless via GitHub, um piloto em ambiente de desenvolvimento é razoável e barato de avaliar, dado que o CLI e a skill se removem com facilidade. Para qualquer coisa além desse recorte, a leitura honesta do próprio README diz para esperar.
A questão que o projeto coloca para o ecossistema é maior do que ele mesmo: se a tese do autor estiver certa, o gargalo dos agentes de infraestrutura não será gerar mais código, e sim ter menos decisões para improvisar. A v0.3.0 não decide isso. Os próximos meses de issues, contribuidores e relatos de uso, sim.
Perguntas frequentes
O Neckbeard é gratuito?
Sim. É open-source sob licença Apache-2.0, sem custo de licença. Os custos restantes são os de infraestrutura na nuvem que o plugin provisiona, estimados pelo Infracost, e o tempo de manutenção do catálogo se você decidir estendê-lo.
Preciso do Claude Code para usar?
Não. O Claude Code tem o fluxo de plugin documentado, mas o Neckbeard também funciona com o Codex CLI e o Cursor via go install do CLI seguido de neckbeard skill install, e com outros agentes por meio da skill instalada em .agents/skills/neckbeard/.
Posso colocar em produção hoje?
A documentação declara o projeto como pre-alpha. Apenas as rotas de deploy vivo em AWS/GitHub e Azure/GitHub para containers serverless foram exercitadas com verificações reais de banco de dados; as rotas GCP, GitLab, Kubernetes, promoção e recovery estão marcadas como "Not yet". O uso responsável hoje é piloto em ambiente de desenvolvimento.
Quanto custa a infraestrutura que ele gera?
Depende do alvo escolhido. Para a aplicação de referência da documentação, no menor tier e em três ambientes, as estimativas do Infracost vão de $77 mensais no Cloud Run a cerca de $801 no AKS, com ressalvas de precificação incompleta em Container Apps e AKS. São estimativas com cenários baixo, esperado e alto, não contas medidas.