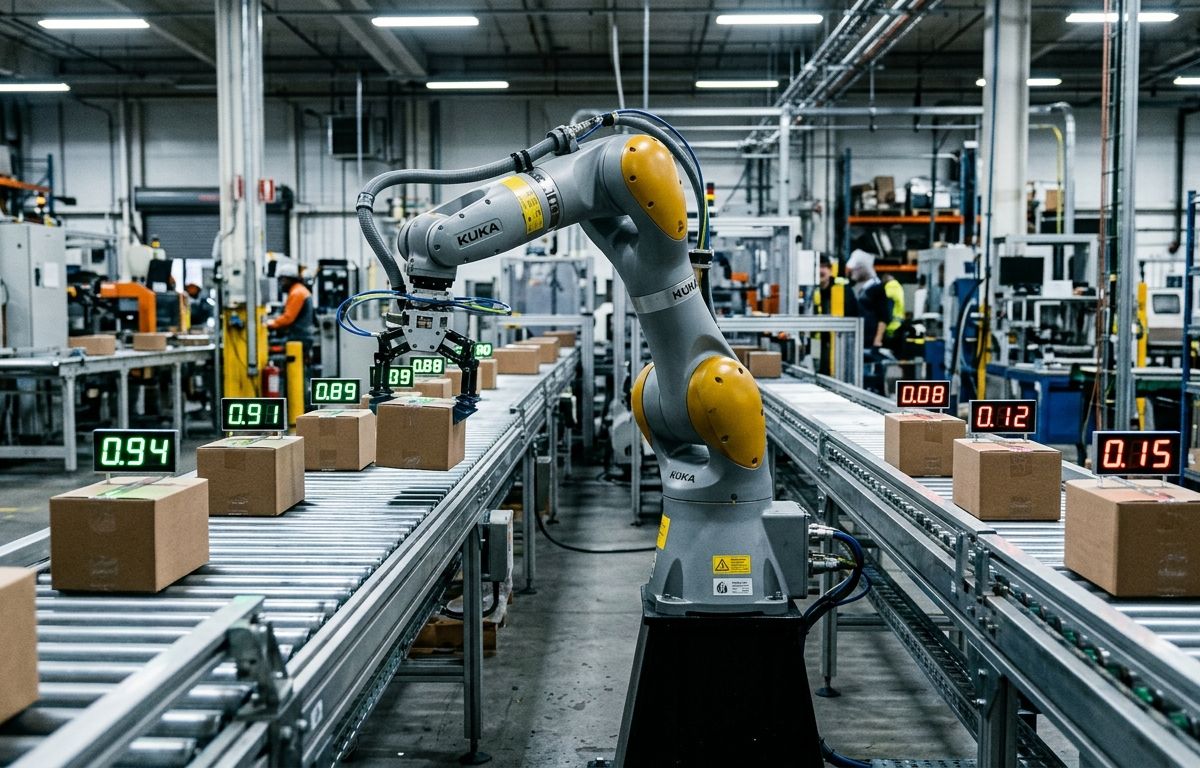
Para fazer um computador escolher entre duas opções, engenheiros passaram anos pedindo a redes neurais de centenas de bilhões de parâmetros que redigissem parágrafos inteiros. Esse descompasso arquitetural começou a ruir em meados de setembro de 2026, quando a TypeSafe AI apresentou o Jev, inaugurando o uso prático dos chamados modelos de decisão.
A proposta inverte a premissa central da IA generativa. Em vez de prever a próxima palavra até formar uma sentença, a rede recebe um estado arbitrário e retorna um valor numérico estruturado: uma probabilidade Bernoulli (apelidada de noul pelos criadores), uma pontuação dentro de um intervalo prévio ou a distribuição de probabilidade sobre um conjunto fixo de opções. Nada de texto livre na saída.
A mecânica elimina camadas de pós-processamento frágeis, como regex para capturar JSONs quebrados, além de reduzir drasticamente o tempo de resposta. A precificação reflete essa assimetria funcional: o Jev cobra US$ 0,042 por milhão de tokens de entrada e tarifa zero para os tokens de saída, já que nenhum texto é sintetizado. Enquanto modelos generativos de fronteira cobram somas substanciais pelo fluxo contínuo de caracteres, o modelo de decisão processa o contexto e devolve apenas o ponteiro da escolha.
Do processamento deliberativo à resposta reflexiva
A conceituação técnica por trás desse formato apoia-se na separação descrita pelo psicólogo Daniel Kahneman entre Sistema 1 (pensamento rápido, intuitivo e automático) e Sistema 2 (raciocínio lento, deliberativo e estruturado em passos). Grandes modelos de linguagem comportam-se como sistemas deliberativos: calculam cadeias de pensamento intermediárias (chain-of-thought) e sintetizam saídas discursivas.
Modelos de decisão foram pensados como um Sistema 1 para sistemas computacionais. Eles operam como chamadas de função determinísticas no desenho, embora estocásticas na inferência interna: entra estado não estruturado, saem decisões tipadas e probabilísticas. Segundo a TypeSafe AI, criada por Diogo Almeida, o modelo recorre a um método denominado Reinforcement Learning for Calibrated Decisions (RLCD), dispensando etapas de geração intermediária para calibrar a resposta.
Esse padrão técnico permite que pipelines de software executem ciclos completos de decisão, com checagem de estado e múltiplas condicionais, até dez vezes por segundo, segundo estimativas de analistas de infraestrutura da Omdia. A latência de inferência situa-se entre 70 e 500 milissegundos.
A explosão de alternativas abertas e proprietárias
O lançamento do Jev provocou uma reação em cadeia de implementações proprietárias e iniciativas da comunidade de código aberto. Jared Palmer publicou a família Kev, que abrange pesos de 0,8B a 27B parâmetros derivados da linhagem Qwen, implementando uma cabeça de ponteiro (pointer head) sobre o transformador. Na mesma linha, o projeto Strands Decider 2B removeu a camada geradora de vocabulário do Qwen3.5-2B, acoplando um adaptador LoRA voltado exclusivamente para ranqueamento de opções.
A corrida industrial ganhou tração em outubro de 2026. A Cloudflare anunciou os modelos Clef (27B) e Clef-flash (9B), este último adaptado também para receber imagens na entrada da decisão. Do lado dos gigantes consolidados, a OpenAI revelou sua API de Decisões utilizando uma versão adaptada do GPT-6 Luna.
A tabela abaixo compara as principais abordagens técnicas observadas nos modelos de decisão documentados no período:
| Modelo / Iniciativa | Base de parâmetros | Mecanismo de saída | Suporte multimodal | Disponibilidade |
|---|---|---|---|---|
| Jev (TypeSafe AI) | Não divulgada publicamente | RLCD proprietário e amostrador paralelo | Apenas texto na entrada | API proprietária |
| Kev (Jared Palmer) | 0.8B a 27B (Qwen3.5/3.8) | Cabeça de ponteiro (pointer head) | Não documentado | Código aberto |
| Strands Decider | 2B (Qwen3.5-2B) | Cabeça de ponteiro com LoRA | Texto | Código aberto |
| Clef / Clef-flash | 9B e 27B | Inferência de decisão e pontuação | Texto e imagens | Plataforma Cloudflare |
| LLM-as-Jev (Pesquisa) | 0.6B a 4B (Qwen3/3.5) | Leitura direta de logits numéricos | Texto e imagens | Framework de pesquisa |
Modelos dedicados versus LLMs congelados
A consolidação dessa classe levanta um debate essencial de engenharia: modelos de decisão exigem arquiteturas próprias ou são apenas um padrão de inferência de modelos convencionais?
Pesquisadores que apresentaram o estudo LLM-as-Jev (abre em nova aba) argumentam que modelos generativos contemporâneos já possuem capacidades decisórias nativas equivalentes. O método demonstra que a extração calibrada de decisões pode ser feita sem nenhum ajuste fino, lendo diretamente as probabilidades dos próximos tokens sobre identificadores numéricos entre colchetes. Nos testes do benchmark público JevBench, a versão congelada do Qwen3.5-4B resolveu 81,4% dos casos (188 de 231 instâncias), superando variações que receberam treinamento específico na mesma ordem de grandeza de parâmetros.
A calibragem estatística, contudo, continua sendo o ponto fraco das arquiteturas reflexivas. No trabalho acadêmico que introduziu o benchmark bilíngue JEVal (abre em nova aba), envolvendo 11.257 instâncias em 10 domínios, constatou-se que modelos de decisão se saem bem quando a resposta depende unicamente das evidências presentes no contexto. Quando a tarefa exige conhecimento especializado profundo ou estimação fiel de incerteza, eles tendem a selecionar a alternativa correta, mas exageram substancialmente o grau de confiança atribuído a ela.
Há também o esforço de destilação. A abordagem descrita no projeto InnerJev treina modelos menores (4B e 27B) para internalizar o raciocínio longo de modelos maiores em uma única passagem no primeiro token, alcançando tempos de resposta na faixa de 60 a 110 milissegundos em placas Nvidia H100.
O gargalo não reside mais na velocidade bruta. Se a aplicação exige simulação social densa, julgamento ético subjetivo ou rótulos ruidosos, modelos de decisão acumulam distorções sistemáticas que modelos generativos com cadeias de raciocínio conseguem mitigar. Para roteamento de chamadas, moderação imediata, triagem de eventos de telemetria e classificação de suporte, contudo, a geração de prosa virou um custo desnecessário.
Perguntas frequentes
O que diferencia um modelo de decisão de um LLM tradicional?
Modelos de linguagem generativos geram texto sequencial palavra por palavra, enquanto modelos de decisão processam o texto de entrada e retornam apenas dados estruturados, como valores booleanos, probabilidades numéricas ou índices de múltipla escolha pré-definidos.
Como funciona a cobrança por tokens em modelos de decisão?
Como o modelo não emite texto livre na resposta, provedores como a TypeSafe AI cobram apenas pelo processamento dos tokens de entrada, deixando a saída com custo zero para a aplicação consumidora.
É necessário treinar um modelo do zero para obter saídas de decisão?
Não. Pesquisas recentes demonstram que modelos de código aberto existentes podem atuar como motores de decisão calibrados lendo as probabilidades dos tokens de resposta direta, embora métodos como destilação e cabeças de ponteiro ofereçam menor latência.
Quais são os principais limites técnicos desse formato?
Os modelos de decisão apresentam dificuldades em tarefas com classes muito refinadas, critérios ambíguos de qualidade ou línguas com poucos recursos de dados, além de tenderem à superestimação da confiança na probabilidade das escolhas.