
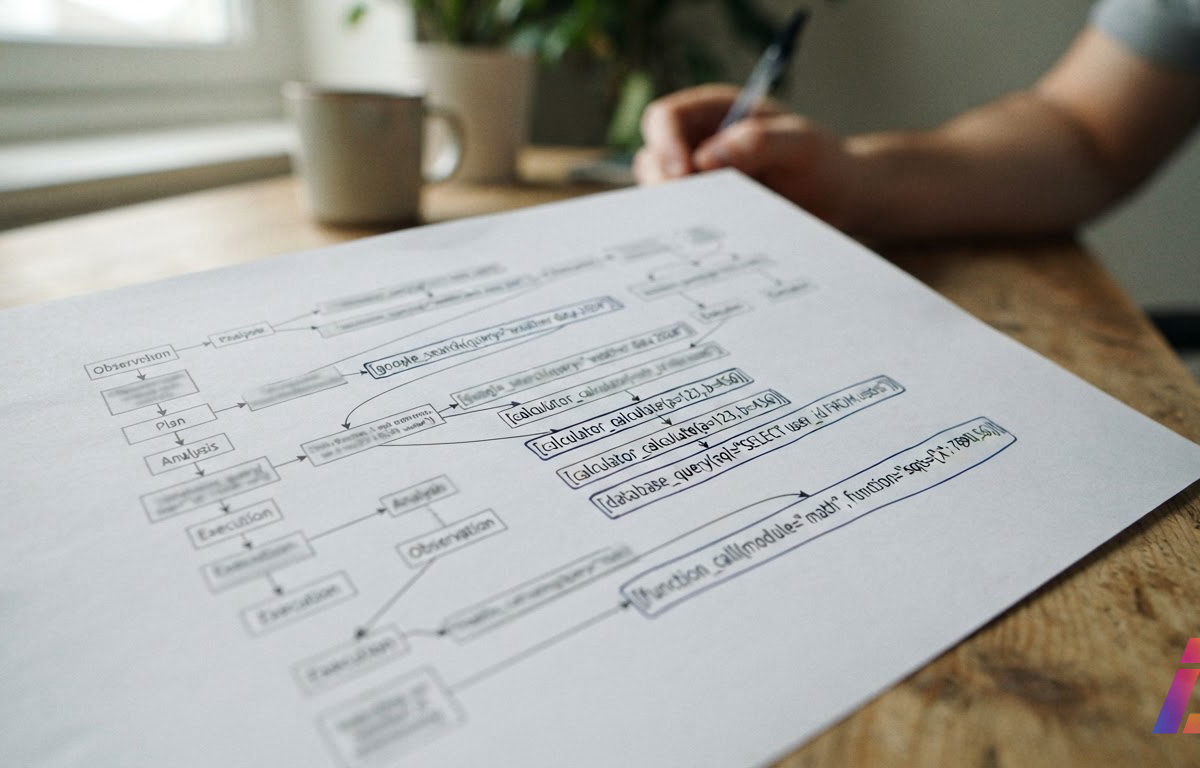
Quem constrói agentes sobre modelos de linguagem quase sempre apoia o trabalho num fato pouco discutido: o raciocínio do modelo fica escrito. Quando um agente erra a terceira chamada de ferramenta numa sequência de dez, você abre o trace e lê o que ele "pensou" antes de errar. A cadeia de raciocínio é o mecanismo que melhora a resposta e também o registro que permite entender por que ela saiu errada. O HybridAgent parte da hipótese de que essas duas funções podem ser separadas e de que só uma delas precisa continuar em texto.
A proposta está no artigo Hybrid Reasoning Agents (abre em nova aba), assinado por Jiaru Zou e colaboradores da Together AI. A tese cabe numa frase: o agente raciocina em espaço latente e age em texto. Entre uma ação e outra, o modelo não escreve uma cadeia de pensamento. Ele itera sobre representações internas contínuas. Só passa para linguagem quando precisa produzir algo que o mundo externo entenda, como uma chamada de ferramenta, um comando ou a resposta final.
Por que o raciocínio sairia do texto
Para avaliar a ideia, vale lembrar o que acontece numa cadeia de pensamento comum. A cada passo, o modelo calcula um estado interno de alta dimensão, projeta esse estado numa distribuição sobre o vocabulário, sorteia ou escolhe um único token e depois reconverte esse token em embedding para o passo seguinte. A maior parte da informação do estado é descartada nesse caminho. Se o modelo estava dividido entre duas abordagens, o token escolhido registra apenas uma delas. O texto age como um gargalo: estreito, discreto e legível.
O raciocínio latente tenta contornar esse gargalo. Em vez de decodificar um token, o modelo devolve o próprio estado oculto como entrada do passo seguinte, e o "pensamento" passa a ser uma sequência de vetores. A linha de pesquisa mais conhecida nessa direção é o Coconut (Chain of Continuous Thought), da Meta, que mostrou ser possível treinar um modelo para encadear estados contínuos em vez de palavras. A motivação tem dois lados. O primeiro é de capacidade: um vetor pode representar várias hipóteses ao mesmo tempo, algo que um token não consegue. O segundo é de custo: cada passo latente dispensa a geração de tokens que ninguém precisava ler.
A contribuição do HybridAgent está na fronteira entre os dois regimes. Um modelo que raciocina só em vetores funciona bem em problemas fechados, como aritmética e lógica, em que a entrada chega e a resposta sai. Um agente tem outra natureza. Ele conversa com sistemas que exigem texto bem formado: uma API espera JSON válido, um shell espera um comando e um buscador espera uma consulta. As observações também voltam como texto. O agente híbrido, portanto, precisa trocar de modo várias vezes dentro de uma mesma tarefa, pensando em vetores, emitindo uma ação legível, recebendo uma resposta em texto e voltando aos vetores. Pelo que os autores descrevem, é esse ciclo que o método organiza. Os detalhes de como o modelo decide a hora de sair do espaço latente e de como é treinado para isso estão no corpo do artigo e no repositório oficial (abre em nova aba), e são justamente esses detalhes que determinam se a técnica serve para outros casos.
O que os números dizem e o que não dizem
A Seção 5 da versão HTML do artigo (abre em nova aba) compara o HybridAgent com agentes que usam cadeia de pensamento explícita e com outras linhas de base que operam só em texto. Três métricas são medidas: acurácia, número de tokens gerados e latência. Os autores reportam ganhos nas três frentes, sob as tarefas, versões de modelo e configurações de decodificação que eles mesmos definiram.
Esse último trecho pesa mais do que parece. Os números são medições dos autores e não foram reproduzidos de forma independente. O README do repositório, quando cita resultados, reproduz o que está no artigo e não traz auditoria de terceiros. Isso não torna os resultados suspeitos, porque é assim que quase toda pesquisa chega a público. Significa que o leitor técnico precisa fazer, por conta própria, as perguntas que um revisor faria.
Das três métricas, a redução de tokens gerados é a mais fácil de aceitar, porque decorre quase diretamente do desenho. Se o raciocínio deixa de ser escrito, sobra pouco a escrever além das ações. A latência tende a acompanhar, com uma ressalva: passos latentes também consomem forward passes, e o ganho real depende de quantos passos o modelo dá e de quão bem o motor de inferência lida com esse laço fora do padrão. A acurácia é a métrica que exige mais cautela. Que o modelo erre menos pensando em vetores do que em palavras é uma afirmação empírica forte. Ela pode ser verdadeira nas tarefas do artigo sem ser verdadeira nas suas.
Quem ganha
O primeiro beneficiado é quem opera GPUs. A Together AI vende inferência, e menos tokens por tarefa resolvida significa mais tarefas por placa por hora. Esse interesse não invalida a pesquisa, mas explica por que ela saiu de lá. Também ajuda a separar dois públicos com interesses diferentes: para quem paga por token gerado numa API, a economia aparece direto na fatura; para quem fatura por token, o incentivo é mais ambíguo.
O segundo é quem roda agentes com laços longos e muitas etapas, em que a maior parte do texto produzido é deliberação que ninguém lê. Num agente que faz trinta chamadas de ferramenta e escreve parágrafos de raciocínio entre elas, o custo e o tempo ficam concentrados exatamente na parte que o método elimina. Para tarefas curtas, com uma ou duas ações, a margem de ganho é bem menor.
O terceiro é quem já trabalha com pesos abertos e controla a própria pilha de inferência. O raciocínio latente exige acesso aos estados ocultos do modelo e um laço de decodificação que os realimente. Quem usa um modelo fechado por API não tem como aplicar a técnica, porque a API devolve texto e nada mais.
Quem perde
O custo mais evidente recai sobre a auditabilidade. Num agente com cadeia de pensamento explícita, o registro de cada execução traz as ações e o caminho que levou a elas. No HybridAgent, as ações continuam legíveis e o caminho passa a ser uma sequência de vetores. Ainda é possível registrar esses vetores e usar sondas treinadas para inferir algo sobre eles, mas isso é trabalho de pesquisa em interpretabilidade, não algo que um engenheiro faz numa tarde de depuração.
Para depurar, a diferença é concreta. Quando um agente textual apaga o arquivo errado, o trace costuma mostrar o momento em que ele interpretou mal a instrução. Num agente híbrido, você vê a ação errada e um intervalo opaco antes dela. O diagnóstico passa a depender de reproduzir o erro e variar entradas, como se faz com qualquer rede neural sem explicação.
Para segurança, a perda é maior. Parte do trabalho atual de supervisão de agentes se apoia na premissa de que a cadeia de pensamento é monitorável: um segundo modelo ou um humano lê o raciocínio e sinaliza intenções problemáticas antes que virem ações. Essa premissa já era frágil, porque nada garante que o texto escrito reflita fielmente o cálculo interno. Ainda assim, era alguma coisa. O raciocínio latente remove essa camada por completo, e quem opera agentes com acesso a sistemas sensíveis precisa saber que sobra apenas o monitoramento das ações.
Existe ainda a questão da generalização. Representações contínuas aprendidas no treino tendem a funcionar bem dentro da distribuição em que foram aprendidas. A cadeia de pensamento em texto tem uma vantagem que costuma ser subestimada: ela pode ser orientada por prompt. Você escreve "verifique as unidades antes de responder" e o modelo, com frequência, verifica. Não está claro que haja um equivalente para o raciocínio latente, que depende do que foi aprendido no treino. É razoável supor que a técnica se degrade de maneira menos previsível em tarefas fora da distribuição, mas trata-se de uma inferência, e os resultados do próprio artigo e testes de terceiros é que vão confirmá-la ou desmenti-la.
O que é preciso para testar
O repositório traz o código e a documentação da implementação, e o README aponta para o artigo e para a coleção no Hugging Face (abre em nova aba), onde a Together publica os artefatos associados. Antes de planejar qualquer uso, alguns pontos precisam ser conferidos diretamente nessas páginas, porque não estão resolvidos em nenhum documento de produto:
- Licença. Confira o arquivo de licença do repositório e o cartão de cada modelo na coleção. Código e pesos podem ter licenças diferentes, e os pesos herdam as restrições do modelo base.
- Motor de inferência. Um laço que realimenta estados ocultos foge do padrão para o qual os servidores de inferência mais usados foram otimizados. Veja se o repositório oferece integração com o seu motor ou só uma implementação de referência. Na segunda hipótese, os ganhos de latência do artigo provavelmente não se repetem no seu ambiente sem trabalho adicional.
- Hardware. Requisitos dependem do tamanho dos modelos publicados. Consulte os cartões na coleção em vez de supor.
- Idioma. A coleção não documenta desempenho em português nem condições comerciais ou de implantação no Brasil. Em tese, o raciocínio latente não está atrelado a uma língua, mas as ações e as observações são texto, e o comportamento em português depende do modelo base e dos dados de treino. É preciso medir.
Exagero e realidade
O que se sustenta: a técnica existe, tem código público e ataca um custo real dos agentes atuais, que é o volume de tokens de deliberação gerados e descartados. A separação entre pensar em vetores e agir em texto é uma solução sensata para o problema de que ferramentas exigem texto bem formado. Os ganhos em tokens decorrem do próprio desenho e não deveriam surpreender ninguém.
O que ainda é alegação: a ideia de que o agente híbrido acerta mais, e não só gasta menos. Esse resultado existe, na Seção 5, nas condições escolhidas pelos autores. Ele pode resistir a reproduções independentes ou pode encolher quando a linha de base receber o mesmo cuidado de treino e quando as tarefas saírem da distribuição.
O que seria exagero: tratar o HybridAgent como substituto geral da cadeia de pensamento explícita, ou como uma técnica que se pluga num agente existente. Ela exige pesos abertos, ajuste do modelo e mudanças no laço de inferência. E abre mão de uma propriedade que muita gente nem percebia ter até agora.
Julgamento
O HybridAgent é uma boa pesquisa com uma troca clara, e a troca precisa ser avaliada pelo que é. Ganha-se eficiência na parte do trabalho do agente que ninguém lê. Perde-se a capacidade de ler essa parte quando seria útil lê-la. Para um pipeline de alto volume, com tarefas bem delimitadas, ações de baixo risco e um modelo aberto que você controla, a conta pode fechar, e vale montar um experimento comparando com a sua própria linha de base textual, nas suas próprias tarefas, medindo latência no seu motor de inferência. Para agentes com acesso a dados sensíveis, ações irreversíveis ou exigências de auditoria, a recomendação é esperar. Os números dos autores podem estar certos. O problema é que, nesses casos, o raciocínio legível é parte do sistema de controle e não um custo a ser cortado. Até surgirem reproduções independentes e formas práticas de inspecionar o que acontece no espaço latente, o HybridAgent tem lugar no laboratório e em casos de uso estreitos, e não deve substituir a cadeia de pensamento explícita como padrão.