Um detalhe do repositório conta metade da história antes de qualquer leitura da documentação: o commit mais recente do README, o b98ff7d de 9 de outubro de 2026, aparece assinado por "K-Mistele and claude". Um humano e um modelo, juntos, escrevendo a documentação de um sistema cujo propósito é que modelos escrevam código com pouca supervisão humana. A HumanLayer, empresa identificada no perfil de Kyle Mistele (abre em nova aba) como liderada tecnicamente por ele, publicou nessa data o effect-channels (abre em nova aba), conjunto open-source em TypeScript sob licença MIT que implementa um agente de codificação de fundo, sem servidor dedicado, capaz de receber uma menção em uma issue do GitHub, trabalhar o repositório e abrir um pull request em resposta.
O anúncio e o que ele realmente mostra
O anúncio veio pelo X, na conta de Mistele, no dia 9 de outubro. O texto completo vale a leitura porque define a tese técnica antes das peças de código:
Acabei de criar um pull request a partir de uma issue do GitHub por meio de um agente em segundo plano serverless, e é totalmente open-source
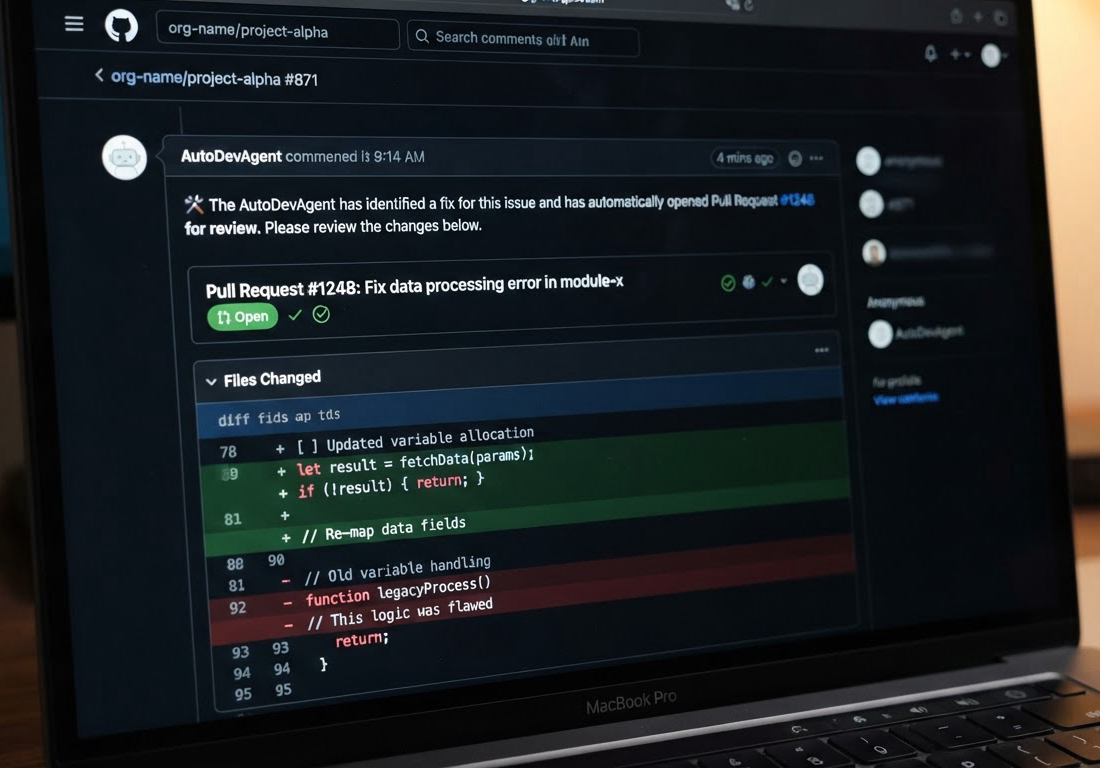
Na sequência do mesmo post, Mistele descreve a abordagem como um agente leve rodando em um runtime com sistema de arquivos virtual, que só aciona um contêiner quando necessário, "mais rápido, mais barato", combinado com bindings de eventos para GitHub, Slack e Linear. O exemplo que ele aponta como demonstração funcional é uma issue real no repositório fold (abre em nova aba), também da HumanLayer, numerada 60.
Há uma distinção que precisa ficar clara desde o início. O que está verificável hoje são os repositórios públicos, seus READMEs e a existência da issue citada como demonstração. O que são alegações do autor, ainda sem medição independente, incluem as promessas de desempenho ("mais rápido, mais barato"), o uso de FUSE para o sistema de arquivos virtual, a geração automática de ferramentas a partir de webhooks, a possibilidade de repasse para um cluster Kubernetes e a investigação automática de falhas de CI. Um verbete em chinês publicado no mesmo dia por um agregador republica o post de Mistele, o que não constitui verificação separada: é a mesma fonte, com autoria idêntica.
Por dentro: três Durable Objects e um debounce de três segundos
O README do exemplo alchemy-cloudflare (abre em nova aba) descreve o fluxo com precisão suficiente para reconstruir mentalmente o sistema. Tudo roda na plataforma da Cloudflare: Workers para receber os webhooks, Durable Objects para o estado e um contêiner para o trabalho pesado. A implantação usa o Alchemy, framework de infraestrutura como código.
Cada issue ou pull request mencionado ganha três Durable Objects com nomes derivados dele. A divisão é didática:
| Objeto | Função documentada |
|---|---|
| DeliveryMailbox | Armazena eventos em ordem e controla a entrega com debounce |
| AgentSession | Mantém a conversa e a entrega das respostas do agente |
| Computer | Guarda o repositório clonado, os arquivos e o contêiner Linux |
O fluxo começa com o webhook sendo salvo no mailbox, que aguarda três segundos antes de despachar a menção. Esse debounce é um detalhe pequeno com consequência grande: evita que edições sucessivas da issue, ou menções em rajada, disparem execuções concorrentes do agente. Depois disso, a sessão do agente clona ou atualiza o repositório, chama o modelo e executa ferramentas, reporta o progresso por uma API de entrega, e o Channels publica a resposta no thread do GitHub.
O componente que orquestra os eventos é o Channels, descrito no README do repositório principal como uma camada de assinaturas de webhooks "effect-native" com tratamento nativo por provedor: callbacks do Slack caem em threads do Slack, callbacks do GitHub em issues e pull requests, callbacks do Linear em issues e sessões de agente. A frase mais reveladora da documentação é que não existe um tipo de mensagem de menor denominador comum entre os provedores; cada canal mostra o progresso do agente à sua maneira. O transporte roda sobre Postgres, Redis, Durable Objects ou memória, o que separa a lógica da infraestrutura.
O cérebro da execução é o Fold, descrito como um núcleo de agente isomórfico e agnóstico de provedor, com núcleo baseado em log, ferramentas de sistema de arquivos, subagentes e auto-compaction de contexto. No exemplo do GitHub, cada turno do agente roda em segundo plano, o log fica em SQLite e um turno interrompido por deploy ou crash continua do ponto onde parou no reinício. O modelo citado no README do exemplo é o gpt-6.1-sol da OpenAI; vale notar que o exemplo separado de chat do Fold, no mesmo repositório, documenta o gpt-5.6-terra, indício de que a escolha de modelo é configuração, não parte fixa da arquitetura.
O sandbox em camadas: SQLite como sistema de arquivos
A parte tecnicamente mais interessante é onde os arquivos vivem. Segundo o README, arquivos e objetos de git residem no SQLite do Durable Object, e o comando just-bash executa em um shell de Worker Loader, sem contêiner. Quando o agente precisa de um bash completo, com backend "container", a execução ocorre em um contêiner Debian com Node, Bun, Python e acesso à internet, e os arquivos modificados são copiados para dentro antes de cada comando e para fora depois. O contêiner sobe uma única vez, logo após o primeiro clone, e o README indica que um Computer ocioso por 14 dias é deletado junto com sua sessão.
Essa arquitetura em camadas é a materialização da tese anunciada por Mistele: a maior parte do trabalho de um agente de codificação é leitura de arquivos, busca de texto e edições pontuais, operações que não justificam manter um contêiner vivo. O contêiner só entra em cena quando há comando real a executar. O custo de um agente que dorme entre turnos se aproxima do custo de armazenamento em SQLite, e não do custo de uma máquina virtual ligada. É a mesma lógica econômica que transformou funções serverless no padrão para cargas de tráfego irregular, aplicada a agentes que podem ficar horas ou dias sem ser acionados.
Aqui cabe uma ressalva de raciocínio: a descrição acima vem da documentação escrita pelos próprios autores, não de testes independentes. As propriedades de isolamento, a latência real de cold start do contêiner e o comportamento sob repositórios grandes são perguntas em aberto, e o README não apresenta números para nenhuma delas.
Por que serverless, e não um runner sempre ligado
O contraste com as alternativas existentes ajuda a entender o incentivo por trás do projeto. A rota convencional para agentes de codificação em repositórios envolve runners persistentes, máquinas ou contêineres de longa duração que esperam eventos, ou serviços gerenciados das próprias plataformas. Ambas as opções cobram pela disponibilidade contínua, mesmo quando o agente não é acionado durante dias. O modelo do HumanLayer inverte a lógica: nada roda até o webhook chegar, e o estado sobrevive em objetos baratos que o Cloudflare acorda por alarme.
Para a HumanLayer, o cálculo estratégico também é visível no post. Mistele fala em pensar "como devem ser os blocos de construção de boas fábricas de software open-source", e o efeito prático é posicionar a empresa como fornecedora de infraestrutura de agentes, com o Channels como camada de eventos e o Fold como runtime, ambos MIT. Open-source nesse contexto não é filantropia: é a forma mais rápida de criar padrão de fato em um mercado onde as plataformas fechadas têm vantagem de distribuição.
O contraponto consistente a essa tese é o risco operacional do modelo "estado em SQLite + contêiner sob demanda". Sistemas distribuídos que copiam arquivos para dentro e para fora de contêineres a cada comando introduzem superfícies de falha que um runner persistente não tem: divergência entre o que o SQLite acredita e o que o contêiner fez, corridas entre comandos paralelos, limites de tamanho do armazenamento do Durable Object. A documentação não apresenta medições de consistência ou throughput, e a maturidade do projeto, medindo pelos números públicos, é incipiente: o effect-channels listava 33 estrelas em 10 de outubro de 2026, e o fold, 140. São bibliotecas jovens, não infraestrutura consolidada.
O que está comprovado e o que é alegação do autor
Vale separar explicitamente os três níveis de certeza neste caso. Fato observável: os repositórios existem, são públicos, sob MIT, e a documentação descreve em detalhe o funcionamento, incluindo a issue de demonstração do fold. Comportamento documentado no README: o agente reage com emoji de olhos à menção, usa o branch humanlayer/issue-42 derivado da branch padrão para a issue de número 42, abre pull request em rascunho com github_create_pull_request e a marcação Closes #42, recusa trabalhar em forks, e rotula novas issues e pull requests automaticamente com um classificador chamado Clef, executado via Workers AI, aplicando rótulos com pontuação igual ou superior a 0,7 sem acionar o agente.
Alegação do autor, sem medição publicada: velocidade e custo superiores, sistema de arquivos virtual via FUSE, ferramentas geradas a partir de webhooks, repasse para Kubernetes e investigação automática de falhas de CI. Nenhuma dessas propriedades tem número, benchmark ou comparativo anexo. O resultado de referência, o pull request gerado a partir da issue 60 do fold, é apontado pelo autor como exemplo funcional, mas sua qualidade não foi avaliada independentemente nesta apuração.
Essa assimetria não invalida o trabalho; ela apenas delimita o que se pode concluir hoje. A arquitetura está aberta para inspeção, o que significa que qualquer pessoa com experiência em Durable Objects pode auditar o código e verificar as afirmações por conta própria. É exatamente essa a função de soltar algo sob MIT antes de ter números: convidar a comunidade a produzir as medições que faltam.
Decisões práticas: para quem isso faz sentido
Um time técnico que avalie rodar algo assim precisa decidir algumas coisas antes de qualquer deploy.
- Modelo de confiança: o agente roda com credenciais de aplicação do GitHub capazes de abrir branches e pull requests. O README documenta a recusa de forks, o que limita um vetor de abuso, mas a política para repositórios sensíveis, segredos em builds e dependências durante o clone é decisão do operador, não do projeto.
- Custo de inferência: o modelo citado é um endpoint da OpenAI, e o custo por execução depende do tamanho do contexto e do número de turnos. Nenhum número foi publicado; a estimativa só é possível depois de instrumentar o próprio uso.
- Custo de plataforma: Workers, Durable Objects e contêineres têm modelos de cobrança próprios na Cloudflare, com preços que mudam com o tempo; a avaliação exige consultar a tabela vigente, não os preços divulgados por terceiros.
- Fluxo de revisão: o design entrega pull requests em rascunho e responde a comentários de linha no thread, o que encaixa bem em times com revisão humana obrigatória e mal em processos que exigem garantia de correção antes da abertura.
O perfil de uso em que a proposta brilha é o de repositórios com fluxo intenso de issues e períodos longos de ociosidade do agente: projetos open-source, times com triagem pesada, manutenção distribuída. Quem já mantém um cluster Kubernetes com capacidade ociosa pode achar o sandbox em Durable Objects uma complexidade desnecessária. Quem paga por runners dedicados que ficam ociosos tem o caso de uso exato para o modelo contrário.
No Brasil, a adição de camadas de Cloudflare Workers e Durable Objects é viável, já que a plataforma opera globalmente, mas a dependência de um endpoint de inferência da OpenAI reintroduz a preocupação conhecida de times locais com custos em dólar e volatilidade cambial em cargas de uso variável, tema que não é endereçado pela documentação do projeto e exige simulação própria com dados reais de consumo.
Conclusão: o argumento é econômico, e a prova ainda está por vir
O que a HumanLayer publicou em 9 de outubro não é apenas mais um agente de codificação; é uma aposta sobre onde o custo de agentes de fundo deve morar. Ao colocar eventos, sessão e sandbox em objetos que dormem e acordam por demanda, o effect-channels ataca o item de despesa mais previsível dos agentes persistentes, a ociosidade, e o faz com código MIT que qualquer um pode inspecionar, copiar e criticar. O desenho é coerente, a documentação é surpreendentemente específica sobre estado, falha e recuperação, e a escolha de resolver threading e debounce na camada de eventos, em vez de deixar cada integrante da "fábrica de software" resolver por conta própria, mostra maturidade de arquitetura incomum para um projeto com 33 estrelas.
A ressalva final é a mesma que separa demo de infraestrutura: as afirmações de custo e desempenho são do autor, o exemplo de referência é uma única issue, e não existem benchmarks públicos. O próximo passo observável, e o critério justo de avaliação, é ver terceiros rodando o exemplo em repositórios reais e publicando números próprios de latência, custo por pull request e taxa de intervenção humana. Até lá, o que se pode afirmar com segurança é que o projeto transforma uma pergunta abstrata, "quanto custa manter um agente esperando eventos?", em uma implementação concreta que qualquer desenvolvedor pode medir sozinho.
Perguntas frequentes
O agente funciona com repositórios privados?
A documentação descreve a demonstração em repositórios públicos da própria HumanLayer e menciona recusa a forks. Nada no README impede o uso com repositórios privados, mas também não há orientação publicada sobre credenciais, segredos ou isolamento nesse cenário; a decisão fica a cargo de quem opera.
Qual modelo de linguagem o agente usa?
O README do exemplo do GitHub documenta o gpt-6.1-sol, via OpenAI, como modelo da sessão do agente. Como o Fold é agnóstico de provedor, a escolha de modelo é configuração, e um outro exemplo do mesmo repositório documenta um modelo diferente.
Quanto custa rodar esse agente?
Nenhum custo foi publicado, nem de inferência nem de infraestrutura. Os componentes são open-source, mas o uso envolve cobranças da Cloudflare e do provedor de modelo, que variam com consumo; qualquer estimativa exige medição própria.
É obrigatório usar Cloudflare?
Não para o núcleo. O Channels documenta suporte a Postgres, Redis, Durable Objects ou memória, e o Fold é descrito como isomórfico, rodando em vários ambientes. O Cloudflare é a plataforma do exemplo completo, não uma dependência da biblioteca.