
Toda conversa civilizada começa com um "oi". Entre agentes de IA, o "oi" vem com formulário: qual versão você fala, o que sabe fazer, me manda a lista. Pranav Varshney, da Universidade de Michigan, resolveu cronometrar essa etiqueta. O resultado está no arXiv: The Cost of Saying Hello (abre em nova aba), apresentado pelo autor como o primeiro benchmark empírico, decomposto por fases, dos handshakes do MCP (abre em nova aba), do A2A e do ACP.
A manchete pronta diz que o MCP legado leva 230 ms para se apresentar e o A2A leva 61. Leio o estudo de outro jeito. A latência é um problema que a própria especificação do MCP já está aposentando. O preço que deveria incomodar quem constrói agentes se paga em contexto, e essa é justamente a parte que o estudo mede com menos firmeza.
O cronômetro na porta
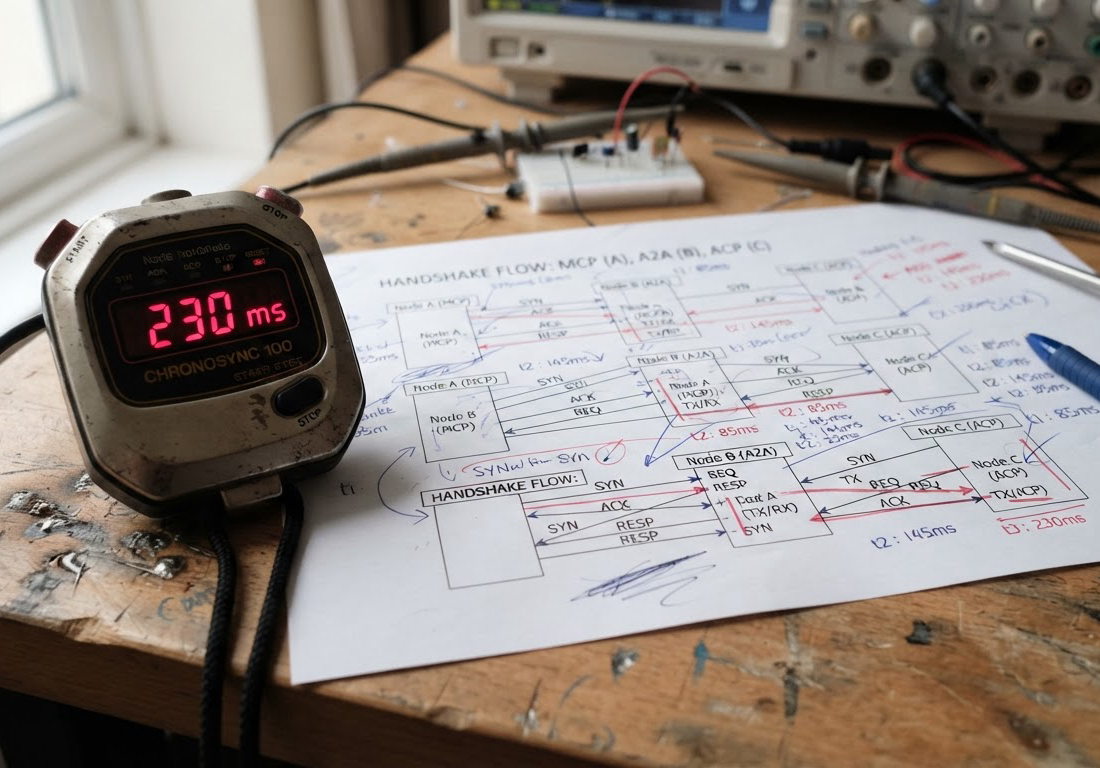
O desenho do experimento é simples o bastante para ser conferido, o que já é um elogio. Varshney usou os SDKs oficiais em Python: mcp 2.0.0, a2a-sdk 1.1.2 (especificação A2A v1.0.0, sobre JSON-RPC) e acp-sdk 1.0.3. O MCP roda sobre streamable HTTP e foi dividido em duas eras:
- Legada, das revisões de 2024-11 a 2025-11-25, com a coreografia
initialize, notificaçãoinitializedetools/list. - Moderna, da revisão 2026-07-28, que troca tudo isso por
server/discovercom as dicas de cache da SEP-2549.
São quatro cenários: início frio, repetição morna, incompatibilidade de capacidades e metadados degradados. Cada célula tem 50 execuções, em loopback e sob 50 ms de RTT emulado.
Um detalhe merece nota de rodapé. O ACP medido é o Agent Communication Protocol do BeeAI, da IBM, que segundo o paper se fundiu ao A2A em agosto de 2025 e é tratado como congelado. Cronometra-se, portanto, um protocolo aposentado, e a aposentadoria aparece nas dependências. O repositório precisa segurar o FastAPI abaixo da 0.116 porque o acp-sdk 1.0.3 não aceita a validação das versões seguintes. Protocolo congelado é isso: ele para no tempo, e as dependências seguem a vida sem ele.
Os números
Medianas reportadas no paper, N=50:
| Protocolo | Round-trips (frio) | Conexões | Frio, 50 ms RTT | Frio, loopback | Morno, 50 ms RTT | Bytes no frio (subida + descida) |
|---|---|---|---|---|---|---|
| MCP legado | 3 | 3 | 230 ms (p95 236) | 6,1 ms | 230 ms (3 RT) | 1.147 + 1.522 |
| MCP 2026 | 2 | 1 | 122 ms (p95 125) | 4,4 ms | 63,5 ms automático (1 RT); 6,6 ms com era fixada (0 RT) | 1.070 + 1.205 |
| A2A | 1 | 1 | 61,0 ms (p95 61,9) | 2,8 ms | 2,0 ms (0 RT) | 170 + 569 |
| ACP | 1 | 1 | 62,1 ms (p95 63,1) | 2,8 ms | 6,6 ms (0 RT) | 149 + 633 |
O número mais constrangedor para o MCP legado está na coluna morna, não na fria: 230 ms de novo. O cliente legado é o parente que, em todo almoço de domingo, se apresenta outra vez e pergunta o que você faz da vida. Toda reconexão repete as mesmas três idas e voltas e as mesmas perguntas.
A distância agrava o vexame. Na varredura de RTT, o handshake legado cresce 4,2 ms por milissegundo de RTT, contra 2,1 do moderno e 1,1 do A2A e do ACP. O autor ainda admite, na seção de ameaças à validade, que o atraso emulado por relay em espaço de usuário não inclui o estabelecimento de TCP. Pela estimativa dele, as três conexões do MCP legado custariam uns 100 ms a mais num link real de 50 ms. Os 230 ms, portanto, são uma conta generosa.
Por que os milissegundos quase não importam
Agora o outro lado da régua. Em loopback, a distância entre o pior e o melhor protocolo é de 3,3 ms, abaixo dos cerca de 5 ms que o próprio paper declara como piso de ruído entre células. Na mesma máquina, ou no mesmo datacenter, a discussão praticamente evapora. Mesmo a 50 ms de RTT, os 230 ms tendem a sumir dentro do tempo de uma única resposta de modelo. Um agente que mantém sessão longa com um servidor paga o cumprimento uma vez e passa o resto do tempo esperando o LLM pensar.
Há cenários em que isso muda, e eles não são exóticos:
- agentes efêmeros que nascem, chamam uma ferramenta e morrem;
- funções serverless que reconectam a cada invocação;
- cadeias em que um agente chama outro, que chama um terceiro, cada um começando a frio;
- servidores do outro lado do oceano.
Nesses casos o MCP legado cobra caro sempre, porque não aprende. Mas a tabela já mostra a saída. A revisão de 2026 corta o início frio para dois round-trips e, com a era fixada, zera o custo na reconexão morna: a 50 ms de RTT, cai de 230 para 6,6 ms. Isso não pede revisão de arquitetura. Pede uma atualização de SDK.
A conta que chega depois
O estudo faz uma pergunta que vale mais que o cronômetro inteiro: quanto custa quando o LLM precisa ler os metadados do outro lado?
- Uma capacidade: o MCP legado ocupa 181 tokens, o MCP 2026 ocupa 242, o A2A 113 e o ACP 112.
- Custo marginal por capacidade: 78 tokens no MCP, 24 no A2A e 107 no ACP.
- Duzentas capacidades: 15.618 tokens no MCP e 21.405 no ACP, algo como 8% e 11% de uma janela de 200 mil tokens, gastos antes de a tarefa começar.
Em dinheiro, é troco. O autor assume o preço de tabela de US$ 3 por milhão de tokens de entrada do Claude Sonnet 5. Com isso, o handshake legado de uma capacidade sai a US$ 543 por milhão de handshakes, menos de um décimo de centavo cada. O problema não é a fatura. É o contexto, recurso que não se compra com cartão: cada token de inventário é um token a menos para tarefa, histórico e raciocínio.
Aqui está a ironia que mais me interessa. O MCP de 2026 ficou mais rápido e mais falante. Faz menos viagens e carrega mala maior: 953 bytes contra 726, e 242 tokens contra 181, na apresentação de uma capacidade. A revisão atacou o custo que aparece no trace de rede e engordou o que aparece no prompt. Se esses metadados vão parar inteiros no contexto do modelo, o MCP novo cumprimenta mais depressa e depois fala mais na mesa do jantar.
O melhor contraponto
A objeção séria não mira os milissegundos. Mira a minha tese, porque a parte de tokens é a mais frágil do estudo. A Tabela 5, que sustenta os números de 200 capacidades, é uma replicação sintética de entradas capturadas no fio, não uma varredura com servidores reais. A Seção 7 reconhece que o tamanho do inventário não foi variado em contrapartes vivas, então os 11% são extrapolação, não medição. A contagem ainda usa o tokenizador o200k_base, da OpenAI, aplicado ao preço de lista de um modelo da Anthropic, que tokeniza do seu próprio jeito. E dá para argumentar que clientes maduros não despejam 200 descrições de ferramentas no prompt: eles filtram, recuperam sob demanda e aproveitam cache.
Concordo com quase tudo, e a tese continua de pé. O número exato é frágil, mas a ordem de grandeza não é: dezenas de tokens por capacidade, multiplicadas por inventários de centenas, viram uma fatia visível da janela. E se a solução é o cliente filtrar, isso confirma o ponto. O custo do cumprimento deixou de ser problema do protocolo e virou problema de quem integra, e nenhuma revisão de especificação resolve isso por você.
Quem for usar os números precisa conhecer outras ressalvas:
- É um preprint v1, sem revisão por pares. Segundo o repositório, uma versão de seis páginas foi aceita como pôster, não arquivístico, no workshop AgenticOS do NeurIPS 2026.
- Entre os quatro cenários não há fluxo de autenticação como OAuth, que em produção pode pesar mais que todo o resto do cumprimento.
- Os dois documentos do próprio autor não batem. O HTML do paper data os experimentos de 10 de agosto de 2026, numa máquina Apple silicon com macOS e atraso por relay em espaço de usuário. O README diz que as medições foram feitas em 30 de setembro, numa VM Linux 6.8 sobre um Mac M5, com emulação no kernel via tc-netem, e que as duas formas de emulação concordam dentro de poucos por cento. Pode ser só uma atualização para o pôster, mas quem reproduzir deve anotar qual configuração está comparando.
- Até agora não há notícia de replicação independente, embora o código esteja aberto para isso.
Fecho
O benchmark é útil justamente por ser modesto: mede uma coisa pequena com cuidado e publica o código. Ele prova sem margem que o MCP legado tinha uma etiqueta excessiva, repetida a cada reencontro, e que a revisão de 2026 já corrige a maior parte dela. Aponta também, com menos certeza e mais importância, que o cumprimento caro mudou de endereço: saiu da rede e foi morar no prompt. Atualize o SDK, fixe a era e comece a contar os tokens que seus agentes gastam se apresentando. O "oi" rápido já está garantido; falta aprender a ser breve.