
Há uma palavra que anda fazendo hora extra nos anúncios de modelos: "empata". O modelo novo empata com o grande, o pequeno empata com o caro, e o leitor fica com a impressão de que a hierarquia acabou. O GPT-6.1 Terra, que a OpenAI (abre em nova aba) apresentou em 26 de outubro, chegou com o empate dele. No Agents' Last Exam, em esforço médio, o Terra faria o mesmo que o GPT-6 Astra cobrando um décimo por token.
Minha posição é que o empate é o dado menos interessante do lançamento. O que pesa é o custo: pelos gráficos da própria OpenAI, uma tarefa de agente sai por cerca de 29 centavos de dólar. Ao mesmo tempo, o Terra é vendido como modelo de uso de computador e continua atrás dos irmãos maiores e da concorrência justamente nos testes de uso de computador e de terminal. As duas coisas são verdade juntas. O Terra é um PF: chega rápido, custa pouco e resolve o almoço de terça. Ninguém pede PF em jantar de noivado, e ninguém deveria deixar o Terra sozinho com a tarefa mais difícil do backlog.
O preço não precisa de gráfico
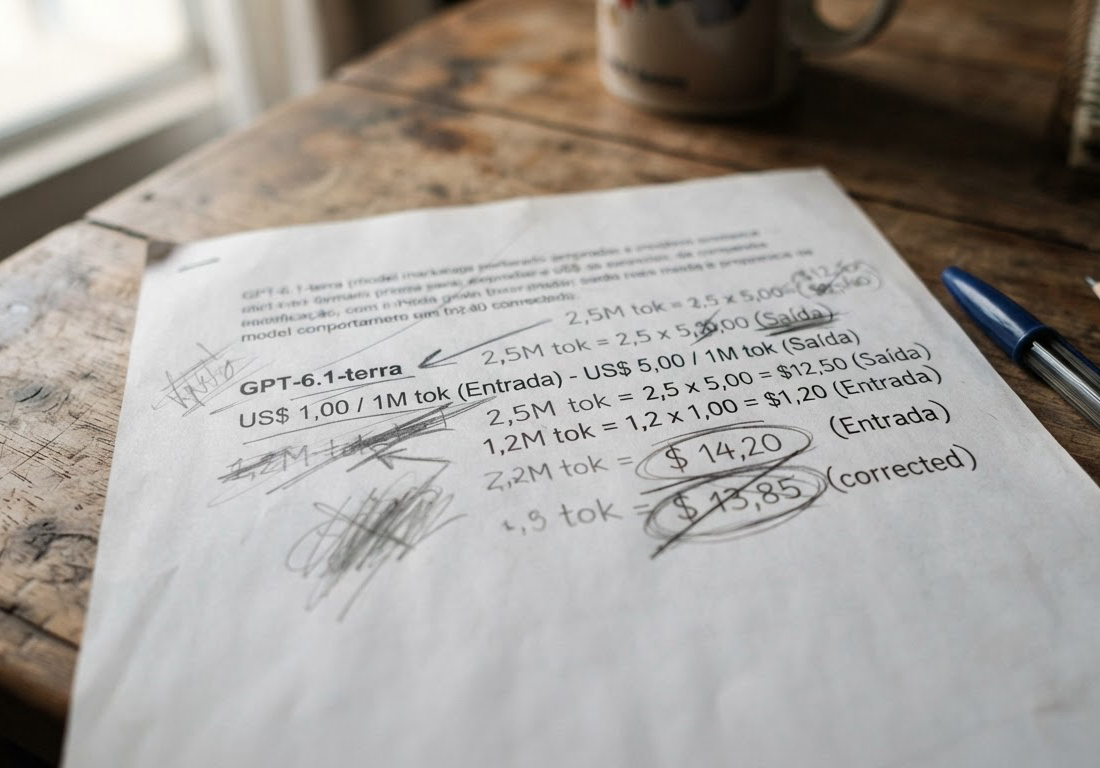
Comecemos pelo que é firme. A página do modelo na API lista o gpt-6.1-terra a US$ 1,00 por milhão de tokens de entrada, US$ 0,05 na entrada em cache e US$ 5,00 na saída. A manchete que circulou fala em "metade do preço do GPT-6.1 Sol", enquanto o resumo compara com o Astra. A confusão se desfaz com aritmética, porque as duas comparações estão certas:
| Modelo | Entrada (US$/M) | Entrada em cache (US$/M) | Saída (US$/M) |
|---|---|---|---|
| GPT-6.1 Terra | 1,00 | 0,05 | 5,00 |
| GPT-6.1 Sol | 2,00 | 0,10 | 10,00 |
| GPT-6 Astra | 10,00 | 1,00 | 50,00 |
Os preços do Sol e do Astra vêm do post de lançamento do Sol, de 22 de setembro. Naquele texto, a OpenAI já vendia o Sol como quase tão bom quanto o Astra por um quinto do preço. O Terra repete a manobra um degrau abaixo. Segundo o anúncio, ele também custa 50% menos que o antecessor direto, o GPT-5.6 Terra. Na prática, a OpenAI está ocupando cada andar do prédio com um modelo que promete o andar de cima pela metade do aluguel.
O empate que cabe numa vírgula
A própria empresa resumiu a promessa assim:
O GPT-6.1 Terra supera substancialmente o GPT-5.6 Terra no Agents' Last Exam, um teste de quão bem agentes usam software no trabalho. Ele chega a igualar o GPT-6 Astra a um décimo do preço por token e termina tarefas, em média, mais de 3× mais rápido que o Astra e o GPT-6.1 Sol.
Os valores por tarefa não aparecem no texto do anúncio. Quem os tirou dos gráficos de lançamento foi a MarkTechPost (abre em nova aba), e o próprio veículo avisa que se trata de números autodeclarados, não de confirmação independente. Feita a ressalva, a leitura é esta:
| Modelo | Esforço | Agents' Last Exam v1 | Custo por tarefa |
|---|---|---|---|
| GPT-6.1 Terra | médio | 57,6% | US$ 0,29 |
| GPT-5.6 Terra | médio | 42,6% | US$ 0,84 |
| GPT-6 Astra | médio | 57,6% | US$ 4,82 |
| GPT-6.1 Terra | máximo | 60,0% | US$ 1,01 |
| Claude Opus 5.5 | máximo | 63,2% | US$ 8,82 |
Vale olhar a razão entre os números. Por token, o Terra é dez vezes mais barato que o Astra. Por tarefa, a diferença lida no gráfico passa de 16 vezes. Isso sugere que o Terra também gasta menos tokens para chegar ao mesmo resultado, o que bate com a alegação da OpenAI de que, no esforço máximo, ele é mais de três vezes mais eficiente em tokens que o Claude Opus 5.5, da Anthropic (abre em nova aba). Contra o Opus, ele perde 3,2 pontos e custa quase nove vezes menos por tarefa.
Tem um detalhe que joga a favor da OpenAI e que merece crédito. O empate acontece em esforço médio, que é o padrão da API, e não numa configuração de laboratório que ninguém usa. O detalhe contrário merece o mesmo peso: é um benchmark, na versão 1, com números da própria fabricante e sem replicação externa conhecida. Empatar em um teste é empatar em um teste.
Onde a régua sobe, o Terra fica
Os outros gráficos do lançamento são menos generosos, e é neles que estão os limites reais. No OSWorld 2.1 offline, o teste mais próximo do que se entende por "usar um computador", o Terra marca 66,7% em esforço médio e 74,2% no máximo. O Sol faz 78,0%, o Astra 80,9% e o Claude Sonnet 5.5 chega a 83,9%. O modelo anunciado para uso de computador fica quase dez pontos atrás do concorrente justamente em uso de computador. No Terminal-Bench 4.0, o Terra salta de 21,5% (o resultado publicado do GPT-5.6 Terra) para 50,3%, o que é um avanço enorme. Mesmo assim, fica atrás do Sol (55,9%), do Astra (58,2%) e, com folga de 20 pontos, do Sonnet 5.5 (70,6%). A OpenAI admite no anúncio que Sol e Astra continuam melhores para a programação mais complexa. Em visão, a distância encolhe: 85,5% no MMMU-Pro contra 86,3% do Sol e 86,7% do Astra.
A taxa de erro conta a mesma história com mais nuance. Num conjunto interno de prompts feitos para induzir erro, a OpenAI diz que o Terra caiu de 53,6% para 16,7% em esforço baixo e chegou a 4,3% no máximo. É um ganho real. Mas, no esforço baixo, um em cada seis casos ainda dá errado, e isso é muito para quem vai preencher formulário fiscal em lote. O parâmetro reasoning.effort aceita none, low, medium, high, xhigh e max, e não está ali de enfeite: é a alavanca que troca dinheiro por confiabilidade. A pergunta útil para cada fluxo é em que nível o erro fica tolerável e quanto custa chegar lá.
As letras miúdas da fatura
A janela de contexto é de 1.050.000 tokens, com até 922 mil de entrada e 128 mil de saída. A conta muda bem antes disso. Prompts acima de 272 mil tokens de entrada pagam o dobro na entrada e no cache e 1,5 vez na saída, e o acréscimo vale para a requisição inteira, não só para o excedente. Sessões longas de agente, que acumulam histórico e capturas de tela, tendem a atravessar essa linha sem pedir licença. Quem não gerenciar o contexto vai descobrir o limite pelo boleto.
O resto da tabela é previsível:
- Batch e Flex custam metade do Standard.
- O modo Fast custa o dobro.
- Processamento regional, onde existir, cobra 10% a mais.
- Escrita em cache sai a US$ 1,25 por milhão com retenção de 30 minutos e a US$ 2,50 com retenção de 12 horas.
Há outras restrições que valem anotação:
- Entrada e saída: o modelo recebe texto e imagem e devolve só texto, sem suporte a áudio ou vídeo. Curiosamente, o anúncio cita edição de vídeo como caso de uso. Ao que tudo indica, isso acontece pela interface do software, tela a tela, e não pela leitura do vídeo em si.
- Fine-tuning: não há.
- Corte de conhecimento: 1º de junho de 2026.
- Limites de taxa: o tier gratuito não tem acesso. O tier Build fica em 5.000 requisições e 1 milhão de tokens por minuto.
- Brasil: a cobrança é em dólar, e nenhum dos números divulgados traz recorte em português. Quem for automatizar ERP localizado, portal de prefeitura ou sistema bancário com interface em português vai precisar montar o próprio conjunto de testes.
Na segurança, o adendo ao system card informa que a OpenAI trata o Terra como Critical em cibersegurança e High em capacidade biológica e química, com a mesma pilha de salvaguardas do Sol e do Astra. O limiar crítico de cibersegurança, portanto, deixou de ser exclusividade do topo de linha e chegou ao modelo de volume. Quem trabalha com segurança deve esperar os mesmos freios dos irmãos caros. O mesmo documento afirma que o Terra erra menos fatos que o GPT-6 Sol e fica no nível do GPT-6.1 Sol.
O melhor argumento contra
O contraponto mais sério é este: em trabalho de agente, o erro se acumula. Um modelo que falha mais no OSWorld pode custar mais caro no fim, porque cada falha vira nova tentativa, revisão humana ou estrago silencioso num sistema de produção. O custo por tarefa do benchmark não inclui o custo do erro. Por esse raciocínio, pagar US$ 4,82 por uma tarefa que dá certo pode sair mais barato que pagar US$ 0,29 por uma que precisa ser refeita e auditada.
O argumento está certo, com uma condição. Ele vence sempre que o fluxo não tem um jeito barato de saber se a tarefa deu errado. Quando existe verificação automática, como um teste que passa ou não, um formulário validado contra regra ou um diff conferido, a diferença de preço compra margem para tentar de novo, escalar para o Sol ou o Astra só nos casos que falharam e ainda sobra troco. Sem verificação, o Terra é uma economia que pode virar prejuízo. Com verificação, ele é o padrão óbvio.
Conclusão
O GPT-6.1 Terra não é o novo teto dos agentes da OpenAI. É o novo piso, e um piso desse nível muda a conta de quem roda automação em volume. A recomendação é tratá-lo como modelo padrão para trabalho repetitivo e verificável, mantendo Sol, Astra ou Claude para o que é longo, ambíguo ou caro de errar. O empate com o Astra é a parte que vai circular nas manchetes. O que deve orientar a decisão é o custo por tarefa medido na sua própria carga, junto com os dez pontos de distância no OSWorld.